Claude Code 세션은 왜 시작부터 무거웠나?
CLAUDE.md 길이를 규칙대로 관리했는데도 Claude Code 세션이 무거웠던 이유는, 세션 시작 때 자동으로 실리는 것이 CLAUDE.md 하나가 아니었기 때문입니다. 2026년 9월 1일에 실제로 세어 보니 AI가 작업 지시를 받기도 전에 149,842자를 읽고 들어가고 있었습니다. 이 글은 그 숫자를 발견하고, 처음 짚은 범인이 틀렸다는 것을 확인하고, 진짜 원인을 고치기까지의 과정입니다.
증상 자체는 조용했습니다. 에러가 나지도 않았고 AI가 멈추지도 않았습니다. 다만 AI 코딩 도구에서 컨텍스트, 즉 AI가 한 번에 붙들고 있는 글의 양은 공짜가 아닙니다. 지시문이 길어질수록 AI가 그 안의 규칙을 덜 지킨다는 연구가 있고, 작업을 시작하기 전에 이미 많은 자리가 차 있으면 정작 코드와 대화가 들어갈 자리가 줄어듭니다. 우리 팀은 이 문제를 알고 있었고, 그래서 규칙까지 만들어 두었습니다.
문제는 그 규칙이 지켜지고 있다고 믿었다는 점입니다. 규칙이 있다는 사실과 규칙이 실제로 적용되고 있다는 사실은 다른 이야기였고, 이번 일은 그 차이를 숫자로 확인한 기록입니다.
이미 갖고 있던 규칙: CLAUDE.md는 200줄 이하
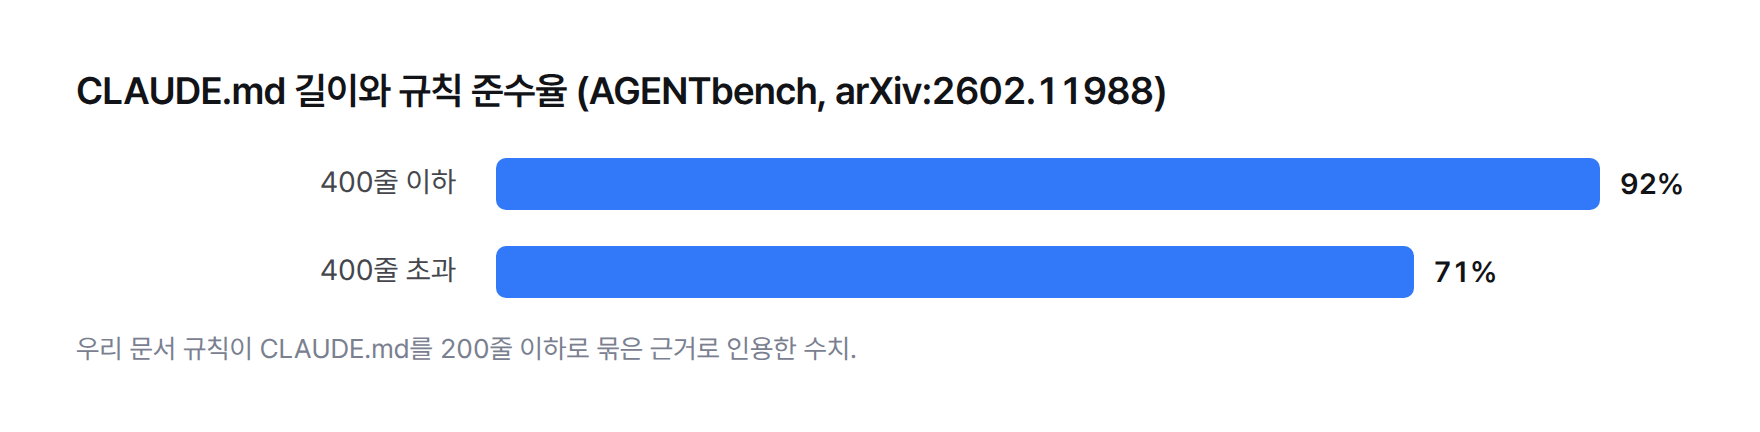
우리 문서 규칙에는 CLAUDE.md를 200줄 이하로 유지하라는 조항이 맨 앞에 있습니다. 규칙 문서는 이 조항을 「BLOCKING」, 곧 어기면 멈춰야 하는 등급으로 적어 두었습니다. 근거로 든 것은 AGENTbench(arXiv:2602.11988)라는 연구입니다. 우리 규칙 문서가 인용한 대로라면, CLAUDE.md가 400줄을 넘으면 AI의 규칙 준수율이 92%에서 71%로 떨어집니다.
그래서 400줄보다 한참 안쪽인 200줄에 선을 그었고, 넘으면 즉시 세부 내용을 별도 규칙 파일(.claude/rules/<이름>.md)로 옮기도록 했습니다. 긴 설정 표, 흐름도 상세, 파라미터 전체 목록, 함수별 설명은 CLAUDE.md에 직접 쓰지 말고 규칙 파일로 보내라는 조항도 함께 있습니다. CLAUDE.md에는 한 줄 요약과 파일 링크만 남기는 구조입니다.
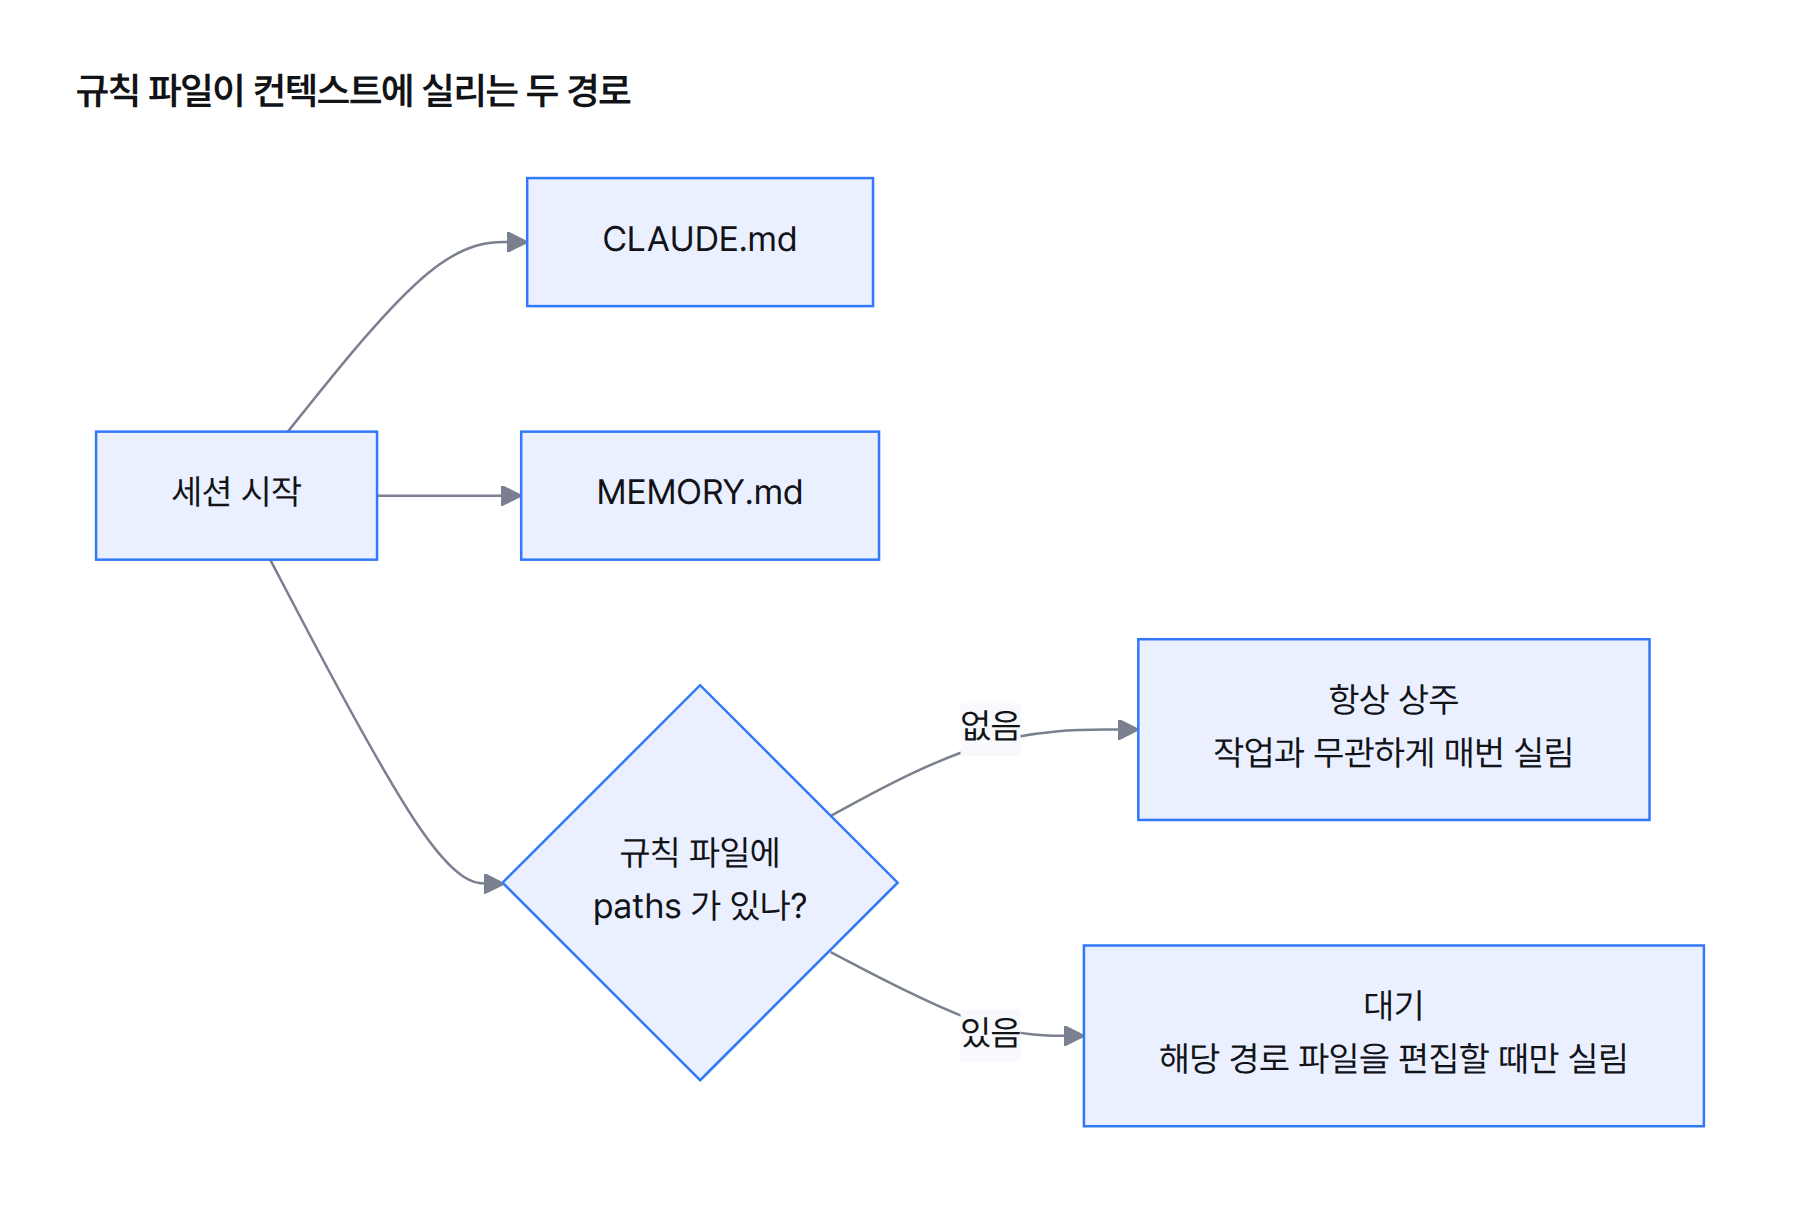
같은 문서에는 규칙 파일 쪽 규율도 있었습니다. 규칙 파일마다 맨 위에 paths 라는 항목을 반드시 적으라는 조항입니다. paths 에 적힌 경로의 파일을 편집할 때만 그 규칙을 불러와 토큰을 아끼는 방식이고, 규칙 파일 하나의 크기는 1~5KB로 두라고 적혀 있습니다. 이 조항이 이번 이야기의 핵심인데, 당시에는 그 사실을 몰랐습니다.
처음 의심한 범인: CLAUDE.md 자체의 길이
계기는 외부 콘텐츠였습니다. 유튜브 채널을 모아 보던 중 Matt Pocock의 「don't use CLAUDE.md」를 읽었고, 같은 잣대를 우리 설정에 대 보기로 했습니다. 제목부터 CLAUDE.md를 겨누고 있었기 때문에, 자연스럽게 우리도 CLAUDE.md를 먼저 의심했습니다.
의심의 논리는 이랬습니다. 컨텍스트가 무겁다면 가장 먼저 실리는 파일이 범인일 가능성이 높다. 우리 CLAUDE.md는 회사 사업 개요, 문서 목록, 명령어, 승인 규칙까지 담고 있어 결코 짧지 않다. 그렇다면 200줄 규칙을 더 세게 적용하거나, CLAUDE.md를 더 쪼개면 해결된다. 규칙 문서가 CLAUDE.md 길이를 가장 앞에 둔 것도 이 생각을 거들었습니다.
돌이켜 보면 이 가설에는 빈틈이 있었습니다. 세션 시작 때 실리는 것이 CLAUDE.md뿐이라는 전제를 확인하지 않은 채 세운 가설이었습니다. 다만 그 빈틈은 재 보기 전까지는 보이지 않았습니다.
무엇으로 확인했나 — 세션 시작 때 항상 실리는 글자 수
확인 방법은 단순했습니다. 「세션을 새로 열었을 때, 작업 내용과 상관없이 항상 AI에게 실리는 파일」을 전부 나열하고, 각각의 글자 수를 셌습니다. 줄 수가 아니라 글자 수로 센 이유는, 규칙 파일마다 줄 길이가 제각각이라 줄 수로는 실제 분량을 비교할 수 없기 때문입니다.
항상 실리는 파일은 세 묶음이었습니다. 첫째는 CLAUDE.md, 둘째는 AI가 세션을 넘어 기억할 내용을 모아 둔 MEMORY.md, 셋째는 paths 항목이 없는 규칙 파일들입니다. 셋째 묶음이 여기 들어가는 이유는 간단합니다. paths 가 있는 규칙은 해당 경로를 건드릴 때만 실리지만, paths 가 없는 규칙은 「언제 불러올지」에 대한 조건이 없어서 매 세션 처음부터 실립니다.
판정 기준으로는 우리가 컨텍스트 관리 규칙에 적어 둔 절대 경고선, 100K 토큰을 썼습니다. 글자와 토큰은 같은 단위가 아니라는 점은 분명히 해 둡니다. 다만 이번 측정의 목적은 정밀한 토큰 계산이 아니라, 어느 묶음이 가장 큰지를 가려내는 것이었습니다.
CLAUDE.md는 왜 범인이 아니었나?
결과는 가설을 뒤집었습니다. CLAUDE.md는 20,660자였습니다. MEMORY.md는 23,166자로 오히려 CLAUDE.md보다 컸습니다. 그리고 paths 가 없는 규칙 파일 9개가 합쳐서 106,016자였습니다. 세 묶음을 더하면 149,842자입니다.
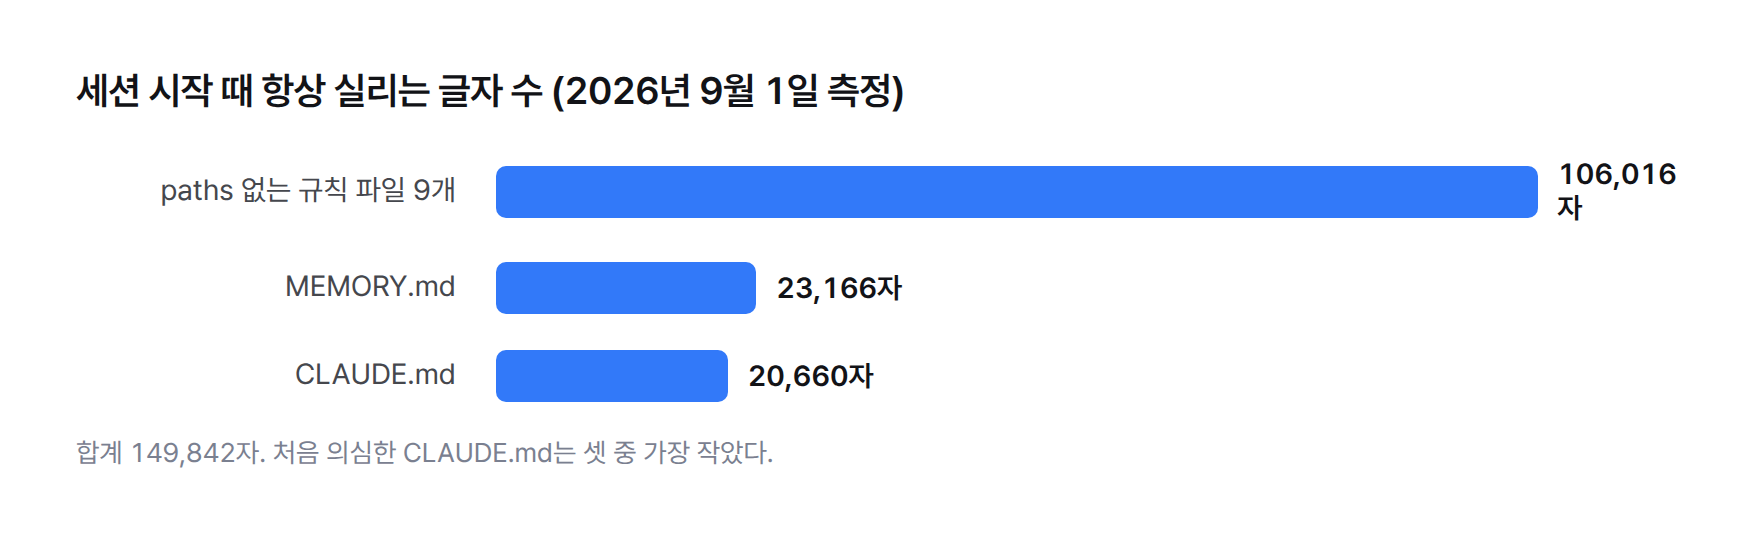
처음 의심한 CLAUDE.md는 세 묶음 가운데 가장 작았습니다. CLAUDE.md를 절반으로 줄인다 해도 전체 분량은 크게 달라지지 않는 구조였습니다. 200줄 규칙을 더 세게 적용하자는 처음 계획은 맞는 방향이 아니었고, 가설은 여기서 반증됐습니다.
동시에 더 불편한 사실도 드러났습니다. 149,842자는 우리가 스스로 정한 100K 토큰 경고선을 작업을 시작하기도 전에 넘기는 분량이라고 판단했습니다. 경고선은 긴 작업 도중에 조심하라고 그어 둔 선인데, 세션을 여는 순간 이미 그 선 밖에 서 있었던 셈입니다.
진짜 원인: paths 가 빠진 규칙 파일 9개
가장 큰 묶음이 규칙 파일임을 확인한 뒤, 왜 그 파일들에 paths 가 없는지 살폈습니다. 확인해 보니 가장 큰 규칙 파일 8개에는 paths 뿐 아니라 frontmatter, 즉 파일 맨 위에 설정을 적는 머리말 자체가 아예 없었습니다. 로딩 조건을 적을 자리조차 없었습니다.
이 부분이 이번 일에서 가장 뼈아팠습니다. 우리 문서 규칙은 규칙 파일에 paths 를 「필수」로 정해 두고 있었습니다. 규칙은 분명히 있었는데, 그 규칙이 정작 규칙 파일들 자신에게는 걸려 있지 않았습니다. CLAUDE.md 길이는 눈에 잘 띄는 한 파일이라 관리가 됐지만, 규칙 파일은 하나씩 새로 만들어질 때마다 머리말 없이 쌓였고, 아무도 세지 않았습니다.
규칙 문서에는 1~5KB라는 파일 크기 기준도 있었습니다. 그런데 paths 가 없는 9개가 106,016자였으니, 이 파일들은 크기 기준에서도 벗어나 있었다고 봐야 합니다. 크기 기준과 로딩 기준, 두 규율이 같은 자리에서 동시에 비어 있었습니다.
훅이 이미 강제하는 규칙을 왜 또 읽혔나?
더 나쁜 사실이 하나 더 있었습니다. 상주하던 규칙 파일 중 다수는 이미 훅으로 강제되고 있었습니다. 예를 들어 한국어 번역체를 막는 규칙은 파일을 쓸 때마다 번역체 검사 훅이 돌며 걸러 냈고, 작업 지시가 모호할 때 점검하는 규칙과 업무·개인 채널을 분리하는 규칙도 각각 전용 검사 스크립트가 있었습니다.
훅은 결정론적입니다. 조건이 맞으면 반드시 돌고, AI가 규칙을 기억하든 말든 결과가 같습니다. 반면 규칙 파일은 AI가 읽고 따르기를 기대하는 확률적 지시입니다. 우리는 확률적 지시를 확실한 장치로 옮겨 놓고도, 원래의 긴 전문을 매 세션 컨텍스트에 그대로 남겨 두고 있었습니다. 같은 규칙에 두 번 값을 치르고 있었던 셈입니다.
이런 중복은 번역체 검사처럼 특정 파일을 쓸 때만 필요한 규칙에서 특히 낭비가 큽니다. 한국어 문서를 쓰지 않는 세션에서도 번역체 규칙 전문이 처음부터 자리를 차지하고 있었기 때문입니다. 비슷한 구조의 비용 문제는 LLM 비용 절감, 토큰 427K를 104K로 줄인 기록에서도 다룬 적이 있습니다.
고친 방법: 내용은 그대로, 로딩 조건만 붙였다
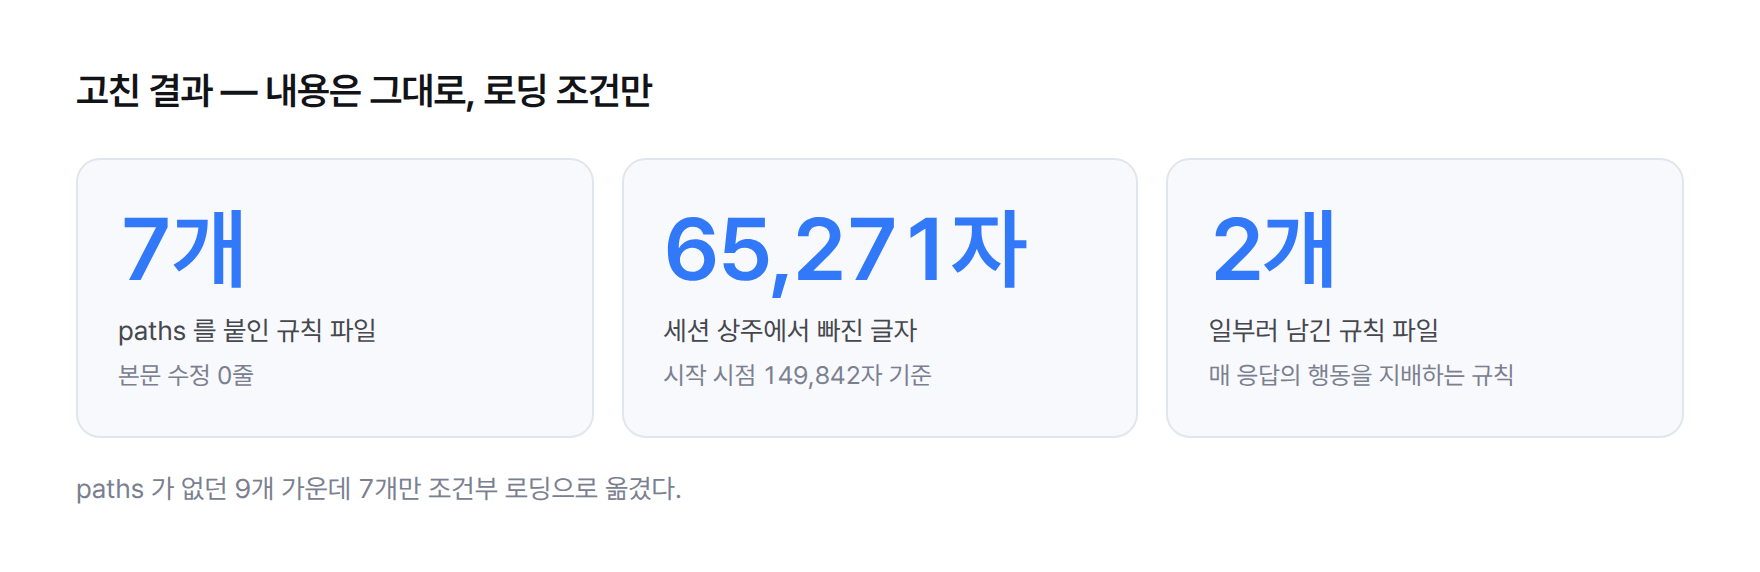
고치는 방식은 의도적으로 좁게 잡았습니다. paths 가 없던 9개 중 7개에 paths 를 붙였고, 규칙의 본문은 한 줄도 고치지 않았습니다. 바뀐 것은 「이 규칙을 언제 불러올지」라는 조건뿐입니다. 그 결과 세션 시작 때 항상 실리던 분량에서 65,271자가 빠졌습니다.
본문을 건드리지 않은 데는 이유가 있습니다. 규칙 문서에는 ACE라는 연구를 근거로 든 조항이 있습니다. 프롬프트를 통째로 갈아엎거나 압축과 확장을 반복하면 정보가 빠지고 성능이 유의하게 떨어져서, 현재 프롬프트에 작은 수정만 가하는 쪽이 이겼다는 내용입니다. 이번 문제는 규칙의 내용이 아니라 로딩 조건이었으니, 조건만 고치면 가장 작은 수정으로 끝났습니다.
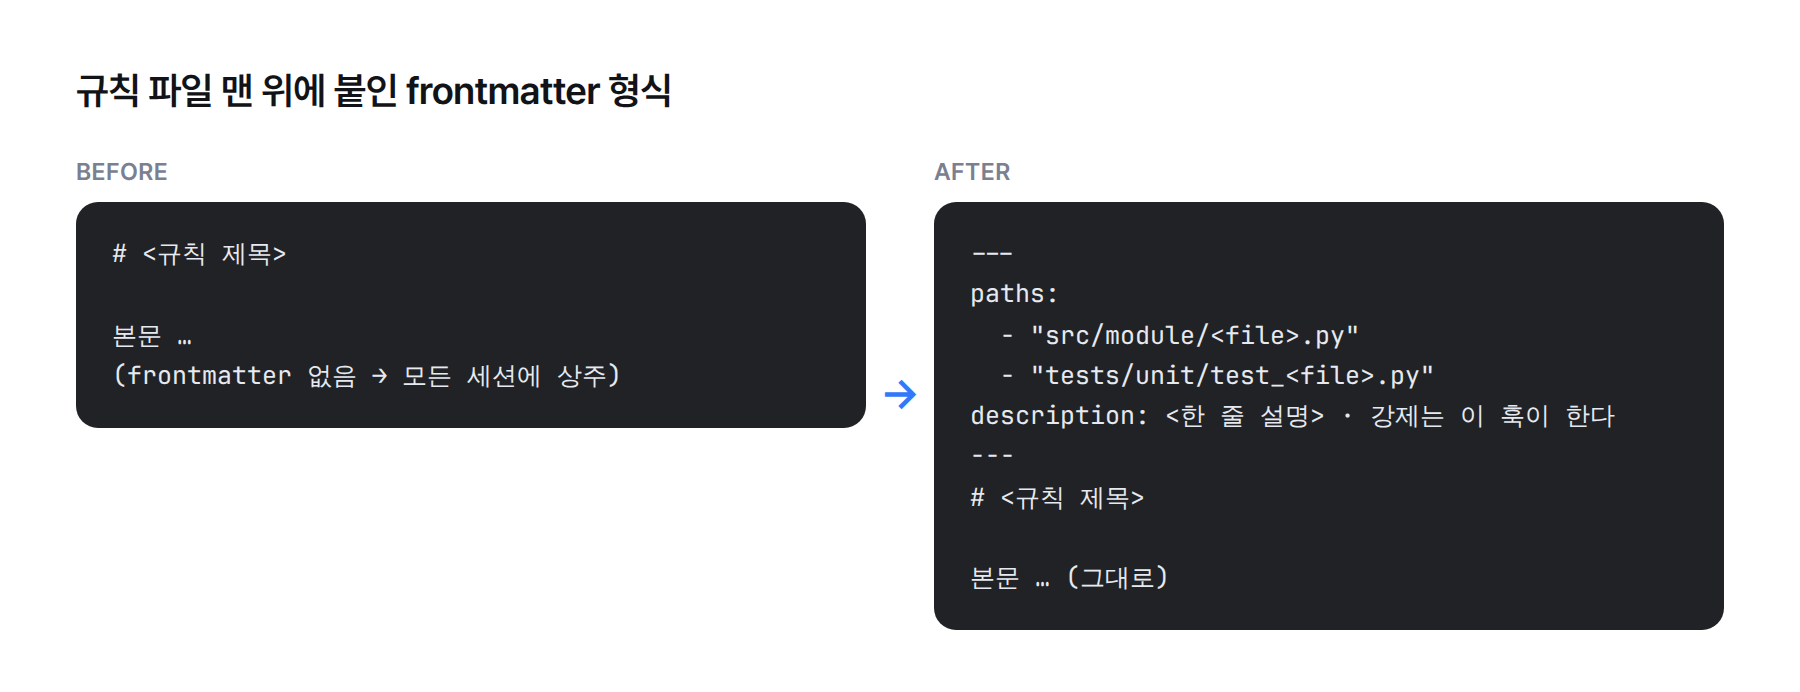
각 규칙 파일의 description 에는 「강제는 이 훅이 한다」라는 문장을 함께 적었습니다. 나중에 누군가, 혹은 다음 세션의 AI가 「이 중요한 규칙이 왜 항상 실리지 않지?」 하고 되돌리려 할 때, 그 이유가 먼저 눈에 들어오게 하려는 장치입니다.
남은 두 파일은 왜 상주시켰나?
paths 가 없던 9개 중 2개는 일부러 그대로 두었습니다. 하나는 AI가 언제 사람에게 승인을 구하고 언제 스스로 진행할지를 정한 규칙이고, 다른 하나는 근거 없는 주장을 사실처럼 말하지 못하게 막는 규칙입니다.
이 둘은 특정 파일을 편집할 때만 필요한 규칙이 아닙니다. AI가 응답 하나를 쓸 때마다 행동을 좌우하고, 우리 팀이 어떤 경우에도 양보하지 않기로 정해 둔 규칙입니다. paths 로 묶으면 정작 필요한 순간에 실리지 않을 수 있으니, 비용을 치르더라도 상주가 맞다고 판단했습니다.
정리하면 기준은 하나였습니다. 「특정 경로를 건드릴 때만 필요한가, 매 응답마다 필요한가」. 앞쪽이면 paths 로 묶고, 뒤쪽이면 상주시킵니다. 훅이 이미 강제하는 규칙은 앞쪽으로 분류하기가 더 쉽습니다.
같은 실수를 막는 장치
이번 일에서 가장 크게 배운 점은 「규칙이 있다」와 「규칙이 적용되고 있다」가 다르다는 점입니다. 그래서 재발 방지는 규칙을 더 쓰는 쪽이 아니라, 새로 생기는 파일이 처음부터 규칙을 지키게 만드는 쪽으로 잡았습니다.
- 새 규칙 파일을 만들 때 paths 는 선택이 아니다 — 없으면 그 파일은 모든 세션에 영구 상주한다고 문서 결정 이력에 못박았다
- CLAUDE.md 하나가 아니라 「세션 시작 때 항상 실리는 것 전체」를 글자 수로 센다 — CLAUDE.md, MEMORY.md, paths 없는 규칙 파일 세 묶음
- 훅으로 이미 강제하는 규칙은 description 에 그 훅 이름을 적고 paths 로 묶는다 — 같은 규칙에 두 번 값을 치르지 않는다
- 규칙 파일을 개편하며 규율을 지울 때는 결정 이력에 사유를 한 줄 남긴다 — 사유 없이 사라진 줄은 다음 세션이 「원래 없던 규율」로 읽는다
- 전면 재작성보다 국소 수정을 기본으로 한다 — 전면 재작성은 구조가 실제로 틀렸을 때만
PR 체크리스트에도 같은 항목이 있습니다. CLAUDE.md를 바꿀 때 200줄 미만을 유지할 것, 새 시스템을 추가하면 규칙 파일을 따로 만들 것, frontmatter 의 paths 를 정확히 적을 것. 이번에는 이 체크리스트가 CLAUDE.md에는 적용되고 규칙 파일 자신에게는 적용되지 않은 데서 문제가 생겼으니, 체크리스트를 읽는 쪽이 사람이든 AI든 규칙 파일을 만들 때마다 세 번째 항목을 확인하도록 했습니다.
CLAUDE.md 길이를 관리하는 팀은 무엇부터 확인해야 하나?
CLAUDE.md 길이를 관리하고 있다면, 그다음에 살필 곳은 CLAUDE.md 바깥입니다. 우리 경우 CLAUDE.md는 20,660자였지만 세션 시작 때 실리는 전체는 149,842자였고, 가장 큰 몫은 로딩 조건 없이 쌓인 규칙 파일 9개였습니다. 한 파일의 줄 수만 보면 이 차이는 보이지 않습니다.
점검 순서는 세 단계로 충분합니다. 먼저 세션을 열었을 때 작업과 상관없이 항상 실리는 파일을 전부 나열합니다. 다음으로 각각의 글자 수를 세어 가장 큰 묶음을 찾습니다. 마지막으로 그 묶음 안에서 특정 파일을 편집할 때만 필요한 규칙을 골라 로딩 조건을 붙입니다. 이때 본문은 건드리지 않는 편이 안전합니다.
우리 팀은 이렇게 AI 에이전트가 일하는 방식 자체를 측정하고 고치는 작업을 홈페이지 제작, 업무 자동화 구축에 그대로 씁니다. 사내에 Claude Code 같은 AI 코딩 도구를 도입했는데 규칙이 잘 지켜지지 않는다면 상담으로 상황을 알려 주세요.