코드 라인 수로 성장을 재면 무엇이 문제인가
코드 라인 수로 개발 자산이 얼마나 늘었는지 재는 계산은 단순하다. 두 시점에 줄 수를 세고, 나중 값에서 앞선 값을 빼면 끝난다. 다만 이 뺄셈에는 전제가 하나 숨어 있다. 두 값을 같은 방법으로 셌어야 한다.
SGK 스튜디오가 이 숫자를 세기 시작한 이유는 체감을 기록으로 바꾸고 싶어서였다. 개발자 한 명이 저장소 수십 곳과 AI 작업 도구를 함께 굴리면 일이 늘었다는 느낌은 매일 들지만, 무엇이 얼마나 늘었는지 말하라면 막힌다. 자동화 전에 소요 시간부터 기록하고 그 값을 기준으로 개선 폭을 판단한다는 원칙을, 자산 규모를 셀 때도 똑같이 쓰기로 했다.
뺄셈이 틀리면 대가는 숫자가 밖으로 나갈 때 치른다. 소개서나 제안서에 코드가 몇 줄 늘었다고 적는 순간, 그 숫자가 우리 작업을 대신 설명한다. 세는 방법이 중간에 바뀐 줄 모르고 빼면 방법 차이가 만든 증감까지 작업량처럼 보이고, 누군가 같은 방법으로 다시 세어 보면 곧바로 드러나는 부풀림이 남는다.
이 글은 2026년 8월 21일에 잡은 기준선과 9월 15일 재측정을 나란히 놓고, 어떤 숫자를 비교했고 어떤 숫자를 비교에서 뺐는지, 그 판단의 근거를 적은 기록이다. 결론부터 말하면 코드 줄 수는 비교에서 뺐다. 커밋 수와 자산 개수는 비교하되, 그 숫자가 말하지 못하는 부분을 옆에 함께 적기로 했다.
처음 잰 숫자 — 2026년 8월 21일 기준선과 9월 15일 재측정
기준선 스냅샷은 2026년 8월 21일에 찍었다. 세는 대상은 네 묶음이다. 개인 저장소 전체의 규모(저장소 수·커밋 수·코드 줄 수), 기준선 이후 새로 만든 저장소, 커밋이 늘어난 저장소, 그리고 AI 작업 자산 여섯 종류의 개수다.
9월 15일에 같은 대상을 다시 셌다. 개인 저장소는 42개에서 45개로 3개 늘었다. 커밋은 사람이 한 작업만 세어 4,612건에서 5,918건으로 1,306건 늘었다. 코드는 1,143,445줄이었다.
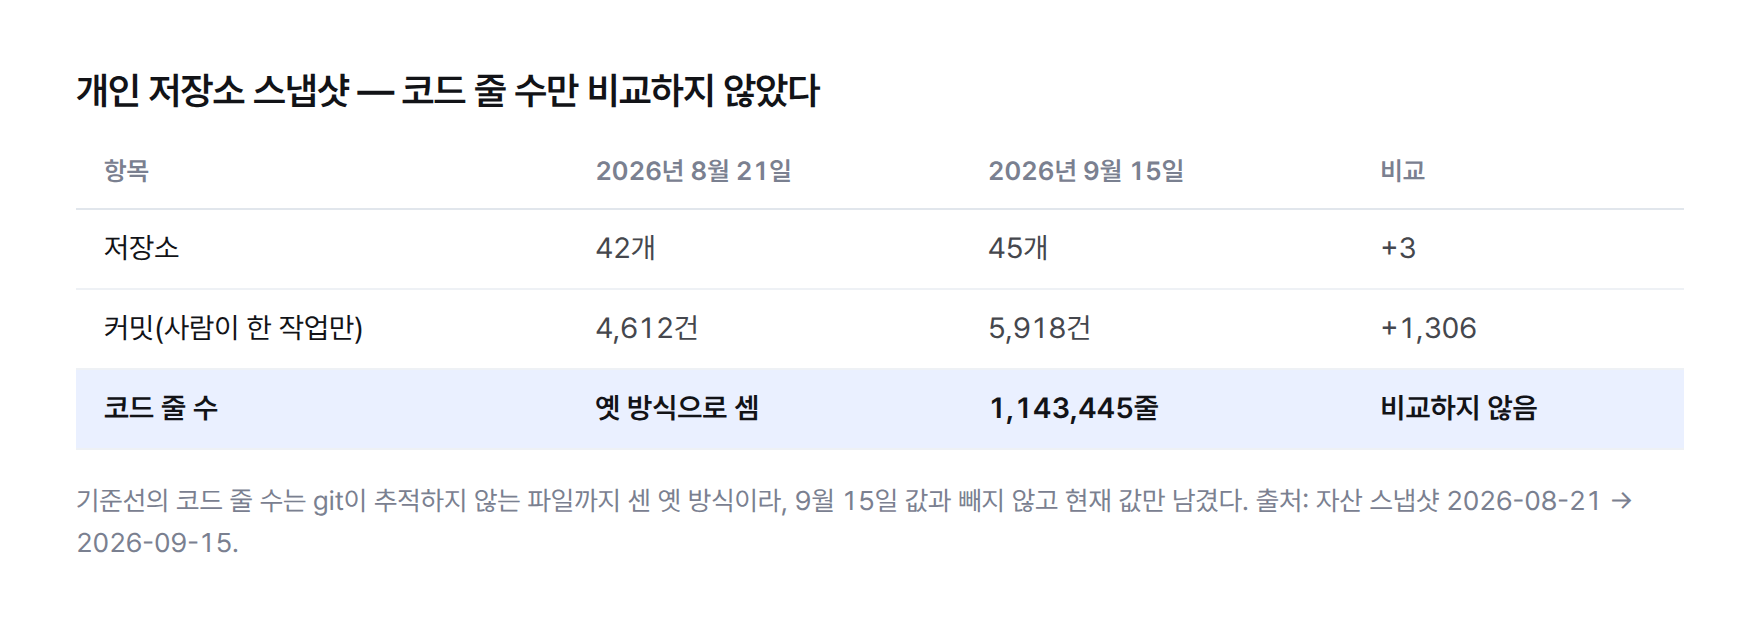
커밋을 사람이 한 작업으로 한정한 까닭은 자동화가 저장소에 남기는 커밋과 섞지 않기 위해서다. 정해진 시각마다 도는 작업이 스스로 커밋을 남기면, 커밋 수는 사람이 한 일이 아니라 기계가 돈 횟수를 따라 오른다. 이 차이를 확인한 과정은 git 커밋 수가 부풀려진 이유에 따로 정리했다.
AI 작업 자산은 기준선에서 스킬 60개, 에이전트 23개, 룰 29개, 훅 22개, 스크립트 210개, 크론 잡 142개였다. 9월 15일 값은 뒤에서 재측정 결과와 함께 다룬다.
위 표에서 코드 줄 수 칸만 비교가 비어 있다. 기준선에도 줄 수는 있었지만 옛 방식으로 센 값이라 여기 옮기지 않았다. 왜 비워 뒀는지가 이 글에서 첫 번째로 무너진 가설과 이어진다.
숫자를 받아 들고 세운 가설 네 가지
전후 표를 받으면 누구나 먼저 떠올리는 읽기 방식이 있다. 우리도 처음에는 그 방식으로 읽었고, 정리하면 가설 네 개가 나온다.
- 가설 1 — 두 스냅샷을 빼면 성장폭이 나온다. 저장소 수, 커밋 수, 코드 줄 수 모두 나중 값에서 앞선 값을 빼면 그 기간에 한 작업의 양이다.
- 가설 2 — 커밋이 1,306건 늘었으니 저장소 전반이 고르게 자랐다.
- 가설 3 — 커밋이 많은 저장소일수록 코드도 크다. 커밋 수만 보고도 저장소 규모를 가늠할 수 있다.
- 가설 4 — 스크립트와 크론 잡이 늘어난 만큼 자동화가 사람 대신 하는 일도 늘었다.
네 가설 모두 그럴듯하다. 스냅샷 표가 애초에 이렇게 읽으라고 만든 모양이기 때문이다. 그래서 가설마다 표 안의 다른 숫자와 맞대어 확인했다. 새 데이터를 모으지 않고, 이미 센 숫자끼리 서로 어긋나는 곳이 있는지만 봤다.
가설은 어디서 틀렸나
가설 1은 코드 줄 수에서 먼저 무너졌다. 기준선의 줄 수는 git이 추적하지 않는 파일까지 센 옛 방식으로 셌고, 9월 15일의 1,143,445줄은 그 방식으로 센 값이 아니다. 추적 밖 파일은 저장소가 버전으로 관리하지 않는 파일이라, 코드를 한 줄도 쓰지 않아도 늘거나 줄 수 있다.
이 상태에서 뺄셈을 하면 결과에 두 가지가 섞인다. 실제로 쓴 코드의 양, 그리고 세는 범위가 달라진 만큼의 차이다. 스냅샷 안에는 둘을 떼어 낼 값이 없다. 줄 수가 늘었는지 줄었는지 그 방향조차 믿을 수 없어서, 코드 줄 수는 이번 구간의 비교에서 통째로 뺐다.
가설 2는 커밋 증가분을 저장소별로 펴자 틀렸다. 목록에 오른 성장 저장소 10곳 가운데 b2b-consulting 한 곳이 1,410건에서 2,234건으로 824건 늘었다. 두 번째인 threads-loop는 187건에서 362건으로 175건, 세 번째인 tradestudio는 255건에서 369건으로 114건이었다. 목록 끝의 sales는 25건에서 32건으로 7건 늘었다.
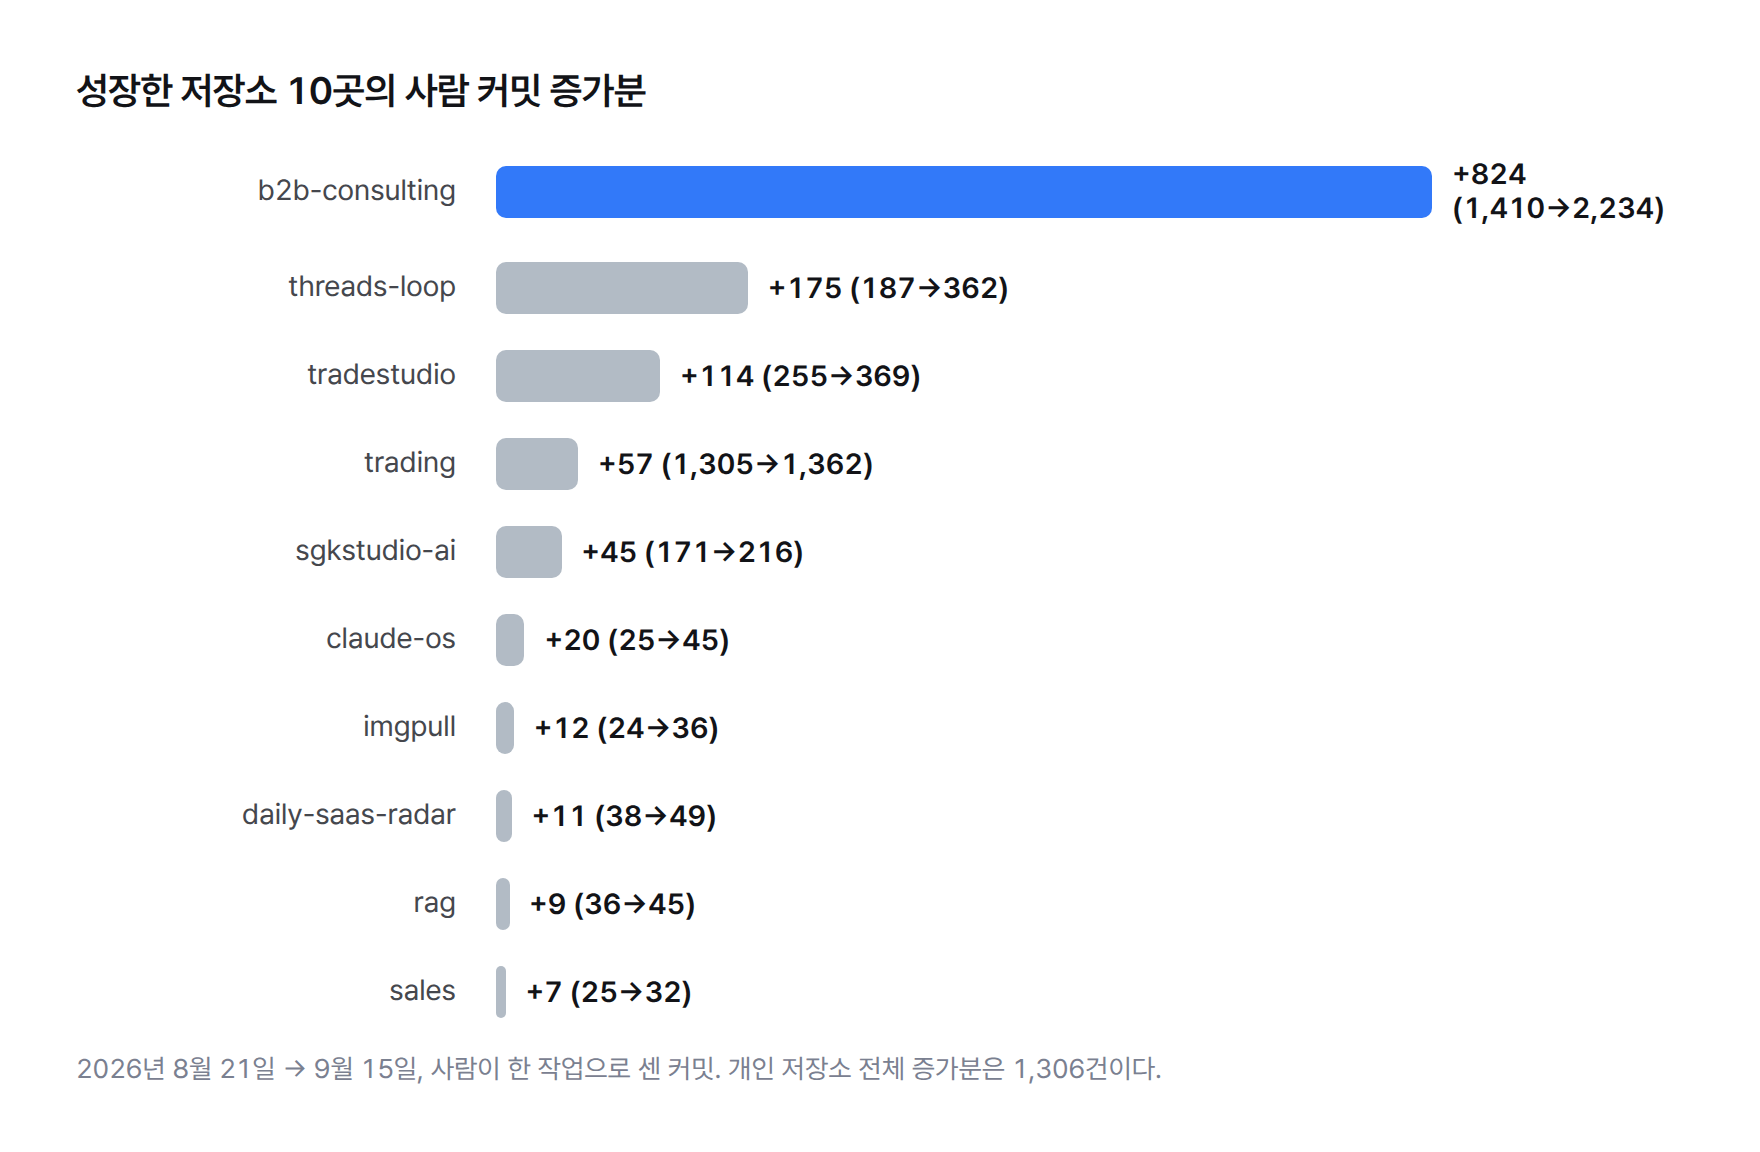
합계 1,306건은 고른 성장처럼 읽히지만, 실제로는 한 저장소의 작업이 대부분을 채웠다. 원래 크기와 증가폭 사이에도 뚜렷한 관계가 없었다. 기준선에서 1,305건이던 trading은 57건 늘었고, 25건이던 claude-os는 20건 늘었다.
가설 3은 새로 만든 저장소 세 곳에서 틀렸다. 세 곳 모두 기준선 날부터 9월 초 사이에 시작해 조건이 비슷한데, 커밋 수 순서와 코드 줄 수 순서가 거꾸로 나왔다.
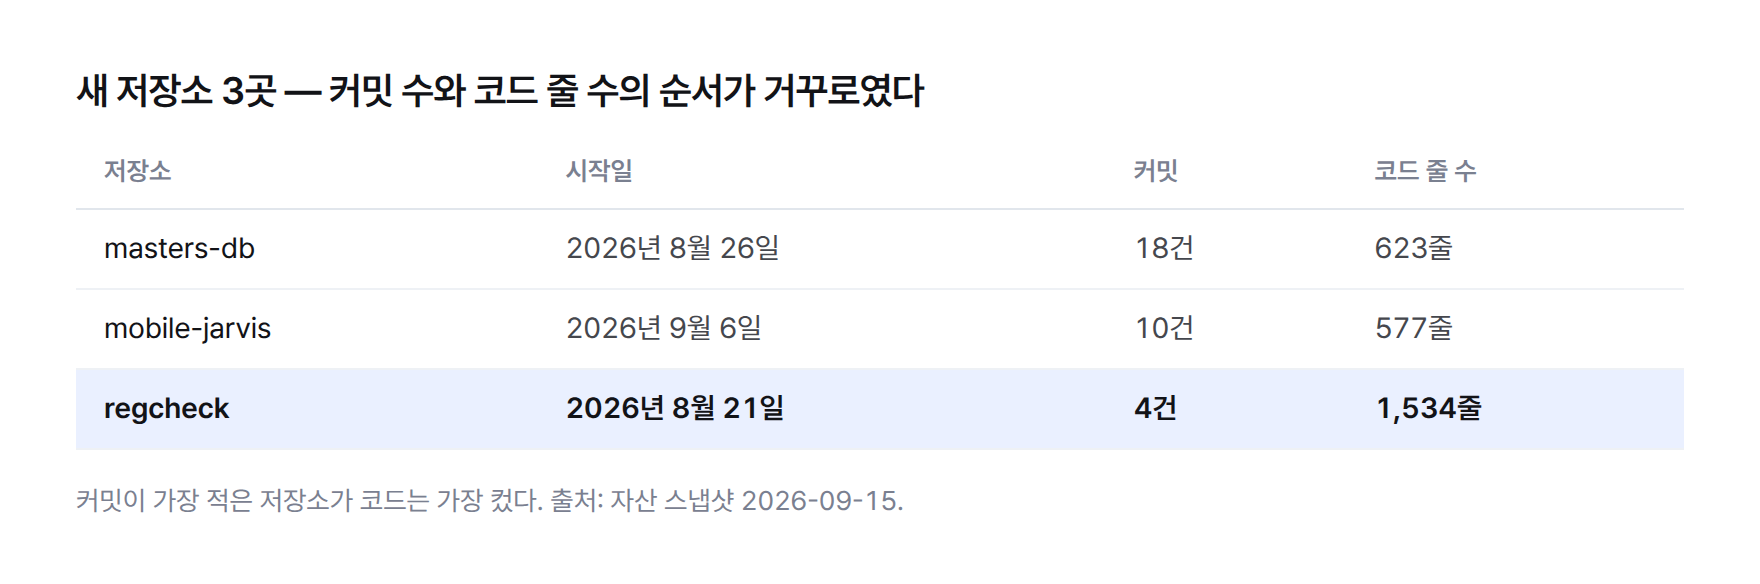
커밋이 가장 많은 masters-db는 18건에 623줄, mobile-jarvis는 10건에 577줄이었다. 커밋이 4건뿐인 regcheck가 1,534줄로 가장 컸다. 커밋 한 건에 담긴 변경의 크기가 저장소마다 달라서, 커밋 수로 규모를 가늠하는 읽기는 이 세 곳에서 성립하지 않았다.
가설 4는 틀렸다기보다 이 스냅샷으로는 확인할 수 없었다. 스크립트 개수와 크론 잡 개수는 파일과 등록 항목이 있다는 사실을 셀 뿐, 그 작업이 실제로 돌았는지, 돌아서 사람 시간을 줄였는지는 담지 않는다. 등록한 크론 잡과 실제 실행 기록이 서로 다른 말을 한 사례는 크론 모니터링 실측 기록에 정리했다.
진짜 원인은 무엇이었나 — 세는 방법이 숫자 옆에 없었다
네 가설이 틀린 자리를 모아 보면, 원인은 숫자 자체보다 숫자를 적고 읽는 방식에 있었다. 크게 세 가지다.
- 세는 방법을 값과 함께 적지 않았다. 코드 줄 수는 방법이 바뀌었는데 표에서는 같은 이름의 칸에 같은 단위로 들어간다. 옆에 방법을 적어 두지 않으면 두 값은 서로 뺄 수 있는 숫자처럼 보인다.
- 합계가 분포를 가렸다. 커밋 1,306건은 여러 저장소의 증가를 더한 값인데, 합계만 보면 824건이 한 곳에서 나왔다는 사실이 사라진다.
- 개수를 결과로 읽었다. 커밋 수, 줄 수, 스크립트 수는 얼마나 만들었는지를 세는 지표다. 무엇이 좋아졌는지는 따로 재야 하는데, 표가 전후 두 칸으로 생기면 증가분을 곧 성과로 읽기 쉽다.
원리로 옮기면 한 문장이다. 숫자가 늘었다는 사실은 센 대상이 늘었다는 뜻일 뿐, 우리가 원하는 변화가 일어났다는 증거가 아니다.
자동 검사를 설계할 때 쓰는 원칙과 모양이 같다. 검사를 통과했다는 결과는 검사한 항목 중 걸린 게 없다는 뜻이지 정답의 증거가 아니다. 검사 목록에 없는 결함은 그대로 통과한다. 스냅샷 표도 마찬가지로, 표에 칸이 없는 정보는 아무리 숫자가 좋아도 알려 주지 않는다.
비교 규칙을 어떻게 바꿨나
고친 곳은 계산이 아니라 표를 만드는 규칙이다. 9월 15일 재측정부터 아래 여섯 가지를 지킨다.
- 세는 방법이 바뀐 항목은 현재 값만 적고 비교하지 않는다. 이유를 같은 줄에 적는다. 코드 칸은 '1,143,445줄, 기준선은 추적 밖 파일까지 센 옛 방식이라 비교하지 않음'으로 남았다.
- 커밋은 사람이 한 작업만 센다.
- 전후 절대값을 둘 다 적고 증가분은 괄호에 넣는다. 증가율만 남기면 42개에서 45개로 는 저장소와 22개에서 39개로 는 훅이 무엇을 얼마나 셌는지 사라진다.
- 합계 아래에 저장소별 증가를 편다. 성장한 저장소는 커밋 증가분이 큰 순서로 10곳을 적는다.
- 새 저장소는 커밋 수, 코드 줄 수, 시작일 세 값을 같이 적는다. 커밋 수 하나로 규모를 짐작하지 않게 막는 장치다.
- 측정 축마다 같은 원리를 구현한 공개 문서를 붙인다. 이번 기록에는 평가 실무, 검증 루프, QA 인프라 문서 세 개가 붙었다.
마지막 항목은 숫자를 세는 규칙이 다른 자동화에서 이미 검증한 원칙과 어긋나지 않는지 대조하려고 넣었다. 세 문서에는 측정 방법 자체를 의심해야 했던 실제 사례가 들어 있다.
QA 인프라 문서의 사례는 임계값이다. 화면이 승인한 모습과 달라졌는지 잡는 시각 검사를 처음 만들 때 차이 허용치를 0.2%로 고정했는데, 실제 화면 노이즈를 재 보니 0.160%였다. 두 값의 차이가 0.04%p라 화면이 조금만 흔들려도 멀쩡한 화면을 결함으로 잡을 판이었다. 오탐 한 번이 검사 인프라의 신뢰를 끝낸다고 보고 노이즈 바닥을 자동으로 재는 단계를 더했다. 같은 검사는 첫 실행에서 라이브 결함 3건을 잡았다.
검증 루프 문서의 사례는 검사기 자체다. 법령 인용을 확인하는 검사기를 만들고 통과해야 할 입력 5건만 돌린 뒤 믿을 만하다고 보고했는데, 일부러 거짓 통과를 찾는 입력을 넣자 4건이 통과했다. `the`·`Act`·`Law`·`Regulations` 같은 일반어가 전부 걸리지 않고 지나갔다. 같은 작업에서 결론이 뒤집힌 7건 가운데 5건은 사람이 되물은 뒤에야 뒤집혔다.
평가 실무 문서의 사례는 채점 방식이다. 정답 사례 모음의 1회 정답률이 5% 이상 떨어지면 배포를 막고, AI 채점기는 단독으로 쓰지 않는다. 문서가 인용한 연구에서 AI 채점과 전문가 판단의 일치율이 64~68%에 머물렀기 때문이다.
코드 칸을 비워 둔 결정도 같은 문서에서 온 원칙을 따른다. QA 인프라 문서는 접근성 결함을 기계로 잡을 수 있는 비율이 57%에 그친다고 적고, 기계가 판단하지 못하는 의미 판단은 검사하지 않을 뿐 아니라 검사한 척도 하지 않는다고 못 박는다. 옛 방식 줄 수와 새 방식 줄 수의 차이를 어림값으로라도 채워 넣으면 재지 않은 값을 잰 척하는 셈이라, 빈칸으로 두고 이유를 적는 쪽을 골랐다.
세 사례가 가리키는 방향은 코드 줄 수 칸과 같다. 값이 이상하거나 너무 좋아 보이면 대상보다 재는 방법부터 확인하고, 방법이 바뀌었으면 비교를 멈춘다.
다시 재니 어떤 숫자가 남았나
규칙을 적용한 9월 15일 재측정에서 비교할 수 있는 개인 자산 숫자는 둘이다. 저장소는 42개에서 45개(+3), 사람이 한 커밋은 4,612건에서 5,918건(+1,306)이다. 코드는 1,143,445줄을 현재 값으로만 남기고, 같은 방식으로 센 값이 하나 더 쌓이는 다음 재측정부터 비교한다.
새 저장소 세 곳은 앞의 표처럼 커밋, 줄 수, 시작일을 함께 남겼다. regcheck는 2026년 8월 21일, masters-db는 8월 26일, mobile-jarvis는 9월 6일에 시작했다. 같은 기준선을 9월 15일보다 앞서 한 번 잰 기록은 개발자 생산성 측정에 있다.
AI 작업 자산 여섯 종류는 모두 늘었지만 늘어난 폭은 크게 달랐다.
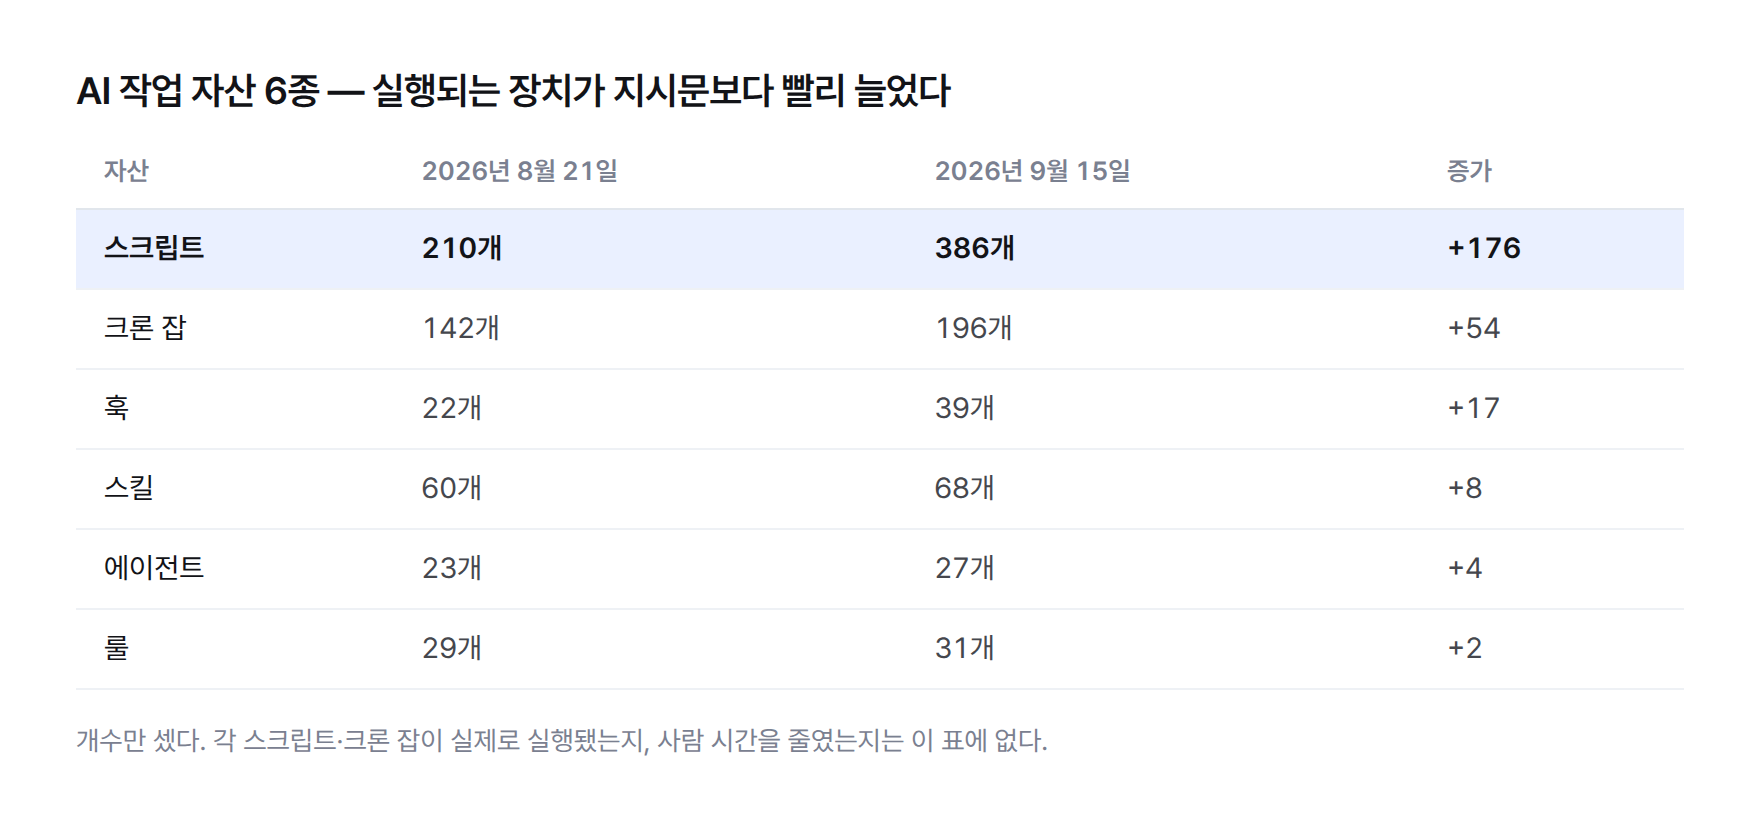
가장 크게 늘어난 항목은 스크립트로, 210개에서 386개로 176개 늘었다. 크론 잡은 142개에서 196개로 54개, 훅은 22개에서 39개로 17개 늘었다. 반면 룰은 29개에서 31개로 2개, 에이전트는 23개에서 27개로 4개, 스킬은 60개에서 68개로 8개였다.
여기서 읽을 수 있는 사실은 한 줄이다. 이 기간에는 일을 시작할 때 읽는 지시문보다, 스스로 실행하는 스크립트와 크론 잡, 작업마다 자동으로 도는 훅이 훨씬 빨리 늘었다. 규칙을 글로 늘리기보다 실행하는 장치로 옮겼다고 해석할 여지는 있지만, 가설 4에서 본 대로 이 표만으로는 그 장치들이 실제로 도는지 알 수 없다.
훅 17개 증가도 같은 한계를 안고 있다. 검증 루프 문서에 따르면 Claude Code 훅은 종료 코드 2를 돌려줘야 작업을 실제로 막고, 종료 코드 1은 기록만 남긴 채 작업을 계속 진행시킨다. 차단하려고 만든 훅이 1을 돌려주면 겉으로는 동작하는 듯 보여도 막는 일은 하나도 하지 않는다. 훅이 22개에서 39개가 됐다는 숫자에는 그중 몇 개가 막는 훅이고 몇 개가 경고만 하는 훅인지가 들어 있지 않다.
자산 개수가 늘었다는 사실로 말할 수 없는 것은 무엇인가
개수 지표가 말하지 못하는 부분은 결과다. 스크립트가 176개 늘었다는 사실에서 사람이 몇 시간을 아꼈는지, 비용이 얼마나 줄었는지는 나오지 않는다. 그 값은 작업마다 따로 전후를 재야 나온다.
결과 지표가 어떤 모양인지는 광고 콘텐츠를 검토하는 LLM 시스템 사례가 잘 보여 준다. 경량 모델이 먼저 분류하는 RAG 라우터를 넣어 광고 콘텐츠에 실제로 걸리는 규칙만 골라 넣게 바꾸자, 입력 토큰이 427K에서 104K로 76% 줄고 총비용이 54% 줄었다. 이 수치는 평가 데이터로 실측했고, 정답 사례 24개의 회귀 감시를 배포 전 확인 단계로 운영한다. 과정은 LLM 비용 절감 기록에 있다.
두 숫자를 나란히 놓으면 차이가 선명하다. 스크립트 개수는 만든 양을 세고, 입력 토큰 427K에서 104K는 바뀐 결과를 센다. 그래서 개수 지표는 결과를 재러 갈 후보 목록으로 쓰고, 밖으로 내보내는 성과 문장에는 결과 지표만 쓰기로 했다.
후보 가운데 무엇부터 잴지도 같은 원칙으로 고른다. 반복 주기와 건당 소요 시간, 오류 비용을 곱해 우선순위를 정하고, 감이 아니라 실측치로 착수 여부를 판단한다. 스크립트가 많이 늘었다면 그중 이 세 값이 큰 작업부터 전후를 잰다.
모든 작업의 결과를 한꺼번에 재지도 않는다. QA 인프라 문서는 활성 프로젝트 13개를 전부 같은 강도로 검수하면 검수 자체가 병목이 된다고 보고, 검사 투자를 생존 증거에 비례하게 나눴다. 신호가 없는 제품은 불변식 검사만 2~3초 안에 돌리고, 방문이나 문의가 생기면 시각 비교를 더해 셋업이 5분 늘고, 매출이 생기면 결제·데이터 흐름 검사를 더해 30분이 더 든다. 결과 지표도 같은 순서로 붙인다. 개수로만 남은 스크립트 가운데 실제로 쓰이는 신호가 확인된 작업부터 전후를 잰다.
지표를 먼저 만들지 않는 원칙도 함께 적용한다. 평가 실무 문서는 자동 평가기를 짜기 전에 실제 실행 기록 20~50개를 사람이 직접 읽고 실패 유형을 먼저 정리하라고 한다. 측정 가능한 것만 재다 진짜 문제를 놓치는 일을 막기 위해서다. 이번 스냅샷에서 코드 줄 수 칸의 문제를 찾은 것도 새 지표가 아니라 이미 센 숫자들을 한 줄씩 대조한 결과였다.
남는 한계
- 코드 줄 수는 이번 구간의 성장폭을 말하지 못한다. 같은 방식으로 센 값이 두 개 모이는 다음 재측정부터 비교할 수 있다.
- 스냅샷이 2026년 8월 21일과 9월 15일 두 장뿐이라, 늘어나는 속도가 일정한지 특정 주에 몰렸는지 모른다.
- 커밋 한 건의 크기가 제각각이다. regcheck처럼 커밋 4건에 1,534줄인 저장소가 있어, 커밋 수는 작업량의 거친 근사에 그친다.
- 성장한 저장소는 목록에 오른 10곳만 적었다. 목록 밖 저장소의 변화는 이 기록에 없다.
- AI 작업 자산은 개수만 있다. 실행 여부와 절감 효과는 작업별로 따로 재야 한다.
코드 라인 수든 커밋 수든, 숫자를 세는 일보다 세는 방법을 숫자 옆에 남기는 일이 먼저다. 방법이 적혀 있지 않은 전후 비교는 계산이 맞아도 결론이 틀릴 수 있다.
개발 자산이나 자동화 효과를 어떤 숫자로 재야 할지 고민하고 있다면 상담에서 사례를 나눌 수 있다.