무엇이 문제였나 — 이미지 원본 하나 받는 데 몇 초씩 걸렸다
이미지 크롤링 속도를 끌어내린 주범은 다운로드가 아니라 요청 사이에 넣어 둔 대기였습니다. 우리가 쓰는 이미지 수집 도구는 사용자가 고른 웹페이지에서 이미지를 찾고, 화면에 보이는 작은 이미지 대신 원본 파일을 찾아 내려받습니다. 갤러리 게시판, 쇼핑몰 상품 피드, 블로그, 텀블러 같은 곳이 대상입니다.
운영자가 이런 말을 남겼습니다. "클릭 대상에서 원본을 찾고 다운로드 하는 속도가 너무 오래 걸리는 것 같은데." 체감으로는 맞는 말이었습니다. 무신사 상품 피드에서 30장을 받으면 장당 3.47초, 텀블러에서는 장당 3.57초가 걸렸습니다. 30장이면 1분 반에서 2분 가까이 기다려야 하는 셈이고, 대상을 여러 개 돌리면 그 시간이 그대로 쌓입니다.
느린 수집 도구를 빠르게 만드는 가장 쉬운 방법은 덜 받는 것입니다. 스크롤을 덜 내리고, 상세 페이지를 덜 열고, 원본 찾기를 덜 시도하면 초는 줄어듭니다. 이 글은 그 쉬운 길을 버리고, 받는 장수와 해상도는 그대로 둔 채 시간만 줄인 과정을 적었습니다. 결론부터 말하면 무신사는 장당 3.47초에서 1.06초로, 텀블러는 3.57초에서 2.22초로 줄었고, 상한 값은 하나도 건드리지 않았습니다.
처음에 무엇을 어떻게 쟀나?
상한 값을 짐작으로 낮추는 일은 개선이 아니라 덜 받기라서, 손대기 전에 구간별 시간부터 쟀습니다. 수집 도구에 `IMGPULL_TIMING=1` 이라는 환경 변수를 켜면 실행 한 번이 어디에 시간을 썼는지 구간별로 나눠 기록합니다. 네트워크 요청에 쓴 시간, 요청 사이에 쉰 시간, 스크롤에 쓴 시간, 원본 찾기(내부에서는 reveal 이라 부르는 단계)에 쓴 시간이 따로 찍힙니다.
측정 조건은 세 가지로 묶었습니다. 첫째, 대상은 6종이고 전부 같은 날 저녁의 같은 코드로 새로 쟀습니다. 예전 기록을 끌어다 쓰지 않았습니다. 둘째, 받는 장수를 `--limit 30` 으로 고정했습니다. 셋째, 판정 기준은 언제나 같은 장수와 같은 해상도에서 걸린 초입니다. 장수가 줄어서 빨라진 결과는 개선으로 치지 않기로 했습니다.
- 측정 스위치 — 환경 변수 `IMGPULL_TIMING=1`, 구간별 시간 분해
- 대상 — 6종, 같은 날 저녁 코드로 모두 새로 측정
- 고정 조건 — 같은 URL, `--limit 30`, 같은 해상도
- 판정 — 장당 초. 받는 장수가 달라진 비교는 버린다
처음 잰 숫자 — 대상 셋, 병목도 셋
6종 가운데 세 곳에서 병목이 뚜렷하게 드러났습니다. 셋 다 모양이 달랐고, 공통점은 하나였습니다. 시간을 먹은 쪽이 이미지를 받는 '일'이 아니었습니다.
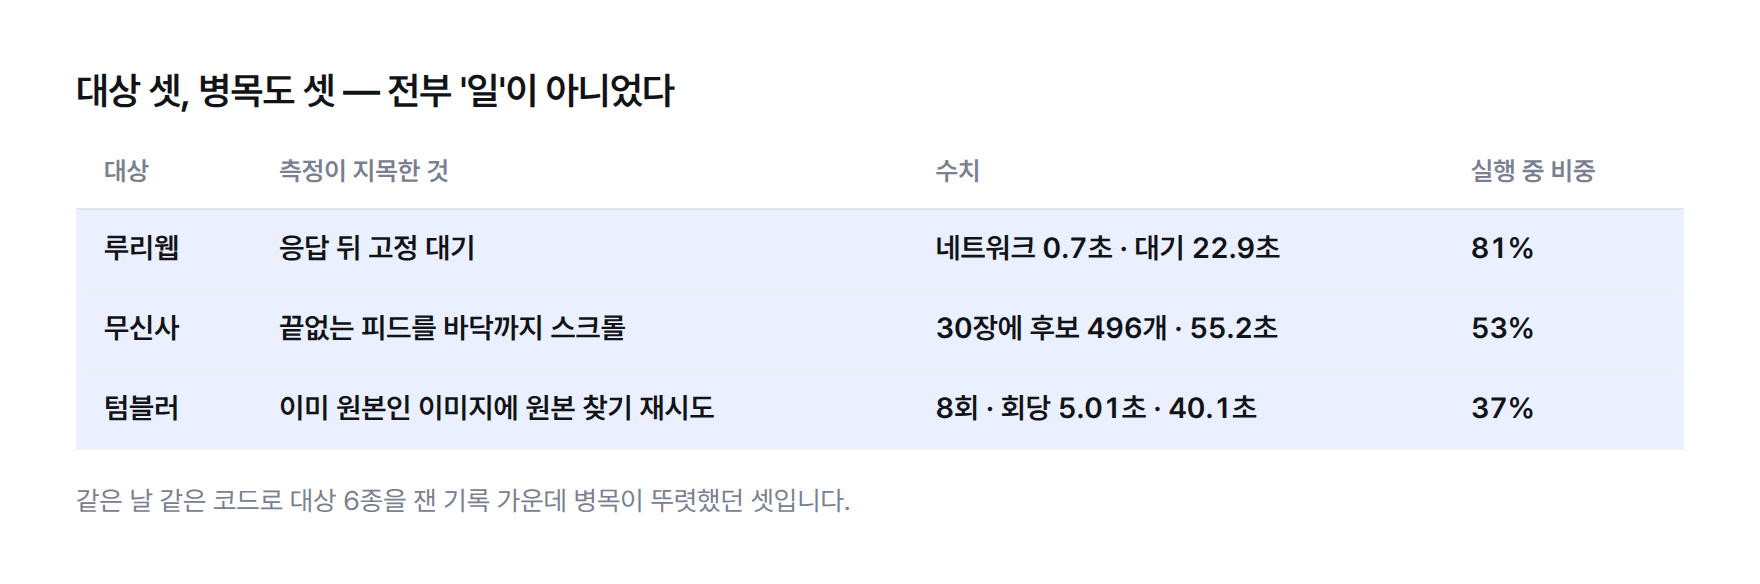
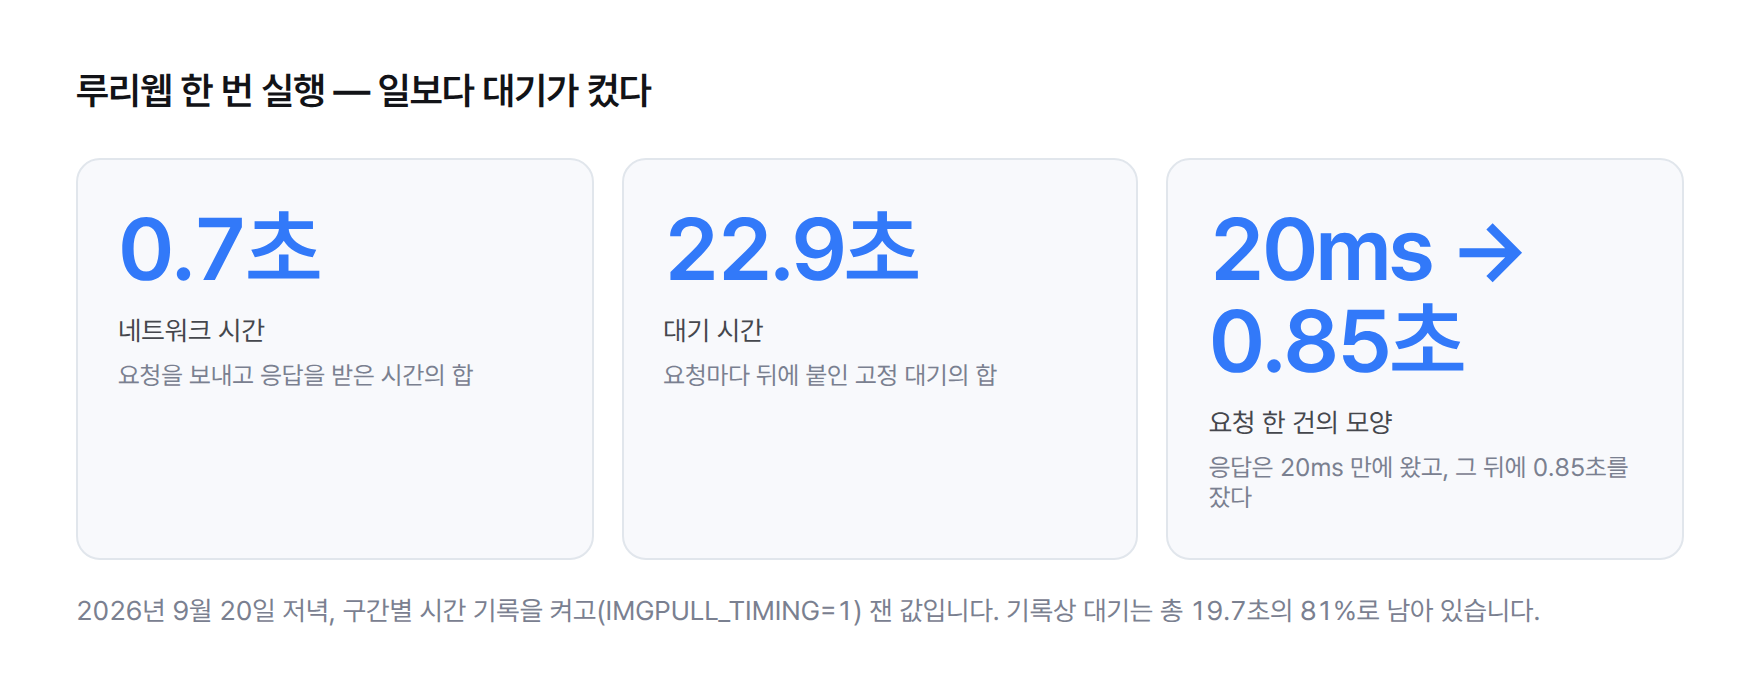
루리웹은 네트워크에 0.7초를 쓰려고 대기에 22.9초를 썼습니다. 기록에는 대기가 실행 총 19.7초의 81%로 남아 있습니다. 요청 한 건이 20ms 만에 응답을 받아도, 그 뒤에 0.85초를 그대로 잤습니다.
무신사는 30장을 받으려고 후보 이미지를 496개 모았습니다. 상품 피드가 끝없이 이어지는 구조라, 도구가 바닥에 닿을 때까지 스크롤을 내렸고 그 스크롤에만 55.2초, 실행의 53%를 썼습니다. 텀블러는 이미 원본을 받은 이미지에 원본 찾기를 8번 더 시도했습니다. 회당 5.01초, 합쳐서 40.1초로 실행의 37%였습니다.
세운 가설 — 원본 찾기와 다운로드가 느리다
측정 전에 떠올린 가설은 운영자의 말과 같았습니다. 원본 주소를 찾아내는 과정과 파일을 내려받는 과정, 즉 일 자체가 무겁다는 가설입니다. 이 가설이 맞다면 손잡이는 분명했습니다. 도구에는 한 번에 여는 상세 페이지 수(`DETAIL_PAGE_CAP`), 원본 찾기 시도 횟수(`REVEAL_CAP`), 스크롤 반복 횟수(`SCROLL_ROUND_CAP`)를 묶어 둔 상한 값이 있고, 세 상한을 낮추면 초는 바로 줄어듭니다.
이 손잡이가 끌리는 이유도 분명했습니다. 상수 세 개를 고치는 일은 몇 분이면 끝나고, 다시 돌리면 숫자가 곧바로 좋아집니다. 문제는 그 숫자가 무엇을 재는지입니다. 상세 페이지를 덜 열면 원본을 못 찾는 이미지가 늘고, 원본 찾기를 덜 시도하면 썸네일이 섞이고, 스크롤을 덜 내리면 30장을 못 채우는 대상이 생깁니다. 초가 줄어든 만큼 결과물의 질이 조용히 떨어지는데, 장당 초만 보면 그 손실이 보이지 않습니다.
또 하나의 자연스러운 선택지는 워커를 늘리는 일이었습니다. 워커는 동시에 요청을 처리하는 작업 단위이고, 당시 도구는 워커 2개로 돌았습니다. 일이 무거우면 일손을 늘리면 된다는 발상이라 누구나 먼저 떠올리는 방향입니다.
두 선택지 모두 이번에 기각했습니다. 이유는 바로 다음 절의 숫자에 있습니다.
가설은 어디서 틀렸나?
루리웹 숫자가 가설을 정면으로 반박했습니다. 일이 무겁다면 네트워크 시간이 커야 하는데, 네트워크는 0.7초였고 대기가 22.9초였습니다. 요청 한 건이 20ms 만에 끝나도 0.85초를 쉬었으니, 대기는 일의 크기와 아무 관계가 없었습니다. 일을 가볍게 만들어도 이 대기는 한 푼도 줄지 않습니다.
무신사와 텀블러도 같은 방향을 가리켰습니다. 무신사가 스크롤에 쓴 55.2초는 이미지를 받는 시간이 아니라 이미 충분히 모인 후보를 더 모으는 시간이었습니다. 30장이 필요한데 496개를 모았다는 숫자가 그 사정을 그대로 보여 줍니다. 텀블러의 40.1초는 원본 찾기가 느려서가 아니라, 찾을 필요가 없는 이미지에 찾기를 시도해서 생긴 시간이었습니다.
상한을 낮추는 선택지는 이 셋 어디에도 맞지 않았습니다. 상한을 낮추면 초는 줄지만 받는 장수가 같이 줄고, 우리가 정한 판정 기준으로는 개선이 아닙니다. 그래서 이번 작업에서는 상한 값을 하나도 건드리지 않았습니다. 워커를 늘리는 선택지는 뒤에서 따로 다룹니다.
진짜 원인 — 일의 크기와 무관한 대기 세 종류
세 병목을 나란히 놓으면 원인은 하나로 모입니다. 도구가 '해야 할 일'을 기준으로 멈추거나 쉬지 않고, 일과 상관없는 규칙으로 기다리고 있었습니다.
- 루리웹 — 요청이 끝난 뒤에 고정 시간을 잤다. 응답이 20ms 만에 와도 0.85초를 채웠다
- 무신사 — 필요한 후보 수와 무관하게 피드 바닥까지 스크롤했다. 끝없는 피드에서는 바닥이 사실상 없다
- 텀블러 — 피드에 1280px 원본이 이미 깔려 있는데, '화면 주소를 그대로 받았다'를 '원본을 못 찾았다'로 읽고 원본 찾기를 다시 돌렸다
무신사의 스크롤은 우리 시간만 잡아먹지 않습니다. 스크롤을 한 번 더 내릴 때마다 사이트는 다음 묶음을 불러오느라 요청을 더 받습니다. 필요 없는 스크롤은 우리 쪽 대기이자 상대 서버에 얹는 부하였습니다. 무한 스크롤을 다루는 수집기가 멈출 시점을 잘못 잡는 문제는 무한 스크롤 크롤링에서 종료 로그를 믿었다가 과거 글을 놓친 사례에서 반대 방향으로 다룬 적이 있습니다. 그때는 너무 일찍 멈춘 쪽이 문제였고, 이번에는 너무 늦게 멈춘 쪽이 문제였습니다.
세 병목에는 공통 구조가 하나 더 있습니다. 대기, 스크롤, 원본 찾기 모두 멈추거나 쉬는 조건이 결과를 보지 않았습니다. 루리웹의 대기는 응답이 얼마나 빨리 왔는지를 보지 않았고, 무신사의 스크롤은 후보가 얼마나 모였는지를 보지 않았고, 텀블러의 원본 찾기는 받은 파일이 얼마나 큰지를 보지 않았습니다. 그래서 세 조치도 같은 방향으로 갔습니다. 멈추는 조건을 실제로 일어난 일에 묶는 방향입니다.
조치 1 — 후보가 충분히 모이면 스크롤을 멈춘다
첫 조치는 스크롤을 멈추는 기준을 '바닥'에서 '충분한 후보 수'로 바꾼 일입니다. 기준은 `scroll_enough(limit) = max(limit×4, 40)` 입니다. 받을 장수의 4배, 최소 40개의 후보가 모이면 더 불러오지 않습니다.
여기서 조심한 점이 있습니다. 이 조치는 받을 계획을 자르지 않습니다. 이미 모은 후보는 그대로 두고, 더 불러오는 동작만 멈춥니다. 원본 찾기에서 일부가 실패해도 남은 후보로 30장을 채울 여유를 4배로 잡았습니다. 끝이 있는 갤러리는 대개 이 수에 닿기 전에 바닥이 나오므로 예전처럼 끝까지 내립니다. 끝없는 피드에서만 차이가 납니다.
스크롤은 도구 안에서 세 경로로 일어납니다. 마우스 휠 스크롤, 페이지 안에서 이미지를 모으는 자바스크립트, 실제 크롬 브라우저를 붙여 덩어리 단위로 내리는 경로입니다. 셋 중 하나만 고치면 다른 경로로 들어온 대상은 여전히 바닥까지 내려가므로, 세 경로에 같은 기준을 함께 넣었습니다.
조치 2 — 요청 뒤에 자지 않고, 같은 호스트 요청의 시작 사이 간격을 지킨다
두 번째 조치가 이 글의 중심입니다. 예전 코드는 요청이 끝날 때마다 고정 시간을 잤습니다. 새 코드(`HostPacer`)는 같은 호스트로 가는 요청의 시작 시각 사이에 최소 간격만 지킵니다. 응답이 늦게 오면 그 사이에 간격이 이미 지나가므로 따로 쉴 필요가 없고, 응답이 20ms 만에 오면 남은 만큼만 기다립니다.
기준을 호스트로 잡은 이유는 차단의 주체에 있습니다. 요청을 막는 쪽은 상대 호스트이지 우리 프로세스가 아닙니다. 한 번의 실행이 페이지를 주는 호스트와 이미지를 주는 CDN(이미지 전송 전용 서버)에 요청을 나눠 보내면, 각 호스트가 보는 요청 속도는 그만큼 낮아집니다. 프로세스 전체에 하나의 대기를 걸면 이 사실을 활용하지 못합니다.
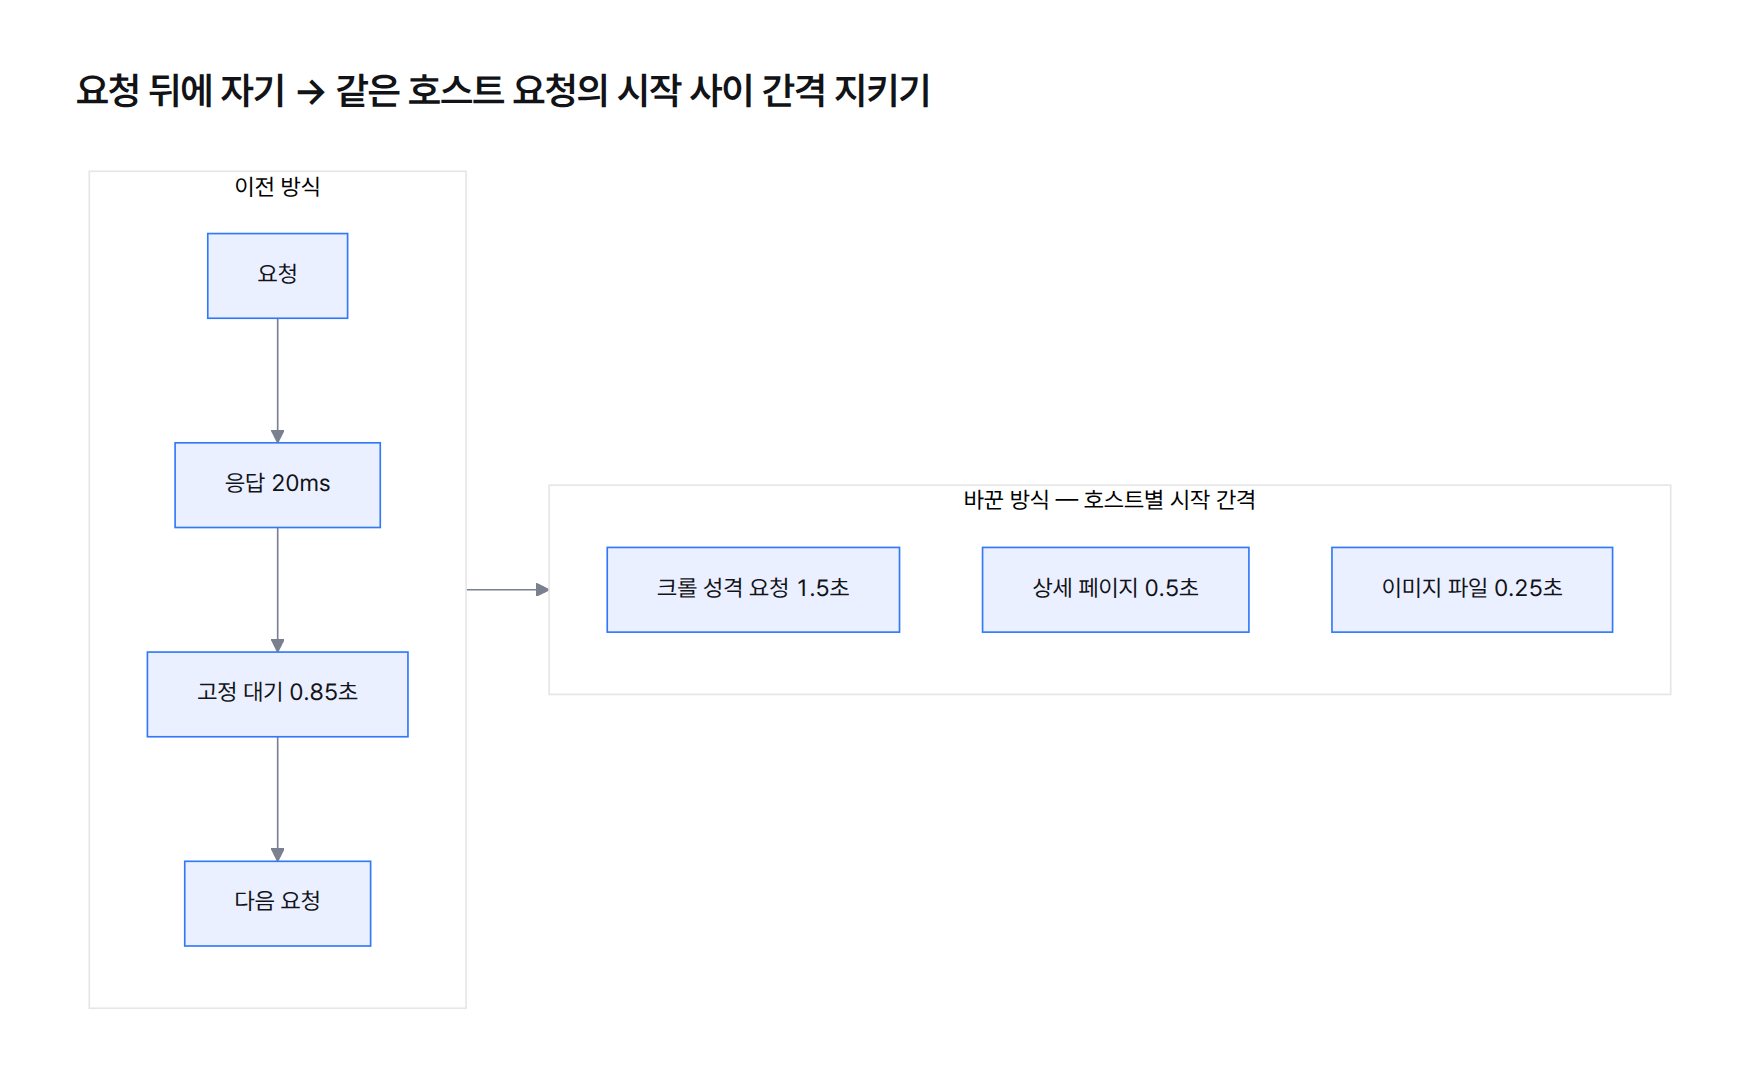
간격은 요청 성격에 따라 세 단으로 나눴습니다. 크롤처럼 보이는 요청은 1.5초, 상세 페이지 한 장은 0.5초, 이미지 파일은 0.25초입니다. 크롤처럼 보이는 요청의 간격 1.5초는 예전과 같습니다.
처음 고친 방식도 틀렸다 — 두 단으로 묶었더니 오히려 4% 느려졌다
처음부터 세 단이었던 것은 아닙니다. 첫 시도는 페이지와 이미지 두 단이었고, 페이지 쪽 간격을 크롤 속도인 1.0초에 맞췄습니다. 가장 위험한 요청에 맞춘 값이니 안전하다고 생각했습니다.
실측 결과는 반대였습니다. 상세 페이지 한 장을 받는 요청까지 크롤 속도에 묶이면서 safebooru 가 오히려 4% 느려졌습니다. 가장 위험한 것에 맞춘 값이 가장 안전한 것까지 묶으면, 아무 이득 없이 느려지기만 합니다. 이 실패 덕분에 크롤 성격 요청과 상세 페이지 요청을 떼어 세 단으로 나눴습니다.
워커 수를 늘리는 선택지도 같은 논리로 기각했습니다. 간격이 호스트별로 지켜지는 한, 워커를 늘려도 그 호스트가 보는 속도는 그대로이고 늘린 만큼 대기만 쌓입니다. 속도를 움직이는 손잡이는 워커가 아니라 간격입니다.
돌아보면 두 단 방식의 실패는 측정을 먼저 한 덕분에 드러났습니다. 안전해 보이는 값을 골랐다는 확신만으로 넘어갔다면, safebooru 가 4% 느려진 사실은 어디에도 남지 않았을 터입니다. 고친 뒤에도 같은 조건으로 다시 재는 습관이 첫 수정의 오류를 잡았습니다.
조치 3 — 원본 찾기는 저장한 파일이 썸네일 크기일 때만
텀블러에서 새던 40.1초는 판정 한 줄에서 나왔습니다. 도구는 '화면에 보이는 주소를 그대로 받았다'를 '원본을 못 찾았다'로 읽고 원본 찾기를 다시 돌렸습니다. 그런데 텀블러 피드에는 1280px 원본이 처음부터 깔려 있어서, 화면 주소가 곧 원본이었습니다.
그래서 원본 찾기를 타는 조건을 주소가 아니라 결과물로 바꿨습니다. 실제로 저장한 파일의 크기가 썸네일로 의심되는 기준(`THUMB_SUSPECT_PX`)보다 작을 때만 원본을 다시 찾습니다. 이미 큰 파일을 받았다면 주소가 어떻게 생겼든 손대지 않습니다.
판정 기준을 바꾼 방향이 핵심입니다. 예전 판정은 '어떤 주소를 받았나'라는 과정을 봤고, 새 판정은 '무엇을 받았나'라는 결과를 봅니다. 과정으로 판정하면 사이트마다 주소 규칙이 다를 때 틀리기 쉽습니다. 텀블러처럼 화면 주소가 곧 원본인 사이트에서는 과정 판정이 늘 '실패'를 외치고, 회당 5.01초짜리 헛수고가 이미지마다 붙습니다. 결과 판정은 사이트 규칙을 몰라도 틀리지 않습니다.
요청 속도를 올려서 빨라진 것은 아닌가?
이미지 파일 간격 0.25초는 초당 4개입니다. 숫자만 보면 상대 서버에 더 세게 요청하는 것처럼 보여서 따로 따져 봤습니다.
예전 코드도 이미 루리웹에 초당 약 2.5개를 대상 구분 없이 보내고 있었습니다. 워커 2개가 각각 요청 0.02초와 대기 0.79초를 한 바퀴로 돌았기 때문입니다. 사람이 쓰는 브라우저는 페이지 한 장을 열 때 이미지 수십 개를 간격 없이 동시에 받습니다. 이미지 파일에 초당 4개는 이 둘 사이에 있습니다.
숫자를 하나 더 보면 예전 방식의 모순이 드러납니다. 예전 코드는 요청 종류를 가리지 않았기 때문에, 이미지 파일 한 장도 크롤 요청과 똑같이 기다렸고 크롤 요청도 이미지 파일과 똑같은 속도로 나갔습니다. 서버 눈에 가장 수상한 요청과 가장 평범한 요청을 한 줄로 세운 셈입니다. 세 단으로 나눈 뒤에는 수상해 보일 수 있는 요청은 그대로 느리게, 평범한 요청만 빠르게 나갑니다.
차단 장치(WAF, 웹 방화벽)가 세는 쪽은 이미지 파일이 아니라 크롤처럼 보이는 요청입니다. 그 간격은 1.5초로 예전과 같습니다. 여러 수집 프로그램이 한 주소에서 요청을 몰아 보냈다가 막힌 경험은 유튜브 자동 수집 IP 차단, 원인은 새 스크립트 하나였다에 따로 적었습니다.
재측정 결과 — 같은 URL, 같은 30장
같은 URL에 같은 `--limit 30` 으로 다시 쟀습니다. 받는 장수와 해상도는 전과 같고, 바뀐 것은 대기 방식과 멈추는 기준뿐입니다.
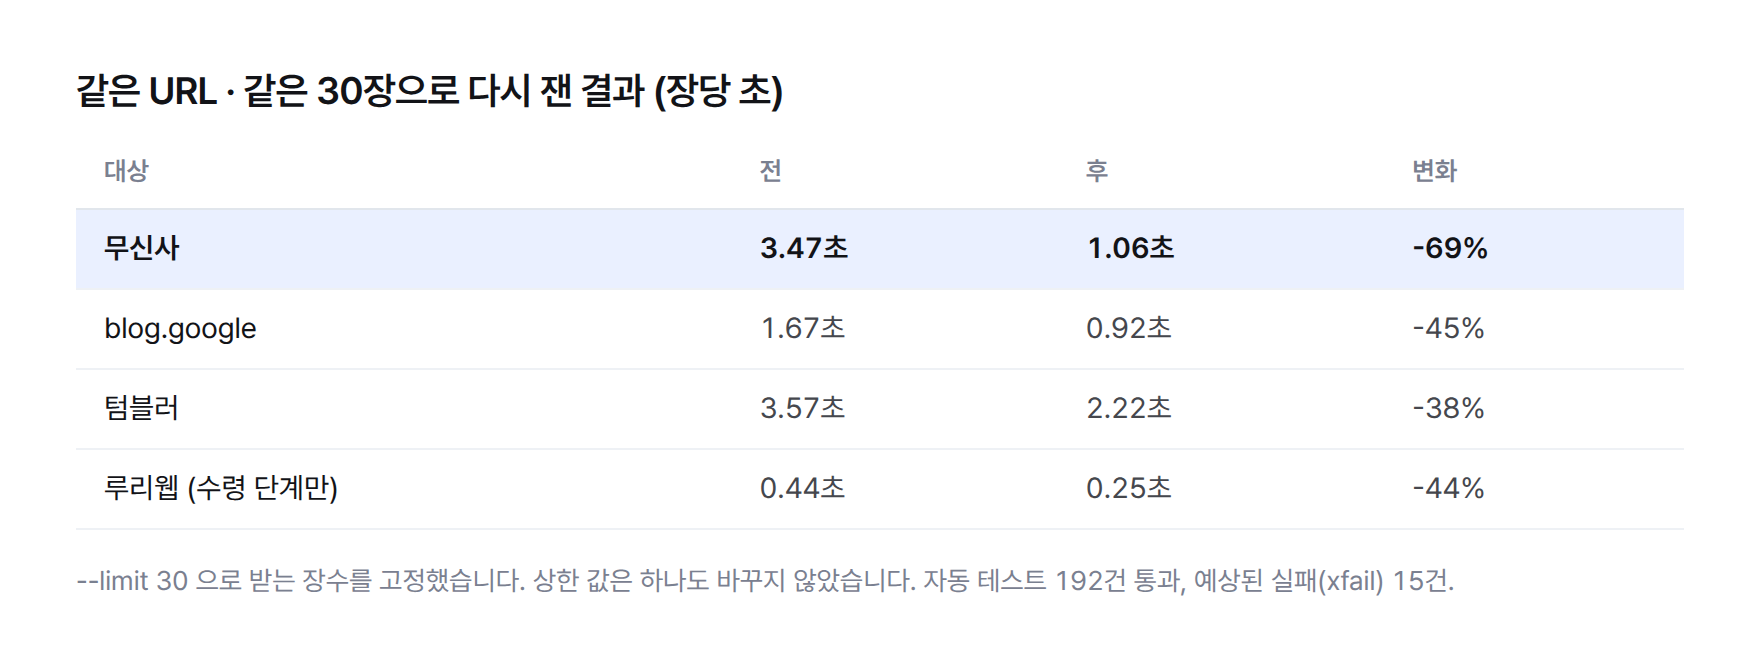
무신사는 장당 3.47초에서 1.06초로 69% 줄었습니다. 스크롤을 멈춘 효과가 가장 크게 나온 곳입니다. blog.google 은 1.67초에서 0.92초로 45%, 텀블러는 3.57초에서 2.22초로 38% 줄었습니다. 루리웹은 이미지를 받는 수령 단계만 떼어 보면 장당 0.44초에서 0.25초로 44% 줄었습니다.
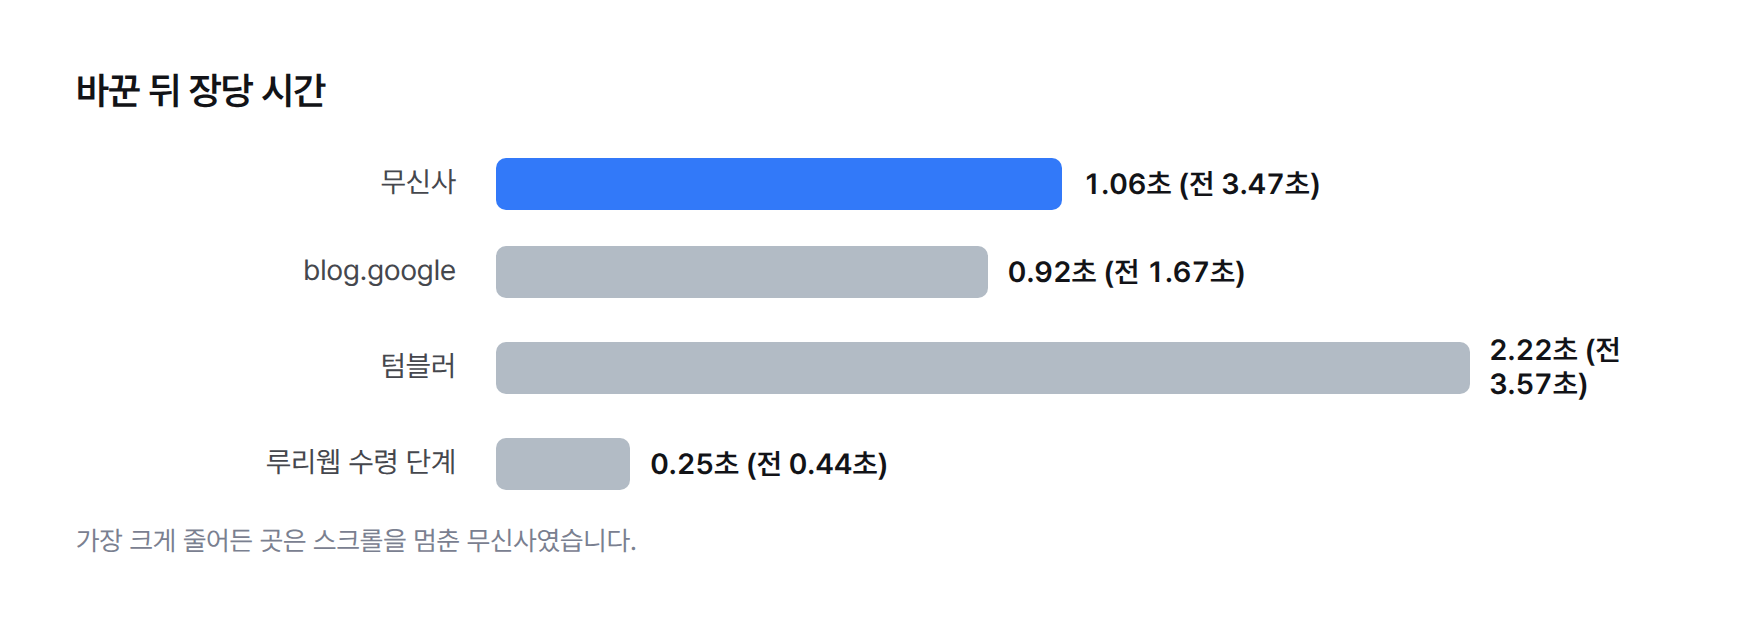
텀블러는 줄어든 뒤에도 장당 2.22초로 넷 가운데 가장 느립니다. 원본 찾기 헛수고는 걷어냈지만, 남은 시간이 어느 구간에서 나오는지는 이번 재측정 기록으로 나누지 못했습니다. 다음에 구간별 시간을 다시 켜고 볼 대상입니다. 코드 쪽 회귀도 함께 확인했습니다. `pytest -q tests` 로 자동 테스트 192건이 통과했고, 알려진 실패로 표시해 둔 xfail 15건은 그대로였습니다.
남는 한계 — 아직 재지 않은 두 대상
세 단 간격의 효과를 safebooru 와 wikipedia 에서는 아직 재지 못했습니다. 두 곳 모두 이날 이미 두 번씩 요청을 보낸 상태였고, 같은 대상을 짧은 시간에 반복해서 때리지 않는다는 우리 규칙에 따라 더 보내지 않았습니다. 두 단 방식이 safebooru 를 4% 느리게 만들었다는 사실은 확인했지만, 세 단 방식이 그 손실을 되찾았는지는 아직 모릅니다.
대신 구조가 같은 새 대상인 wordpress.org/photos 로 확인했습니다. 총 25.4초 가운데 대기는 3.8초였고, 나머지는 전부 네트워크 시간이었습니다. 대기가 일을 압도하던 루리웹과는 다른 그림입니다. safebooru 와 wikipedia 는 다음 작업의 첫 실행에서 확인합니다.
숫자 하나도 짚어 둡니다. 루리웹 기록에는 대기 22.9초가 실행 총 19.7초의 81%로 남아 있어, 대기 합이 총 시간보다 큽니다. 워커 2개의 대기를 더한 값이라 벽시계 시간보다 커졌다고 보고 있지만(추정: 워커 2개 병렬 실행 기준), 구간 기록이 합산 방식을 따로 남기지 않아 확정하지는 못했습니다. 루리웹 결과를 수령 단계만 떼어 보고한 이유도 여기에 있습니다.
실행 전체 시간으로 루리웹 전후를 비교하지 않은 점도 한계로 남깁니다. 분모가 확실하지 않은 비율을 전체 개선율로 내세우면, 이 글이 비판한 '장수를 줄여 얻은 초'와 같은 종류의 착시를 만들 수 있습니다. 그래서 확실히 같은 조건으로 잴 수 있는 수령 단계 0.44초와 0.25초만 적었습니다.
정리하면, 느린 수집 도구 앞에서 먼저 볼 곳은 일의 크기가 아니라 기다리는 규칙입니다. 상한을 낮추면 빨라지지만 덜 받고, 워커를 늘리면 대기만 늘어납니다. 비슷한 수집·자동화 도구의 속도나 차단 문제를 겪고 있다면 상담으로 상황을 알려 주세요.