증상: 프롬프트를 바꿔도 재현율이 목표에 닿지 않았다
RAG 성능 평가에서 재현율이 안 오르는 원인은 프롬프트가 아니라 검색 천장이었다. 이 결론에 닿기까지 프롬프트 변형 실험을 두 번 태웠고, 천장을 재는 과정에서도 두 번 틀렸다. 그 순서를 그대로 적는다.
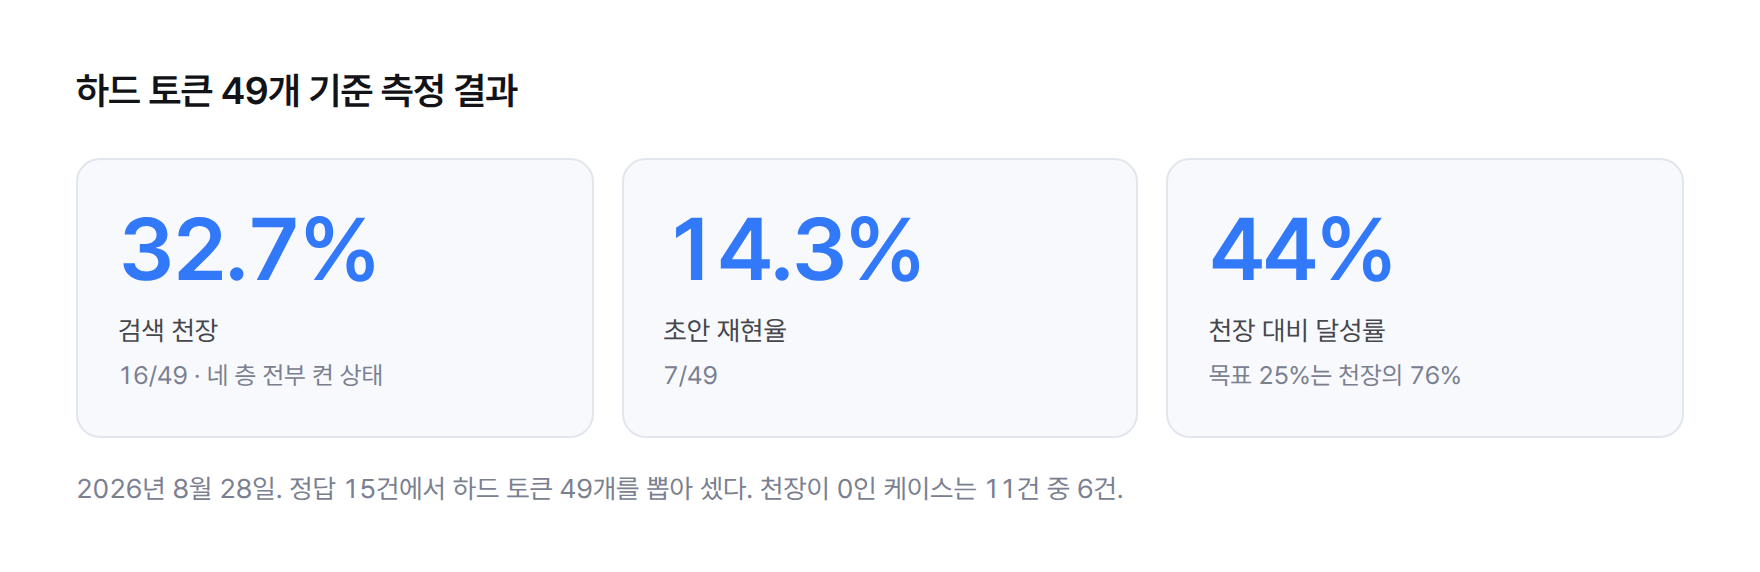
재현율은 여기서 단순한 지표다. 담당자가 쓴 정답에서 꼭 맞혀야 하는 조각을 뽑고, 모델 초안이 그 조각을 몇 개나 그대로 담았는지 센다. 이 조각을 「하드 토큰」이라 불렀다. 수치, 법 조문 번호, 인용 문구, 슬라이드 번호처럼 말을 바꿔 쓰면 틀리는 것들이다. 정답 15건에서 49개가 나왔다.
작업 계획서의 완료 기준 하나가 재현율 25%였다. 가장 나은 초안 생성기가 낸 값은 7/49, 14.3%였다. 목표의 절반을 조금 넘긴 값이었고, 다음 실험을 무엇으로 할지 정해야 했다.
처음엔 무엇을 의심했나?
처음 의심한 대상은 모델에게 주는 지시문이었다. 자료는 다 넘겼는데 모델이 그걸 제대로 안 쓴다고 봤다. 달성률이 낮으니 모델이 게으르다, 지시가 흐리다는 해석이 가장 손쉬웠다.
그래서 개입을 지시문 쪽에 몰았다. 초안을 두 번에 나눠 쓰게 하는 2단계 생성, 질문 종류에 따라 자료를 골라 넣는 조건부 주입, 역할별로 답 범위를 막는 역할 제한을 차례로 붙였다. 일곱 번째와 여덟 번째 실험에서는 절차 문서를 모델이 직접 훑어 근거를 찾게도 시켰다. 그 두 번은 재현율을 끌어올리지 못했다.
돌이켜 보면 이 단계에서 빠진 질문이 하나 있었다. 정답에 들어 있는 그 수치와 조문이 우리가 넘긴 자료 안에 애초에 있기는 했나. 지시문을 아무리 다듬어도 모델은 받은 자료 밖의 숫자를 정확히 맞힐 수 없다.
무엇으로 확인했나?
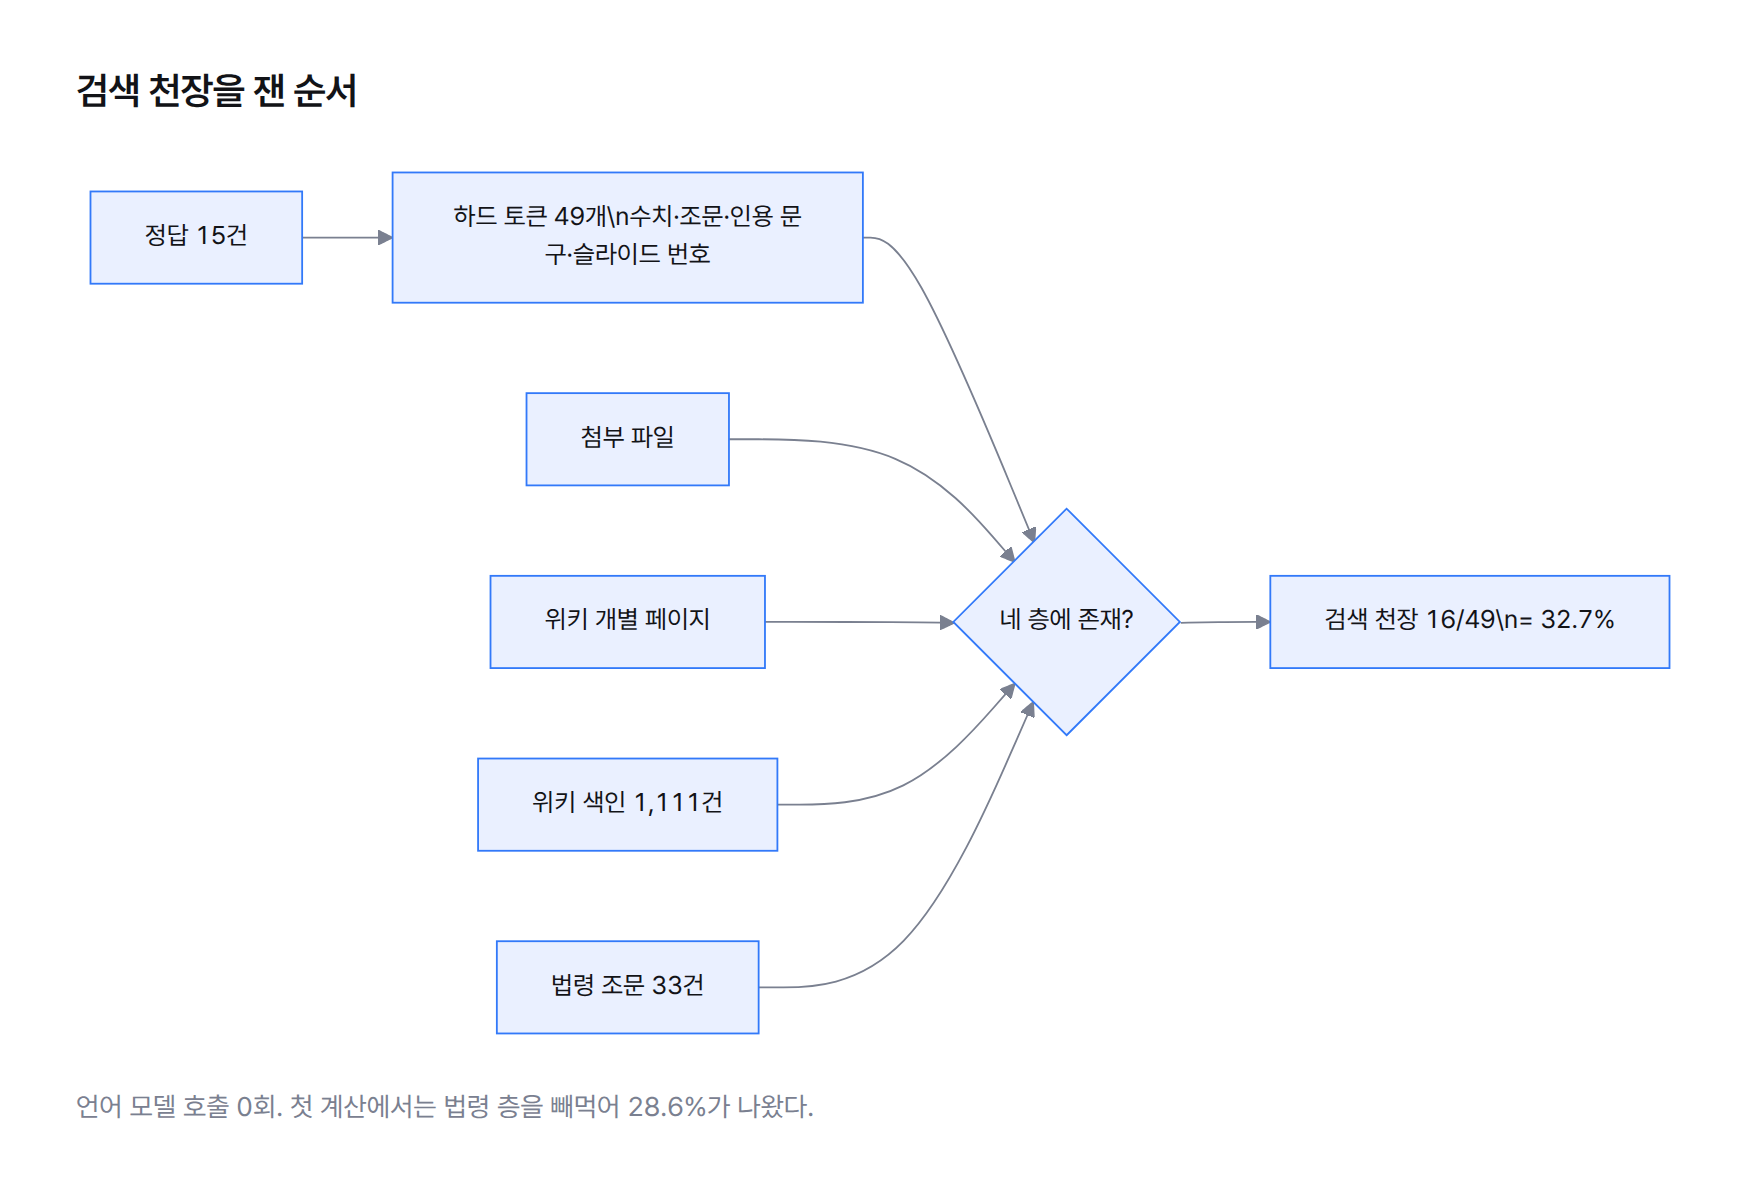
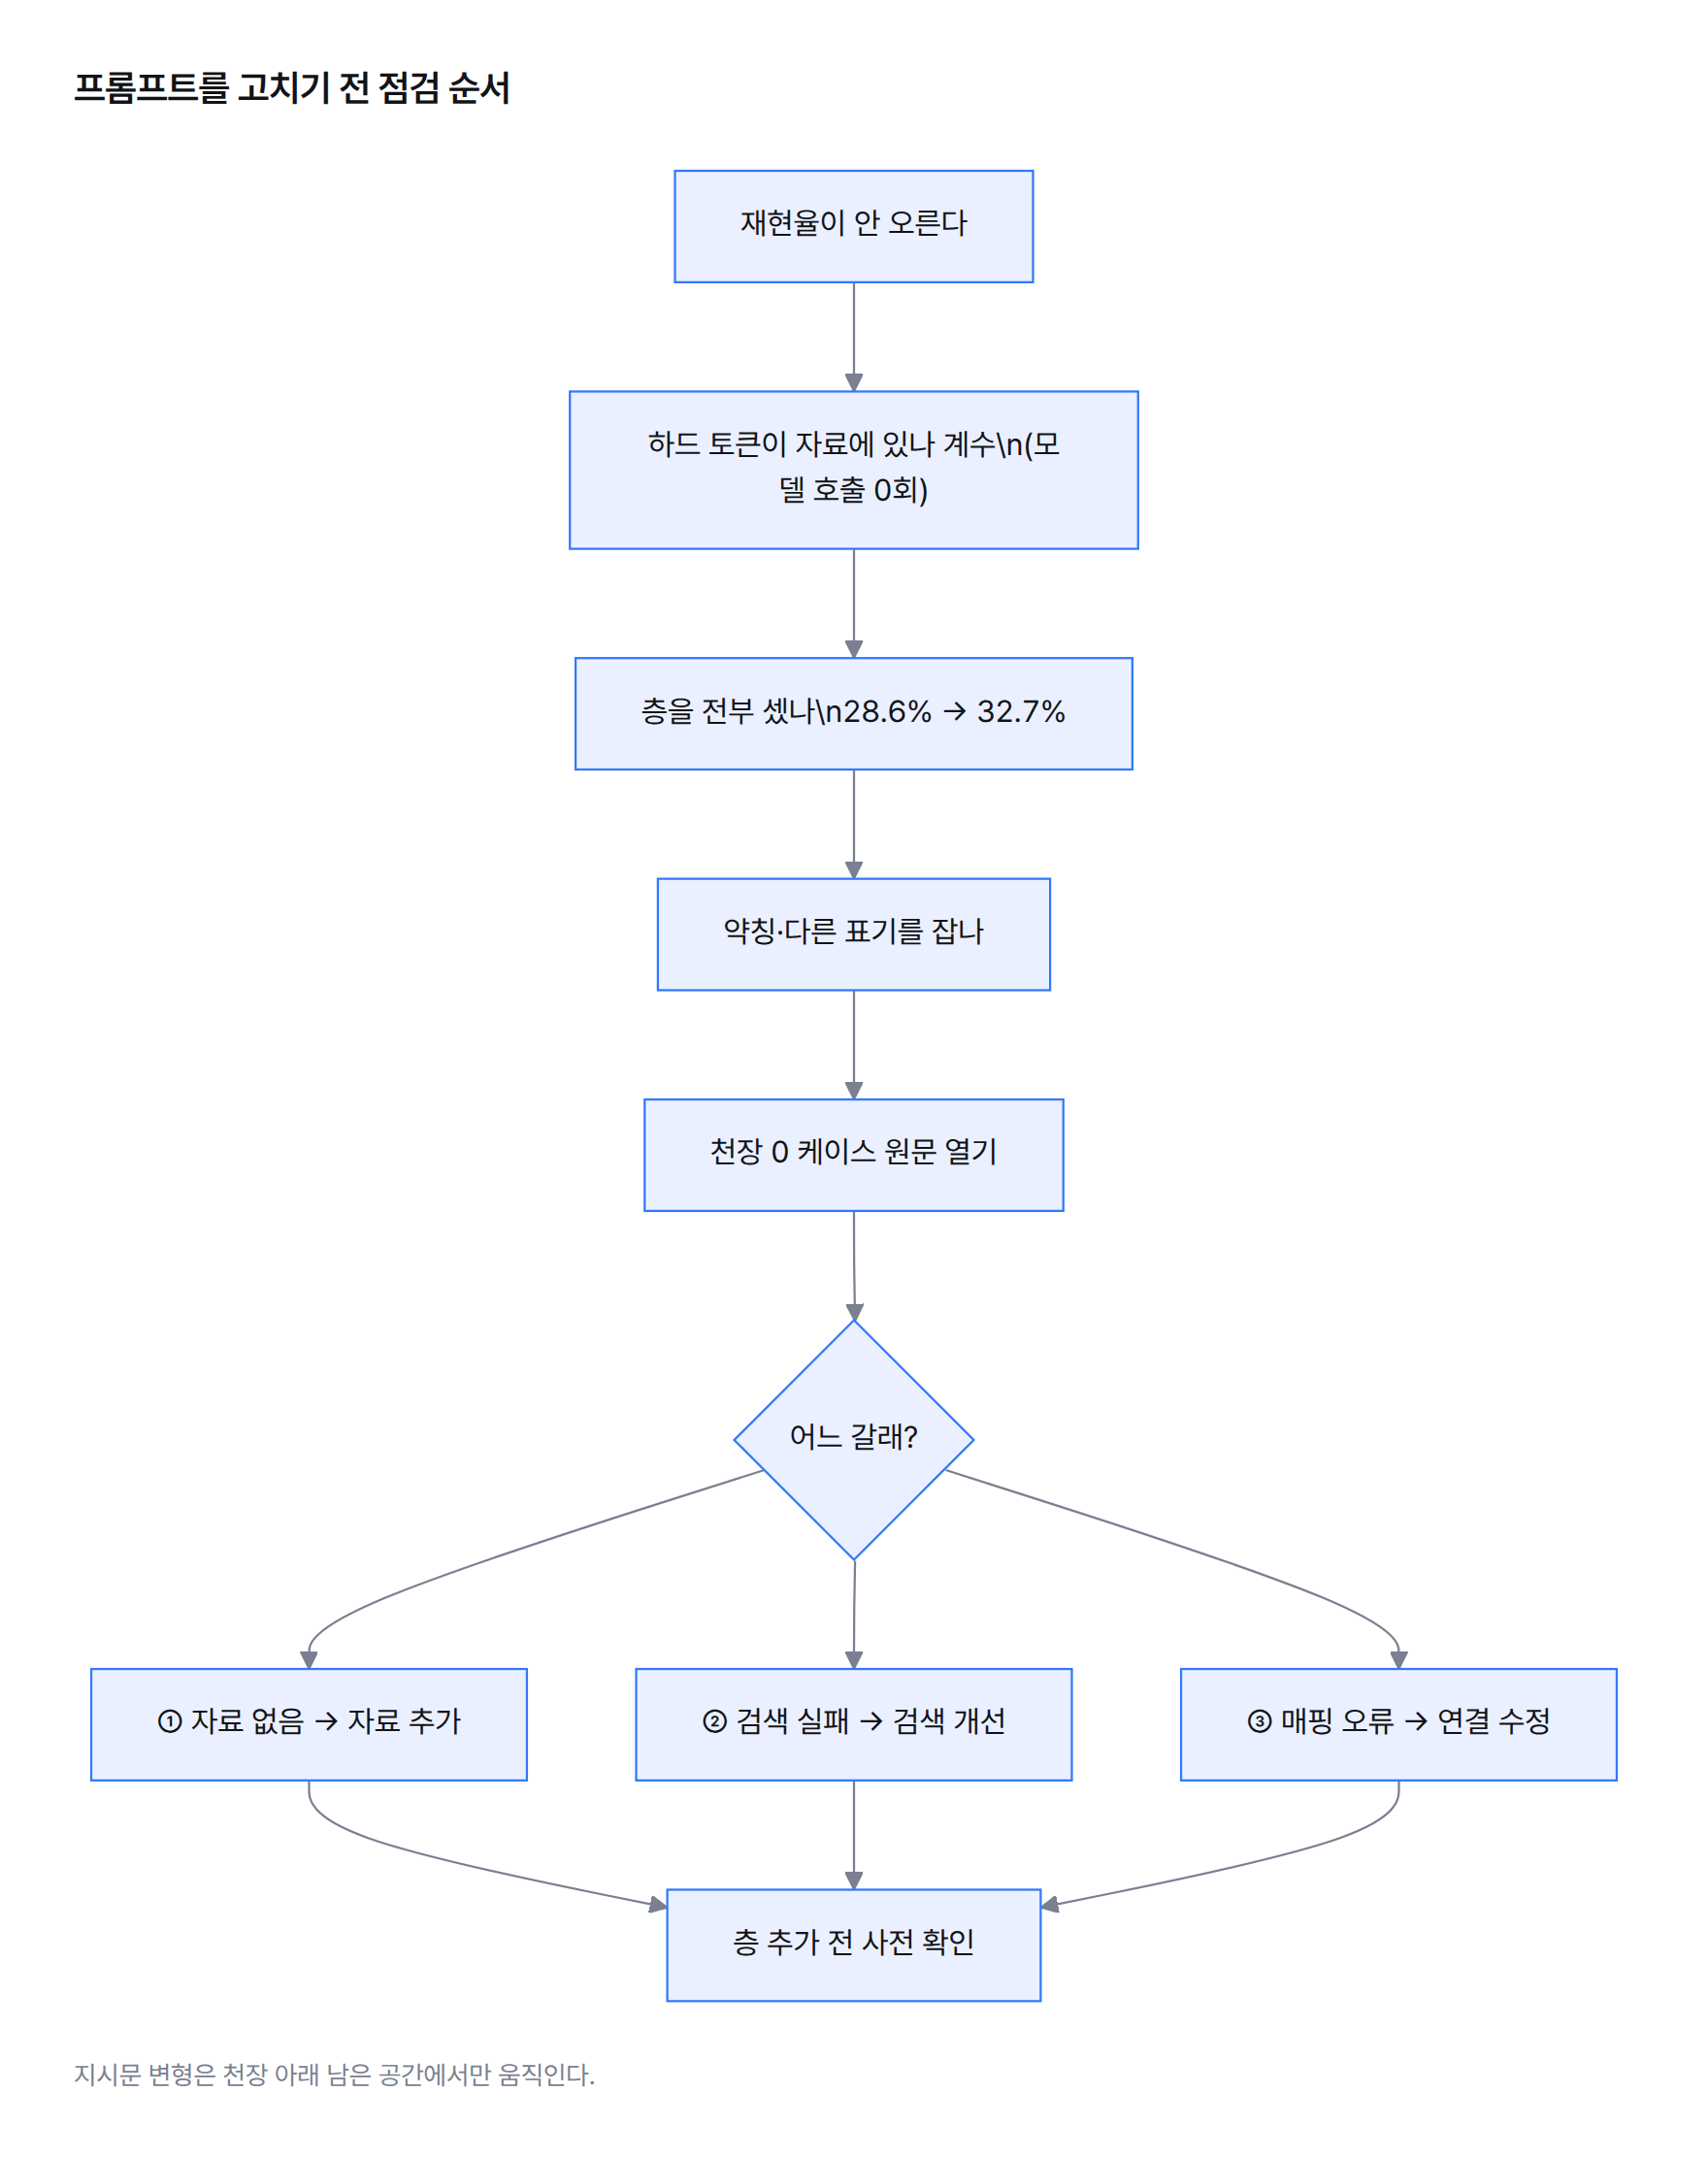
확인 수단은 언어 모델을 한 번도 부르지 않는 단순 계수였다. 하드 토큰 49개 각각이 모델에게 주는 자료 안에 문자열로 존재하는지 센다. 존재하는 비율이 곧 이 시스템이 낼 수 있는 재현율의 상한, 검색 천장이다.
자료를 주는 층은 넷이고 전부 켠 상태로 셌다.
- 질문에 딸린 첨부 파일
- 사내 위키(Confluence)의 개별 페이지
- 위키 공간 전체 색인 1,111건
- 법령 조문 33건 — 금융소비자보호법·자본시장법 계열
이 방식의 장점은 비용이 0에 가깝고 결과가 결정론이라는 데 있다. 같은 입력이면 몇 번을 돌려도 같은 숫자가 나온다. 모델 채점처럼 판정이 흔들릴 여지가 없다.
왜 프롬프트는 범인이 아니었나?
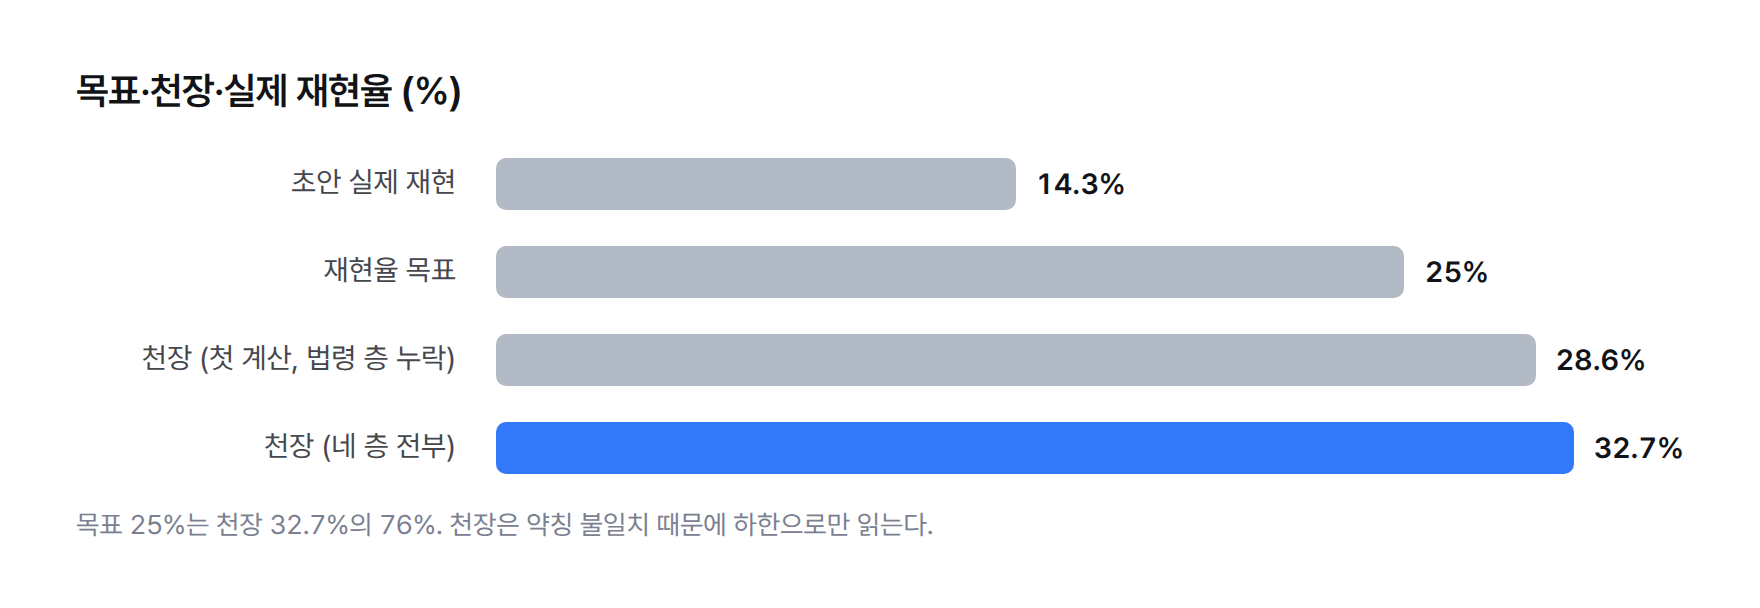
결과는 16/49, 32.7%였다. 49개 중 33개, 정답에 필요한 조각 대부분이 모델이 받는 자료 어디에도 없었다. 초안이 맞힌 7개는 천장 16개 대비 44%다. 모델이 게으르다고 볼 숫자가 아니었다.
| 항목 | 값 |
|---|---|
| 자료에 존재하는 토큰 (검색 천장) | 16/49 = 32.7% |
| 초안이 실제로 재현한 토큰 | 7/49 = 14.3% |
| 천장 대비 달성률 | 44% |
| 천장이 0인 케이스 | 11건 중 6건 |
목표의 의미도 달라졌다. 재현율 25%는 천장 32.7%의 76%다. 자료에 있는 정보 대부분을 빠짐없이 옮겨 적으라는 요구였고, 지금 44%에서 그 수준까지 지시문 하나로 끌어올린다는 계획이었다.
더 결정적인 건 천장이 0인 케이스 6건이다. 이 6건은 프롬프트를 어떻게 바꿔도 0에 머문다. 답의 근거가 준 자료 어디에도 없기 때문이다. 2단계 생성, 조건부 주입, 역할 제한은 전부 천장 아래 남은 공간 안에서만 움직이는 개입이었다. 가설은 여기서 반증으로 정리했다 — 병목은 지시문이 아니라 천장이다.
천장을 재는 동안 두 번 틀렸다
천장 숫자도 한 번에 맞지 않았다. 처음 계산한 값은 28.6%였다. 층이 넷인데 법령 조문 층을 빼고 셋만 셌다. 법령 층을 넣자 32.7%가 나왔다.
두 번째 오류는 약칭이었다. 어떤 케이스의 정답은 「자본시장법」「금소법」이라고 썼는데, 법령 자료에는 「자본시장과 금융투자업에 관한 법률」처럼 전체 이름으로 들어 있었다. 문자열로는 불일치라 존재하지 않음으로 셌다. 그 케이스의 「천장 0」은 자료가 없어서가 아니라 자의 눈금이 거칠어서 생긴 값이었다.
두 오류는 방향이 같았다. 둘 다 천장을 실제보다 낮게 보이게 했다. 그래서 이 32.7%는 「최소 이만큼은 자료에 있다」는 하한으로만 읽는다. 결론은 그대로 두되, 케이스별 「천장 0」은 원문을 열어 확인한 뒤에만 자료 부재라고 말하기로 했다.
천장을 잴 때는 층을 다 셌는지, 그리고 지표가 같은 사실의 다른 표기를 잡는지부터 확인한다. 이번엔 둘 다 틀렸고, 둘 다 천장을 낮게 보이게 하는 방향이었다.
천장 0인 6건은 정말 자료가 없었나?
6건의 원문을 열어 보니 세 갈래로 나뉘었다. 이미지 안에만 문구가 있어 글자로 뽑아야 하는 경우, 필요한 규정이 법령 자료에 아예 실려 있지 않은 경우, 그리고 어떤 자료로도 닿을 수 없는 경우다.
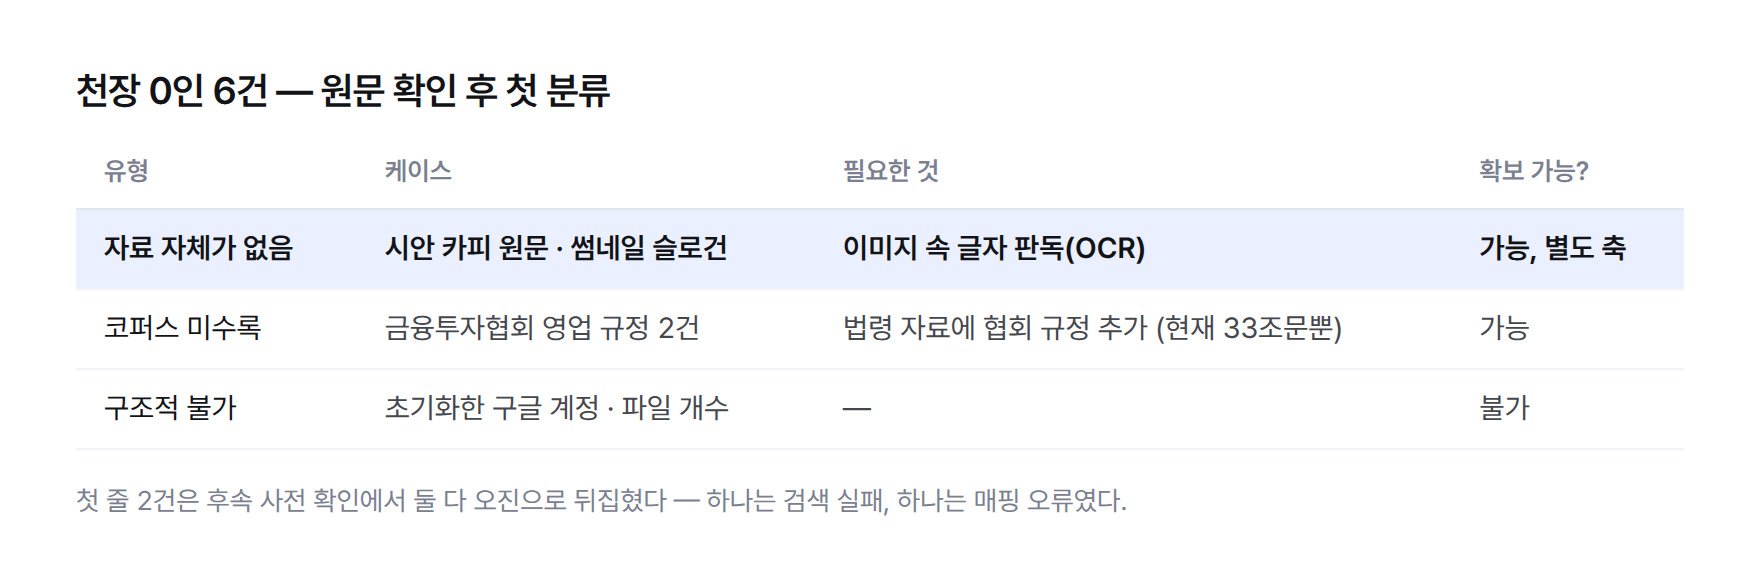
코퍼스 미수록 2건은 금융투자협회 영업 규정이 필요했다. 법령 자료에는 금융소비자보호법·자본시장법 계열 33조문뿐이고 협회 규정은 통째로 빠져 있었다. 이건 넣으면 되는 문제다. 구조적 불가 2건은 초기화한 구글 계정, 파일 개수처럼 자료를 아무리 붙여도 답이 나오지 않는 질문이었다.
문제는 첫 갈래였다. 시안 카피 원문과 썸네일 슬로건, 이 2건은 이미지 속 글자를 읽는 판독(OCR) 층이 필요하다고 적었다. 이 분류가 다음 실험 순서를 정했다. 그리고 이 분류 역시 틀렸다.
진짜 원인은 검색과 매핑이었다
여기서 「사전 확인」은 실험을 돌리기 전에 손으로 하는 점검을 말한다. 이미지를 직접 열어 읽고, 색인에서 문구를 문자열로 찾고, 검색을 한 번 돌려 순위를 본다. 초안을 새로 생성하지 않으니 모델 비용이 들지 않고, 결과가 틀릴 여지도 적다.
OCR 층을 붙이기 전에, 이번에도 언어 모델 호출 없이 먼저 확인했다. 두 케이스 다 오진이었고, 틀린 방향이 서로 달랐다.
썸네일 슬로건 케이스부터 보면, 받아 둔 이미지 5건을 전부 눈으로 읽었는데 필요한 슬로건은 한 장에도 없었다. 5건은 본문 캡처였고 정답이 인용한 문구는 썸네일에 있었다. 게다가 이 케이스는 첨부 파일이 0개라 이미지가 애초에 모델에게 들어가지도 않는다. 그 문구는 위키 색인 안에 마케팅 회의 노트로 1건 존재했다. 하지만 이 케이스 문맥으로 BM25 검색을 돌리면 상위 200위 안에 들지 못했다. 블로그 심의 스레드와 회의 노트가 쓰는 어휘가 거의 겹치지 않아서다. 자료는 있는데 검색이 못 찾는 경우다.
시안 카피 케이스는 반대였다. 연결해 둔 위키 문서(1,138자)는 제목은 맞는데 「시안」 절이 비어 있었다. 카피가 이미지로만 들어 있었기 때문이다. 그런데 같은 카피의 텍스트본이 다른 페이지(10,247자)에 있었다. 1,349번째 글자 근처에 「투자시그널이 내 주식, 24시간 대신 지켜봐 드려요」가, 3,448번째 근처에 「'내가 등록한 종목'만 골라 받는 맞춤 알림」이 있었다. 위키 검색을 돌리면 그 페이지가 점수 186.49로 1위였다. 자료도 있고 검색도 찾는데, 연결이 엉뚱한 문서를 가리키고 있었다.
| 갈래 | 뜻 | 이번 2건 중 |
|---|---|---|
| ① 자료가 없다 | 어느 층에도 답이 없다 | 0건 |
| ② 검색이 못 찾는다 | 자료는 있으나 상위 결과에 안 뜬다 | 썸네일 슬로건 |
| ③ 매핑이 다른 문서를 가리킨다 | 자료도 있고 검색도 찾지만 연결이 틀렸다 | 시안 카피 |
두 사례가 가르쳐 준 점은 천장 계수만으로는 부족하다는 사실이다. 문자열 계수는 「자료 어딘가에 있다」까지만 말해 준다. 그 자료가 검색 결과 상위에 실제로 뜨는지, 케이스에 연결한 문서가 그 자료를 가리키는지는 따로 봐야 한다. 그래서 천장 0 케이스를 볼 때는 위키 색인 전체에서 문구를 찾고, 그 케이스 문맥으로 검색을 돌려 순위를 확인하고, 연결해 둔 문서의 해당 절을 직접 여는 세 단계를 거치기로 했다.
OCR 처방은 ①을 전제한 것이라 두 건 모두 빗나갔다. 「천장 0」을 자료 부재로 읽으면 안 된다는 교훈이, 원문을 열어 본 뒤에도 한 번 더 필요했다.
어떻게 고쳤나?
고친 것은 지시문이 아니라 실험 순서다. 다음에 붙일 층을 OCR에서 위키 검색 층으로 바꿨다. 시안 카피 케이스는 OCR 없이 위키 검색 층만 켜도 정답 문구에 닿는다는 사실을 사전 확인으로 알았기 때문이다.
법령 층에서 이미 확인한 성공 사례도 근거가 됐다. 한 초안이 금융소비자보호법 시행령 제19조를 실제로 인용했는데, 그 조문은 기준 버전에는 없던 근거였다. 실패한 일곱 번째 실험과의 차이는 형태에 있었다. 조문을 인용할 수 있는 모양으로 놓아두는 방식은 통했고, 절차 문서를 모델에게 훑게 시키는 방식은 통하지 않았다.
- 천장을 끌어올리는 쪽으로 다음 개입을 옮긴다 — 지시문 변형은 천장 아래 공간만 쓴다
- 코퍼스 미수록 2건은 협회 규정을 법령 자료에 넣어 해결한다
- 시안 카피는 위키 검색 층으로, 썸네일 슬로건은 검색 어휘 차이부터 다룬다
- 구조적 불가 2건은 목표 분모에서 따로 표시한다
이 글을 쓰는 시점 기록에는 층을 붙인 뒤의 재현율 수치가 아직 없다. 그래서 「고쳐서 몇 %가 됐다」는 문장은 쓰지 않는다. 여기서 바뀐 것은 무엇을 먼저 할지에 대한 판단이고, 그 판단의 근거가 모두 모델 호출 0회짜리 계수였다는 점이 핵심이다.
같은 실수를 막는 장치는 무엇인가?
첫째 장치는 순서 규칙이다. 생성 품질 지표가 안 오르면 지시문을 고치기 전에 그 답이 입력에 존재하는지부터 센다. 천장을 모르면 달성률 44%를 「모델이 게으르다」로 오독하고, 자료가 없는 문제에 프롬프트 변형을 계속 태운다. 이번 실험이 일곱 번째, 여덟 번째에서 정확히 그렇게 했다.
둘째는 층을 붙이기 전 사전 확인 규칙이다. 새 자료 층을 붙이기 전에 언어 모델 호출 0회로 그 층이 정답에 닿는지 먼저 본다. 이 규칙이 이번 OCR 오진을 실행 전에 잡았고, 이런 식으로 실행을 아낀 일이 두 번째였다.
셋째는 적용 대상 확인이다. 같은 실험에서 그룹웨어(결재·품의 기록)를 층으로 붙일지 검토했다. 정답 15건을 결재 어휘로 훑자 5건이 걸렸지만 4건은 오탐이었다. 나머지 1건은 답의 내용 자체가 「결재 기록이 없다」는 사실이라, 그룹웨어를 색인해도 그 답에 닿지 않는다. 그래서 이번 축에서는 뺐다. 그룹웨어가 쓸모없다는 판정이 아니라, 이 15건으로는 그 층의 값을 잴 수 없다는 판정이다.
숫자가 0으로 나왔을 때 그것을 「없음」으로 읽는 실수는 다른 자리에서도 겪었다. 판례 검색에서 0건을 잘못 읽은 기록은 판례 검색 0건 오독에 정리했다. 사내 자료로 답 초안을 쓰는 RAG를 검토하고 있다면 상담에서 이런 천장 측정부터 함께 볼 수 있다.
RAG 성능 평가에서 무엇을 먼저 재야 하나?
정리하면 순서는 이렇다. 정답에서 바꿔 쓰면 틀리는 조각을 뽑는다. 모든 자료 층을 켠 상태로 그 조각이 자료에 존재하는 비율을 센다. 그 비율이 천장이고, 목표 재현율은 천장 대비로 다시 읽는다. 천장이 0인 케이스는 원문을 열어 자료 없음·검색 실패·매핑 오류로 가른다.
이번 실험에서 천장은 32.7%였고, 목표 25%는 그 76%였다. 이 두 숫자를 먼저 알았다면 지시문 실험 두 번은 하지 않았을 것이다. 그리고 천장 숫자 자체도 층 누락과 약칭 불일치로 낮게 나올 수 있으니, 하한으로 읽는 습관까지가 한 세트다.