그림을 붙인 유일한 글은 왜 비교표에 0건으로 나왔나
스레드 자동 발행 글의 반응을 재는 측정기가 좋아요를 읽지 못한 채 0으로 적고 있었고, 그 바람에 그림을 붙인 글이 실험 비교표에서 통째로 빠져 있었습니다. 처음 눈에 들어온 증상은 «처리군 표본 0건»이라는 한 줄뿐이었습니다.
배경부터 적습니다. 저희는 개발 과정을 스레드(Threads)에 매일 올리는데, 사람이 손대지 않고 정해진 시각마다 도는 예약 작업(크론)이 글을 쓰고 올립니다. 운영자가 «글만 나가서 눈에 안 띈다»고 짚었고, 그래서 글에 적힌 숫자로 카드 그림을 만들어 붙이는 기능을 9월 14일에 넣었습니다.
그림이 정말 반응을 올리는지는 실험으로 가리기로 했습니다. 발행 기록 파일의 행 수가 짝수인 회차에만 그림을 붙이고, 숫자가 둘 이상이라 그릴 수 있었는데 일부러 안 붙인 글을 대조군(control)으로 남깁니다. 30일 뒤 비교 명령이 그림을 붙인 글(attached)과 대조군의 반응을 견줍니다. 숫자가 둘 미만이라 그림을 못 그리는 글은 같은 부류가 아니라서 비교에서 뺍니다. 최근 30건 중 21건이 그릴 수 있는 조건을 채웠습니다.
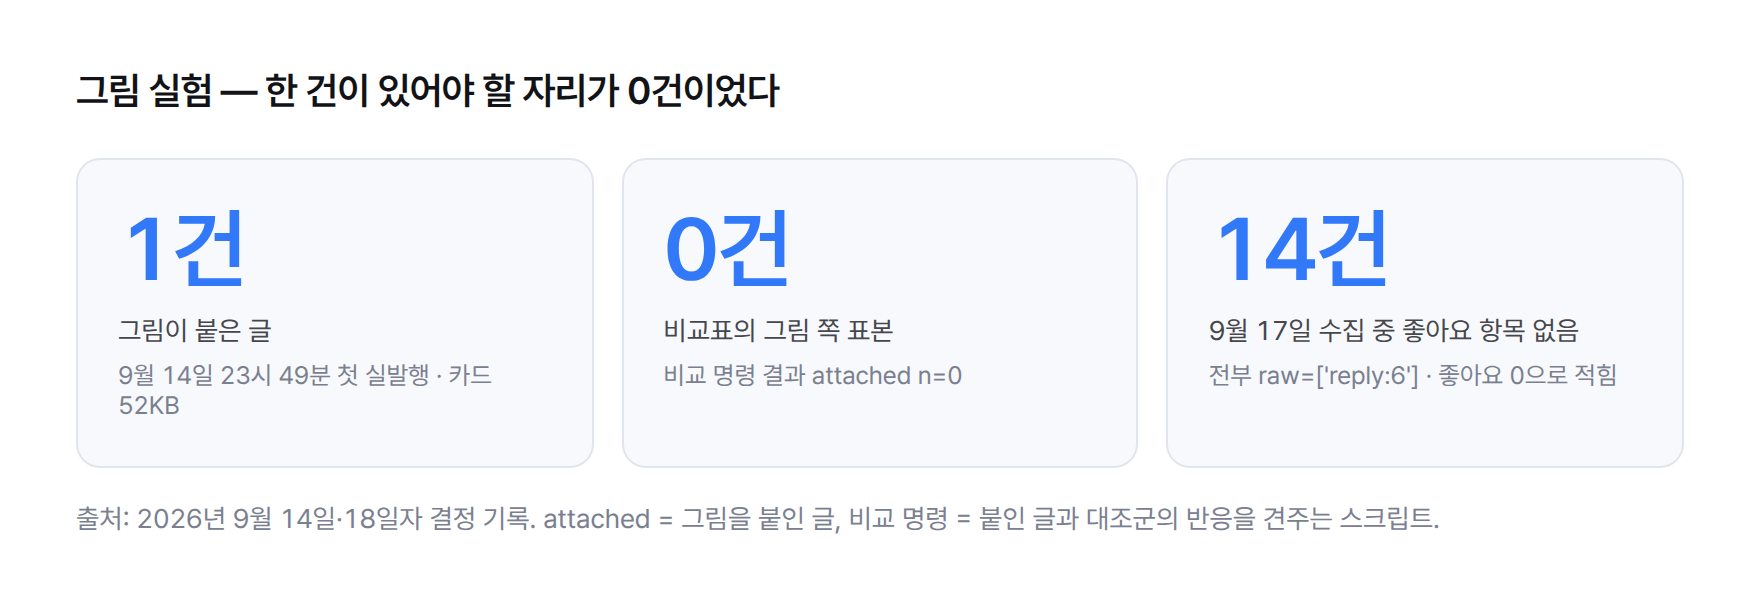
첫 실발행은 9월 14일 23시 49분에 크론이 혼자 해냈습니다. 글에서 숫자를 뽑고, 카드를 그리고(52KB 이미지), 작성창에 첨부하고, 게시까지 사람 개입 없이 끝났습니다. 그 시점에 발행 기록은 115행이었고 홀수라, 다음 회차는 대조군이 되도록 짜 두었습니다. 그림이 붙은 글은 이 한 건이었고, 실험의 처리군 표본도 이 한 건이었습니다.
며칠 뒤 비교 명령을 돌렸더니 attached 칸이 n=0 이었습니다. 한 건이 있어야 할 자리가 비어 있었습니다. 앞서 측정 결함으로 따로 빼 둔 글 12개를 살피다가, 그중 하나인 이 글이 왜 다시 측정되지 않았는지를 따라간 것이 이 글의 출발입니다.
처음 의심한 것은 무엇이었나
처음 떠올린 가설은 발행 쪽이었습니다. 처리군이 이 글 한 건뿐이라, 이 글의 발행 기록이 틀렸다면 실험은 바로 0건입니다. 그래서 그림이 정말 붙었는지부터 확인하기로 했습니다.
두 번째 가설은 측정이 이 글만 건너뛰었다는 쪽이었습니다. 따라가기 시작한 질문이 «왜 재측정이 안 됐나»였으니 자연스러운 방향이었습니다. 측정은 글을 올린 뒤 t24·t72라는 측정 창마다 글 화면을 다시 열어 숫자를 읽는 작업이라, 로그인이 풀렸거나 글을 못 찾으면 한 회차를 놓칠 수 있습니다.
두 가설 모두 «글이 어딘가에서 빠졌다»는 같은 모양이었습니다. 실제로 글은 빠져 있었지만, 빠진 이유는 두 가설이 가리킨 곳에 없었습니다.
그것을 확인하는 데 어떤 수단을 썼나
확인 수단은 세 가지였습니다. 모두 새로 만든 도구가 아니라 이미 남아 있던 기록과 화면입니다.
- 발행 기록 — 글마다 «그림이 붙었는가(visual.attached)», 카드 파일 경로, 게시 확인 여부가 남는 기록
- 측정 기록의 raw 칸 — 측정기가 화면에서 읽은 조각(예: like:1, reply:6)을 문자열로 적어 두는 칸
- 라이브 화면 — 실제 글을 열어 좋아요·답글·리포스트 아이콘의 HTML 구조(DOM)를 직접 훑는 것
셋 중 가장 쓸모 있었던 것은 raw 칸입니다. 측정기는 raw 칸의 조각을 숫자로 바꿔 like·reply·repost 칸에 적습니다. 숫자 칸만 보면 0이 진짜 0인지 못 읽은 0인지 알 수 없습니다. 반면 raw 칸에 like: 조각이 있는지는 눈으로 갈립니다. 저장된 0이 측정값인지 기본값인지를 되짚을 수 있는 유일한 자리였습니다.
발행기와 수집기 전체는 왜 범인이 아니었나
발행 쪽부터 닫았습니다. 9월 14일 23시 49분 글의 발행 기록에는 visual.attached 가 true 로 남아 있었고, 카드 파일(52KB)이 있었고, 게시 확인도 끝나 있었습니다. 그림은 붙었습니다. 첫 번째 가설은 여기서 반증됐습니다. 처리군에 한 건이 없었던 게 아니라, 있는 한 건을 비교표가 못 보고 있었다는 뜻입니다.
두 번째 가설, 측정이 이 글만 건너뛰었다는 쪽은 닫기가 더 어려웠습니다. 측정기는 돌고 있었고 숫자도 일부 읽고 있었기 때문입니다. 9월 17일에 수집한 14건을 열어 보니 전부 raw=['reply:6'] 였습니다. 답글 수는 읽힌다는 인상이 남았고, 이 인상이 오히려 눈을 가렸습니다.
그래서 기록을 시기별로 나란히 놓았습니다.
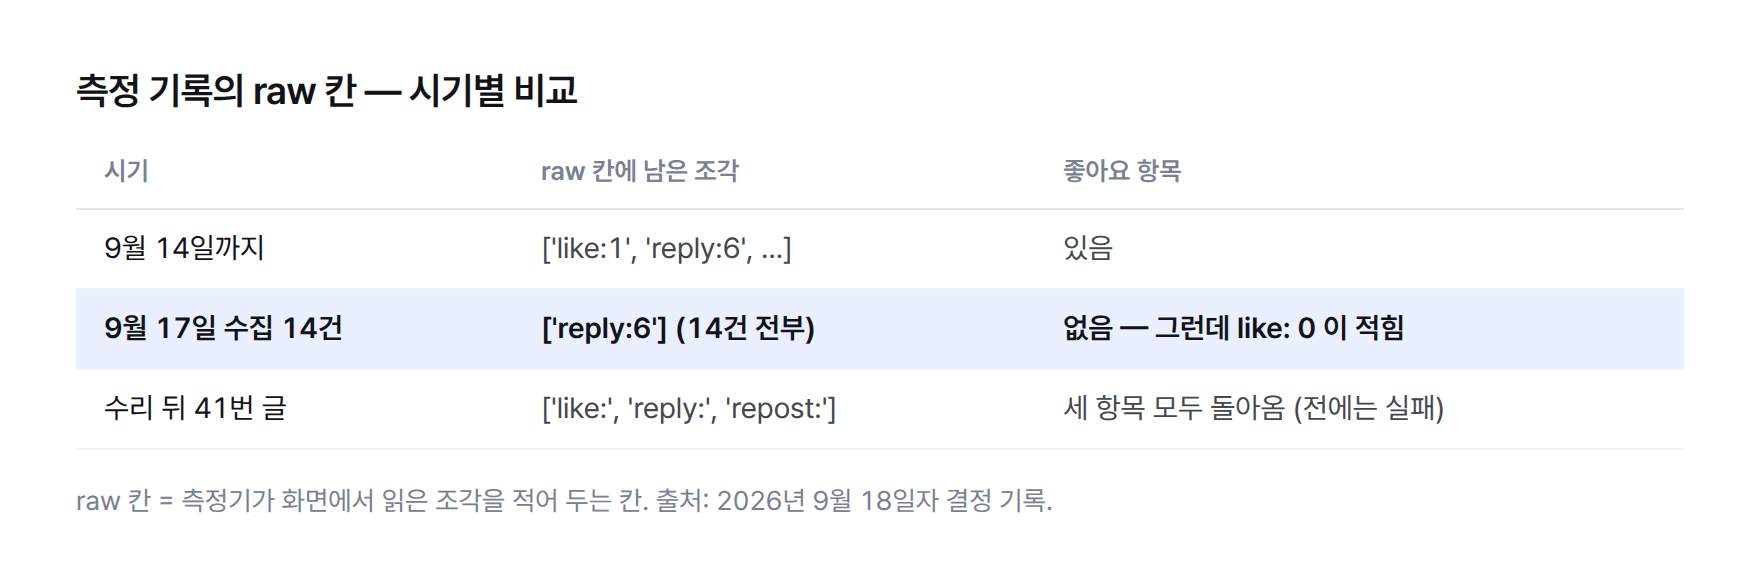
특정 글만 건너뛰는 문제라면 같은 날 수집한 다른 글은 정상이어야 합니다. 9월 17일 14건이 전부 같은 모양이었으니 두 번째 가설도 힘을 잃었습니다. 남은 가능성은 스레드 화면이 바뀌어서, 측정기가 읽는 방법이 더는 맞지 않는다는 쪽이었습니다.
진짜 원인은 무엇이었나: 아이콘 이름이 옮겨 갔다
라이브로 그 글을 열어 화면 구조를 훑었더니 액션바(좋아요·답글·리포스트 줄)의 아이콘이 ["", "좋아요"] 형태로 나왔습니다. 화면 낭독기가 읽는 이름표(aria-label)는 비어 있고, 이름이 svg 태그 안쪽의 title 로 옮겨 가 있었습니다.
측정기의 선택자는 svg[aria-label] 하나뿐이었습니다. 이름표가 비었으니 좋아요도, 답글도, 리포스트도 찾지 못했습니다. 답글 수가 계속 읽힌 것은 선택자가 맞아서가 아니라, 답글 정렬 컨트롤의 aria-label 에 숫자가 우연히 남아 있었기 때문입니다. 읽히는 항목이 하나 있다는 사실이 «수집기는 멀쩡하다»는 착각을 만든 셈입니다.
더 나쁜 것은 못 읽은 값의 처리였습니다. like: 조각이 raw 에 없는데도 기록의 like 칸에는 0이 적혀 있었습니다. 읽지 못했다는 사실이 «좋아요 0건»이라는 측정값으로 둔갑한 것입니다.
왜 반응이 없는 글은 기록에서 통째로 사라졌나
원인은 한 겹이 아니라 두 겹이었습니다. 첫 겹이 좋아요를 못 읽는 선택자였고, 둘째 겹이 그 위에 쌓인 «비면 실패»라는 처리였습니다.
측정 함수 measure() 는 raw 가 비면 그 회차를 실패로 처리했습니다. 좋아요·답글·리포스트가 전부 0인 글은 화면에 숫자가 하나도 안 그려집니다. 거기에 1조각짜리 글이라 제 답글도 없다면 raw 에 읽을 조각이 하나도 남지 않습니다. 그러면 실패로 처리하고, 기록 파일에는 한 줄도 안 들어갑니다.
그림을 붙인 41번 글이 정확히 이 경우였습니다. 반응이 전혀 없는 글만 골라서 지우는 구조에서, 그림 실험의 유일한 처리군이 반응 0 글이었습니다. attached n=0 의 원인이 이것입니다. 그림이 반응을 못 올렸다는 결과 이전에, 그림 붙은 글을 측정 대상으로 삼은 적이 없었던 겁니다.
같은 구멍은 다른 숫자도 흔들었습니다. 반응이 읽힌 글만 남는 쪽으로 표본이 기우니 반응률의 분모가 달라졌고, 이를 바로잡은 결과는 아래 수리 항목에 적습니다.
어떻게 고쳤나
수리는 네 갈래였고, 한 곳만 막으면 다음 변경에서 같은 사고가 되살아나기 때문에 겹으로 막았습니다.
- 선택자를 aria-label 과 svg 의 title 둘 다로 넓혔습니다. 스레드가 다시 이름을 옮겨도 한쪽은 남습니다.
- 못 읽은 값은 0이 아니라 null 로 적습니다. 조회수는 처음부터 그렇게 만들어 두었습니다.
- external_replies() 를 고쳤습니다. 화면 답글 수가 None 이면 외부 답글 수도 None 입니다. None 에서 무언가를 빼서 0을 만들지 않습니다.
- read_is_usable() 을 넣었습니다. 숫자를 하나라도 읽었으면 기록 파일에 적습니다. 노출 수만 읽힌 관측도 쓸모가 있기 때문입니다.
같은 결함이 두 번째 파이프라인에도 있었습니다. 동료 계정 글에 단 답글의 반응을 재는 스크립트(peer-reply-metrics.py)의 MEASURE_JS 도 svg[aria-label] 하나였고, 그쪽 좋아요도 같은 시점부터 안 읽히고 있었습니다. 같이 고치고, 집계에서 못 잰 관측은 빼되 그 건수를 함께 표시하도록 했습니다.
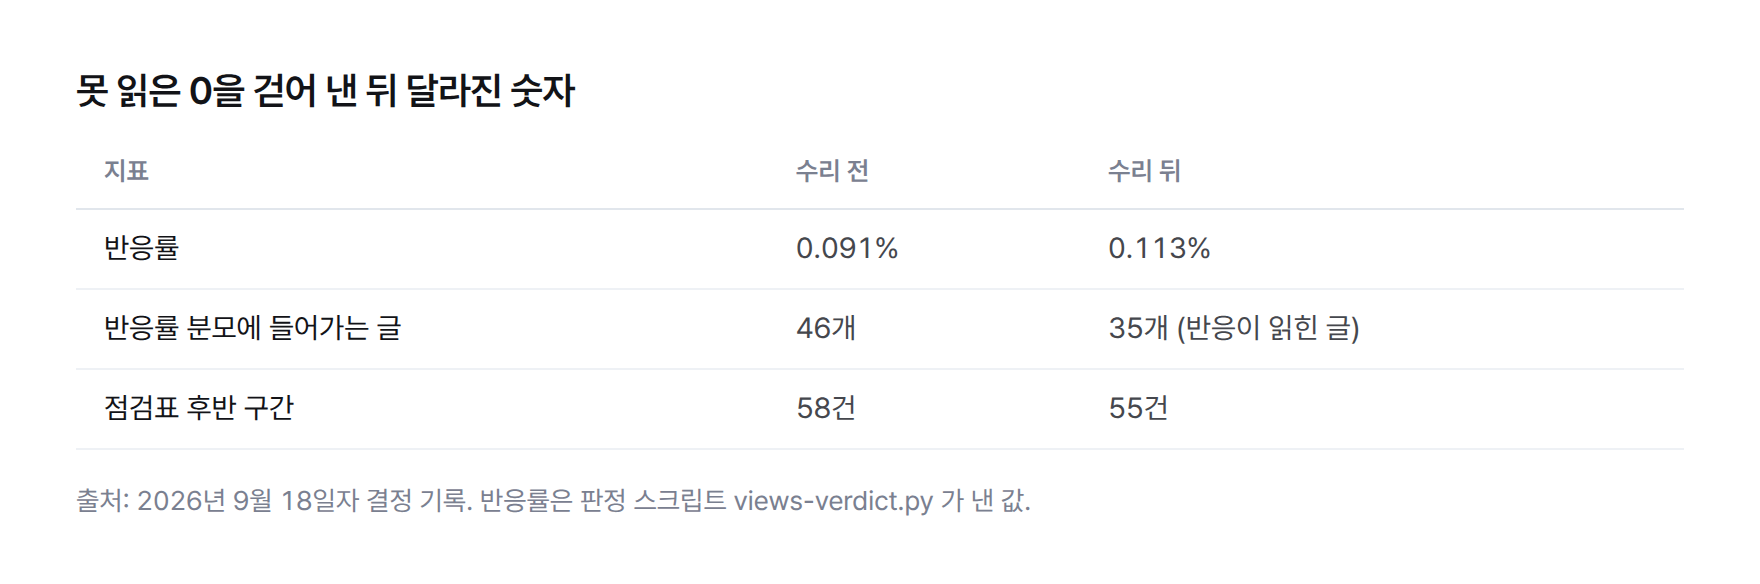
읽는 쪽도 고쳤습니다. 판정 스크립트 두 개(views-verdict.py·requirement-scorecard.py)가 like or 0 으로 좋아요를 읽고 있었습니다. 저장된 0이 측정값인지 기본값인지는 raw 에 like: 항목이 있는지로 되짚을 수 있어서, 이 규칙을 두 곳에 넣었습니다. 그 결과 반응률이 0.091%에서 0.113%로, 분모에 들어가는 글은 46개에서 반응이 읽힌 35개로, 점검표의 후반 구간은 58건에서 55건으로 바뀌었습니다.
고친 뒤에는 무엇으로 확인했나
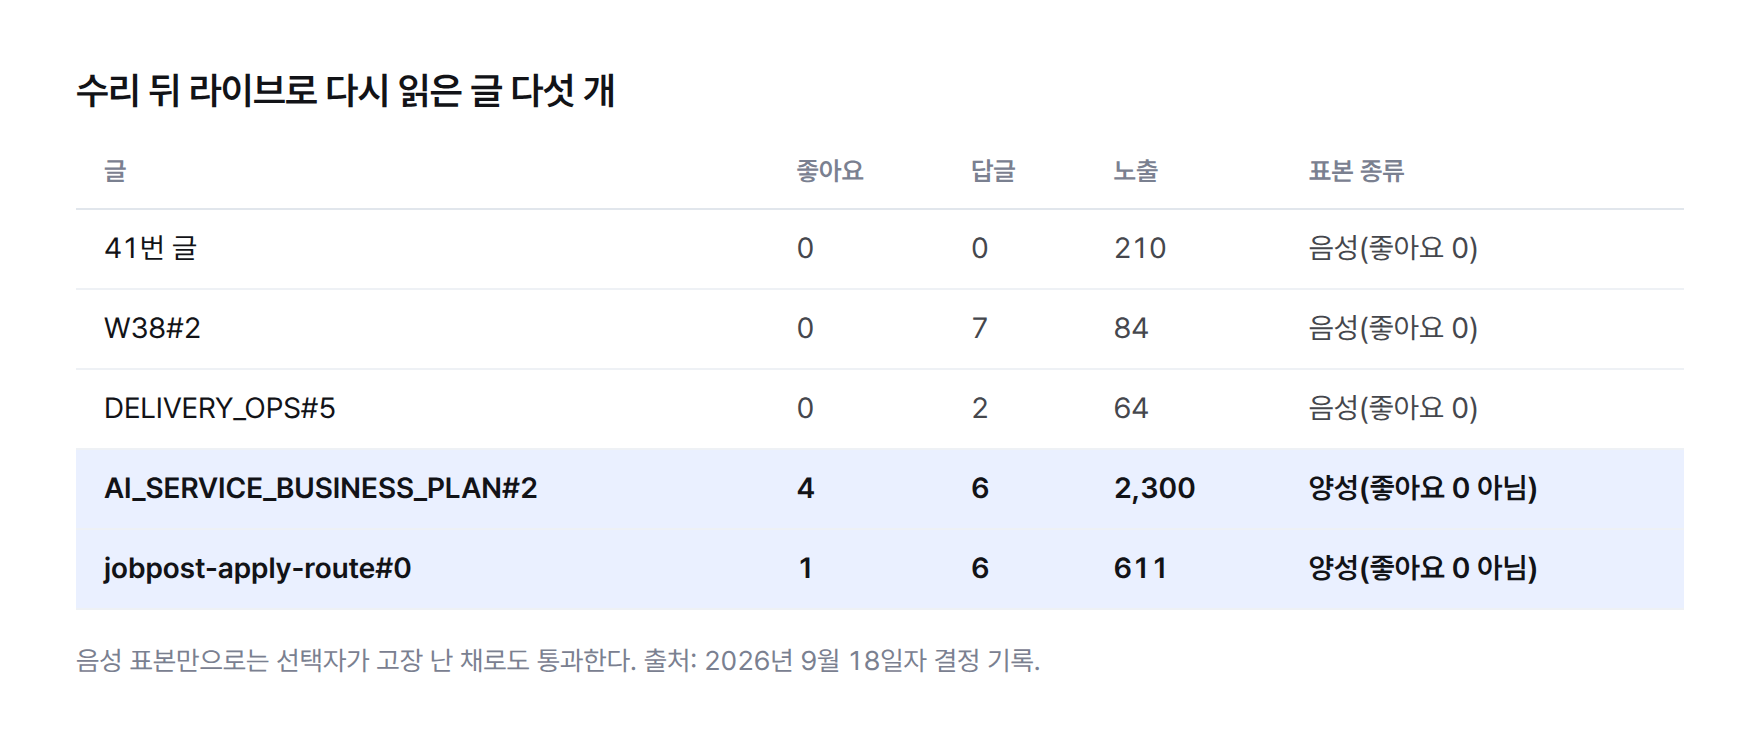
고친 선택자로 세 글을 다시 읽었습니다. 41번 글은 좋아요 0·답글 0·리포스트 0에 노출 210이었고 raw 에 like:, reply:, repost: 가 모두 돌아왔습니다. 전에는 읽기 자체가 실패하던 글입니다. 나머지 둘도 like: 항목이 돌아왔습니다.
여기서 멈추면 안 됐습니다. 세 글 모두 좋아요가 0이었기 때문입니다. 0만 확인하는 검증은 선택자가 고장 난 채로도 통과합니다. 좋아요가 0이 아닌 글에서 숫자가 실제로 나와야 «읽는다»고 말할 수 있습니다.
그날 07시 50분에 좋아요가 0이 아닌 옛 글 둘을 같은 선택자로 읽었고, 두 글 모두 숫자가 나왔습니다. 동료 답글 쪽은 이어서 07시 55분에 시험 실행(dry run)으로 확인했습니다. 로그인 벽 없이 통과했고 «좋아요 1 · 우리 답글에 달린 답글 1(작성자 답장)»이 읽혔습니다.
로그인이 풀린 구간에서는 측정이 왜 멈췄나
위 확인 도중 접속이 로그인 벽으로 떨어졌습니다. 그 일이 세 번째 구멍을 보여 줬습니다. 발행 경로는 ensure_login() 으로 저장해 둔 쿠키를 넣어 스스로 로그인을 되살립니다(발행 스크립트 안 네 자리, 영업 글 발행기, 동료 반응 탐색기). 측정기 둘은 이 함수를 부르지 않았습니다.
그래서 벽을 만나면 «로그인 벽»을 찍고 그 회차를 버렸습니다. 로그인이 풀린 구간에는 발행만 계속되고 측정은 멎는다는 뜻입니다. 숫자는 비어 가는데 아무 경고도 없는 모양이라, 좋아요를 못 읽은 결함과 같은 부류의 침묵입니다.
측정기 둘에 복구를 한 번씩 넣었습니다. 쿠키까지 죽었으면 정직하게 실패하고, 접속을 열 때 프로필에서 먼저 살립니다. 라이브 확인에서는 저장된 쿠키로 로그인을 되살리는 데 성공한 뒤 주인에게만 보이는 최근 조회수 49,000을 읽었고, 직전까지 실패하던 글 둘의 측정도 성공했습니다(41번 글 노출 211, 다른 글 노출 85).
같은 실수를 막는 장치는 무엇인가
선택자를 이중으로 넓히고 못 읽은 값을 null 로 두는 것은 같은 사고를 줄이는 수리입니다. 그러나 스레드가 화면을 또 바꾸면 이중 선택자도 둘 다 빗나갈 수 있습니다. 그때를 위해 «읽지 못하는 상태»를 스스로 알리는 감시기를 따로 세웠습니다.
- threads-metrics-stall — 마지막 측정이 30시간을 넘으면 울립니다.
- threads-metrics-blind — 최근 20건 중 5건 이상이 raw 에 like: 없이 0을 적었으면 울립니다.
- 단위 시험 5건 신규(선택자 두 자리·null 기본값·external_replies·실패 분기·중앙값이 미측정을 무시) + 판정 스크립트 시험 4건 추가
- 같은 패턴이 다른 스크립트에 더 있는지 svg[aria-label] 전수 검색으로 0건 확인
감시기는 만들자마자 실제로 울렸습니다. 최근 20건 중 14건이 조건에 걸려 있었습니다. 새 측정이 쌓여 9월 17일 구간이 밀려나면 저절로 꺼지는 구조라, 지금 울리는 것이 곧 감시기가 진짜 사고를 알아본다는 양성 표본입니다.
고치지 못한 것도 있습니다. 9월 17일 구간의 좋아요는 영구 미측정입니다. t24·t72 측정 창이 이미 지나서 다시 읽을 수 없습니다. 판정 스크립트가 raw 로 걸러내지만 기록 파일 자체는 그대로 둡니다. 다시 확인하려면 아래 명령을 돌립니다.
- python3 -m pytest collector/test_buildlog_metrics_icons.py collector/test_views_verdict.py -q
- python3 collector/views-verdict.py --phase t72
- python3 collector/buildlog-metrics.py compare
그림 실험은 아직 무엇을 말하지 못하나
이 글은 측정기가 못 읽은 값을 0으로 적던 사고의 기록이지, 그림이 반응을 올린다는 결론이 아닙니다. 그림 실험의 판정은 30일 뒤 비교 명령이 냅니다. 처리군이 겨우 한 건이라는 점도 바뀌지 않았습니다.
실험을 시작하기 전에 레퍼런스 계정 16곳의 최근 100건으로 쟀던 값에도 단서가 붙습니다. 좋아요 백분위 중앙값은 글자만 있는 글이 0.43, 이미지가 붙은 글이 0.53이었고 표본은 487개 대 60개, p=0.025였습니다. 그런데 같은 날 검수표를 만들다가 상위 이미지의 분류가 바뀌었습니다. 스크린샷은 14장에서 16장으로, AI 생성은 1장에서 «AI 생성·3D» 2장으로 정정했습니다. 그리고 1위와 2위 글의 좋아요가 493으로 같아서, 인용 글이 원글의 수치를 물고 오는지 확인하기 전까지 p=0.025 는 잠정입니다.
측정 결과를 받아 쓰는 쪽이라면, 자동화 업체가 «SNS 반응이 이만큼 올랐다»고 보고할 때 같은 방식으로 되물을 수 있습니다.
- 0이라는 숫자가 «측정해서 0»인지 «못 읽어서 0»인지 구분해서 저장하는가
- 반응이 전혀 없는 글이 집계에서 빠지지 않는가 — 분모에 들어 있는가
- 음성 표본(0)뿐 아니라 양성 표본(0이 아닌 글)으로 측정기를 확인했는가
- 측정이 멎으면 누가, 어떤 신호로 알아채는가
같은 측정기의 조회수 쪽 사정은 스레드 조회수 측정 글에 따로 적었습니다. 스레드나 블로그 자동 발행의 반응을 믿고 판단할 수 있는 상태로 만들고 싶다면 상담에서 지금 쓰는 측정 방식부터 같이 열어 볼 수 있습니다.