증상: 스레드 하루 게시물 수를 3건으로 묶어 둔 이유는 무엇이었나?
시작은 운영자의 질문 하나였습니다. "하루 3건 상한도 더 올리고 싶은데, 글 소재는 충분하지? 10개 정도로 올려도 돼?" 우리 스레드 계정은 하루에 체인 3개까지만 올리도록 묶여 있었습니다. 여기서 체인은 한 소재를 여러 개의 짧은 글로 이어 붙인 묶음이고, 그 안의 글 한 개를 조각이라 부릅니다.
3이라는 숫자는 감으로 정한 값이 아니었습니다. 2026년 8월 11일에 코퍼스를 재서 24에서 3으로 내린 값이었습니다. 당시 근거는 두 줄이었습니다. 비교 대상으로 삼은 계정(@programmingzombie)은 활동일 147일 동안 원글을 하루 중앙값 3건 올린다, 그리고 글을 많이 올리면 글당 반응이 떨어진다. 그래서 "벤치마크도 하루 3건 안팎이고, 물량으로 이기는 판이 아니다"라는 결론이 나왔습니다.
증상은 겉으로 드러나는 오류가 아니었습니다. 상한은 잘 지켜졌고 파이프라인도 멀쩡히 돌았습니다. 다만 실측으로 내린 값이라는 이유 하나로 그 뒤 누구도 다시 재지 않았고, 그 값이 발행 물량 전체를 묶고 있었습니다. 실측으로 정한 숫자는 인용해서 쓰기 쉬운 만큼, 틀렸을 때도 오래 살아남습니다.
처음 의심한 것: 글 소재가 모자라지 않을까
질문을 받고 가장 먼저 떠올린 가설은 소재 부족이었습니다. 상한을 올려도 올릴 글이 없으면 의미가 없고, 억지로 채우면 품질이 떨어집니다. 그래서 먼저 쌓여 있는 소재 재고를 셌습니다.
재고는 1,433건이었습니다. 하루 10건씩 꺼내 써도 143일치입니다. 소재 부족 가설은 여기서 바로 기각했습니다. 상한을 올리지 못할 이유가 재고 쪽에는 없었습니다.
그러면 남는 질문은 하나였습니다. 3이라는 상한 자체가 맞는가. 8월 11일 판정을 인용해서 "실측상 3이 맞다"고 답하면 편했겠지만, 그 판정 역시 그때 코퍼스로 잰 결과였고 코퍼스는 그사이 계속 늘었습니다. 인용이 아니라 재측정이 필요했습니다.
그래서 의심의 대상을 소재에서 옛 판정의 전제 두 개로 옮겼습니다. 하나는 "벤치마크 계정은 하루 3건 안팎으로 적게 쓴다", 다른 하나는 "물량을 늘리면 반응이 깎인다"였습니다. 둘 다 당시에는 데이터로 확인한 사실처럼 보였기 때문에, 각각을 따로 떼어 다시 재기로 했습니다.
확인에 쓴 수단: 같은 코퍼스를 같은 스크립트로 다시 세기
관측 수단은 따로 만들지 않았습니다. 발행 규칙을 정할 때 쓰는 코퍼스 분석 스크립트(collector/corpus-verdict-style.py)에 발행 빈도 모드(--cadence)를 붙여, 계정별로 하루에 몇 개를 올렸고 그날 반응이 얼마였는지를 셌습니다. 반응은 하트(♥) 수만 봤습니다.
두 가지를 나눠서 쟀습니다. 첫째, 비교 계정이 실제로 하루에 몇 개를 올리는가. 활동일, 하루 체인 수, 하루 글 수를 계정별로 뽑았습니다. 둘째, 많이 올린 날 반응은 어떻게 움직이는가. 여기서는 순위 상관계수(rho)로 물량과 반응의 관계를 계정마다 따로 계산했습니다. 계정마다 따로 잰 이유는 큰 계정과 작은 계정을 섞으면 계정 크기 차이가 물량 효과를 덮어 버리기 때문입니다.
반응 지표도 두 개를 나란히 놓았습니다. 하나는 8월 11일에 썼던 글당 반응, 다른 하나는 그날 올린 글 전체의 반응 합계입니다. 같은 데이터를 두 지표로 재면 둘이 같은 방향을 가리키는지 바로 드러납니다.
알리바이 ①: 벤치마크 계정은 정말 적게 썼나?
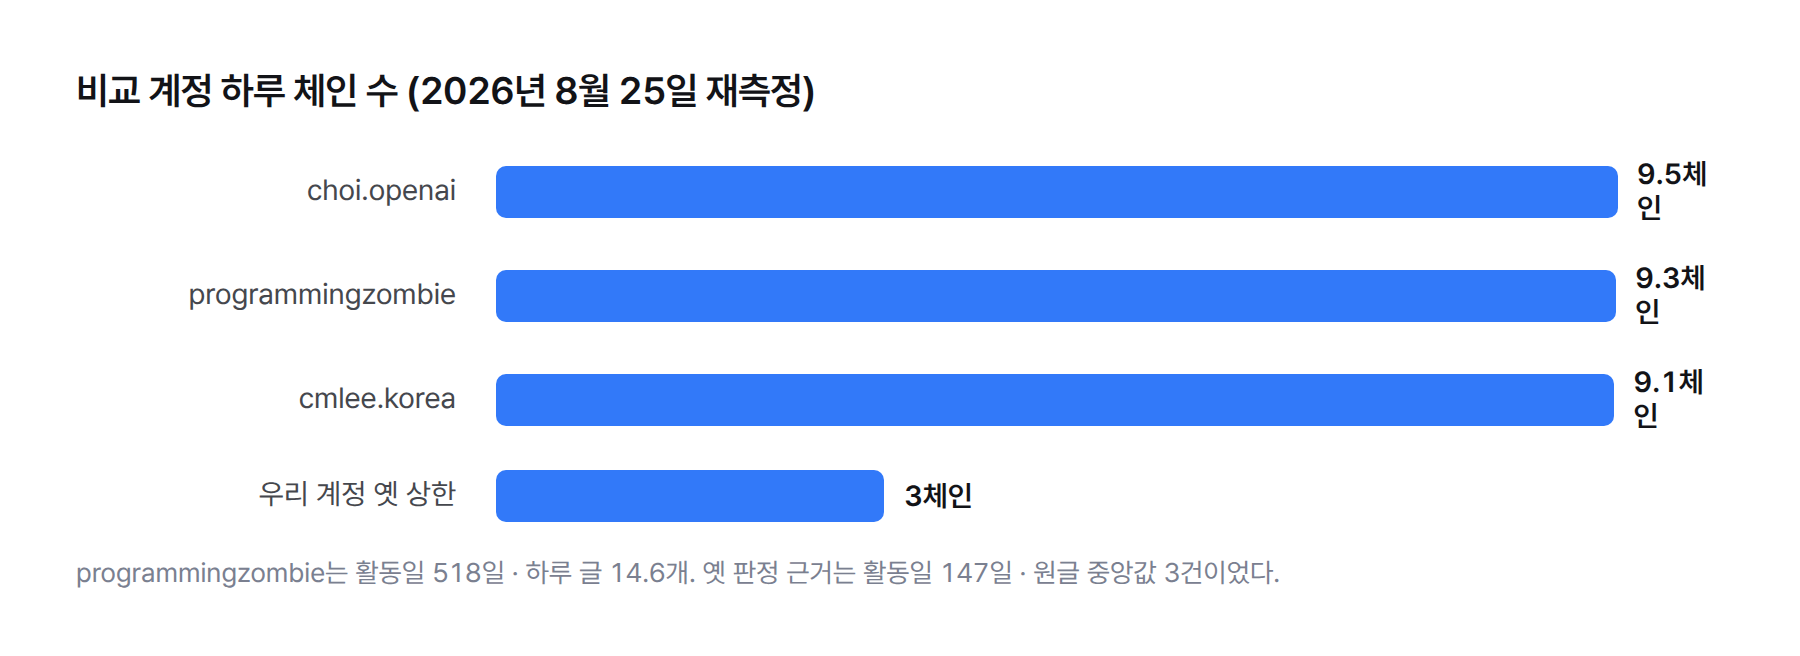
먼저 숫자부터 틀려 있었습니다. 8월 11일 근거였던 @programmingzombie를 지금 코퍼스로 다시 세면 활동일 518일, 하루 체인 9.3개, 하루 글 14.6개입니다. 활동일 147일·원글 중앙값 3건과는 전혀 다른 계정처럼 보입니다.
한 계정만의 특이값도 아니었습니다. cmlee.korea는 하루 9.1체인, choi.openai는 9.5체인으로, 상위 4계정 중 3계정이 같은 자리에 모여 있었습니다. "벤치마크가 우리보다 적게 쓴다"는 전제가 사실이 아니었던 셈입니다. 우리 상한 3은 비교 계정의 3분의 1 수준이었습니다.
왜 8월 11일에는 활동일 147일로 셌는지는 이 기록만으로 확인할 수 없습니다(확인 필요). 분명한 것은 같은 계정을 지금 세면 활동일이 518일로 3배 넘게 늘고, 하루 글 수도 중앙값 3건이 아니라 14.6개라는 점입니다. 판정의 뼈대였던 숫자가 지금 데이터와 맞지 않으니, 그 위에 세운 결론도 그대로 둘 수 없었습니다.
알리바이 ②: 글당 반응이 떨어지면 물량을 줄여야 하나?
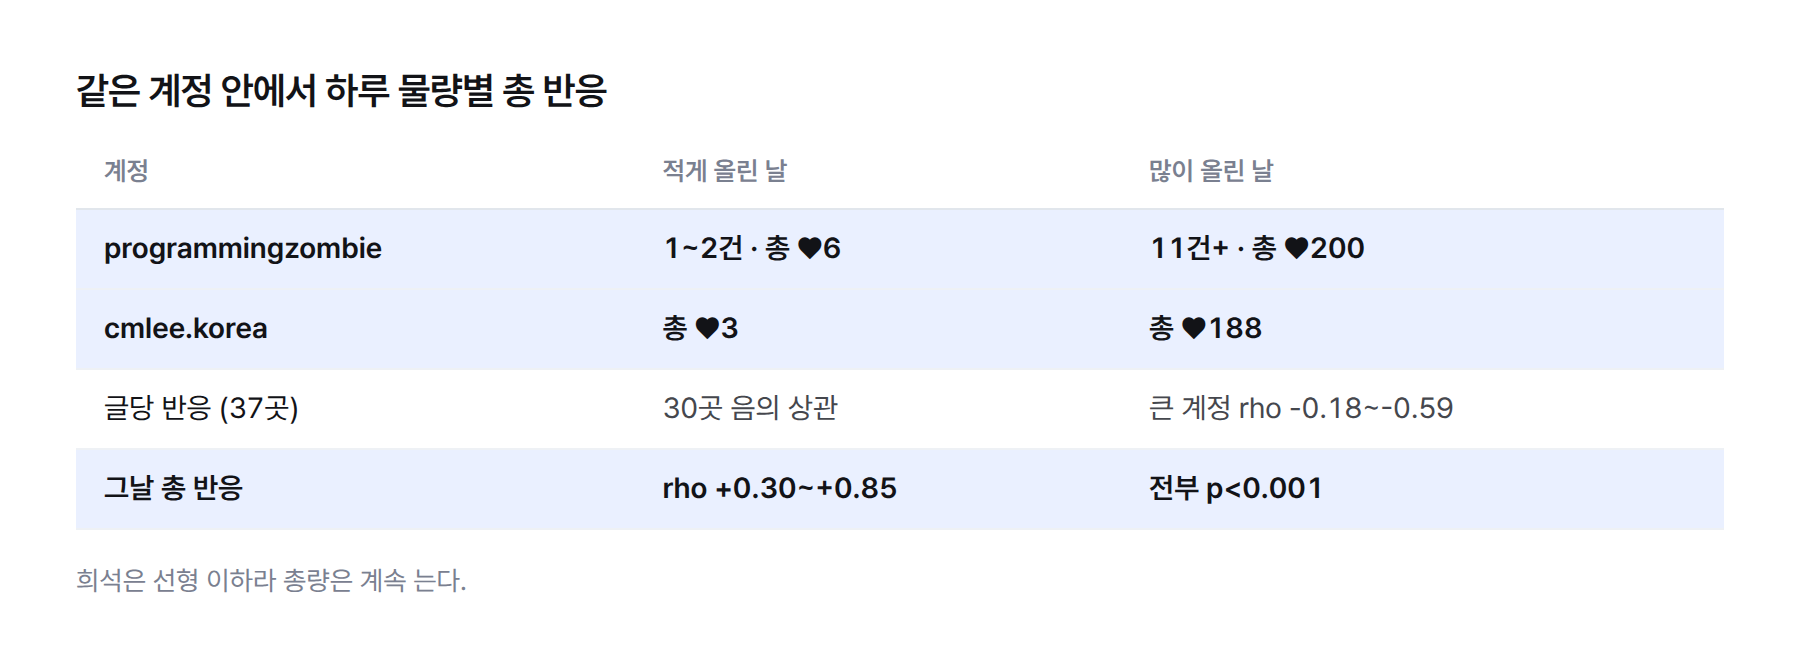
지표도 틀려 있었습니다. 8월 11일에는 글당 반응으로 판정했습니다. 글당 희석 자체는 실재합니다. 37개 계정 중 30개에서 물량과 글당 반응이 음의 상관을 보였고, 큰 계정은 rho -0.18~-0.59(p<0.001)였습니다. 이 부분만 보면 "많이 올리면 손해"라는 결론이 맞아 보입니다.
그런데 같은 계정 안에서 그날 총 반응을 보면 방향이 반대입니다. 물량과 함께 올라갑니다. rho +0.30~+0.85, 전부 p<0.001이었습니다. @programmingzombie는 1~2건만 올린 날 총 ♥6, 11건 넘게 올린 날 총 ♥200이었습니다. cmlee.korea는 같은 비교에서 ♥3에서 ♥188로 뛰었습니다.
두 결과는 서로 모순이 아닙니다. 글 한 개가 받는 반응은 줄어들지만, 줄어드는 속도가 물량이 느는 속도보다 느립니다. 희석이 선형 이하라서 총량은 계속 늘어납니다. 계정 운영에서 원하는 것은 글 한 개의 성적이 아니라 그날 계정이 받는 반응 전체이므로, 판정 지표로는 총 반응이 맞습니다. "물량으로 이기는 축이 아니다"라는 결론은 잘못 고른 지표에서 나왔습니다.
스레드에서 어떤 글이 반응을 받는지 유형별로 잰 기록은 스레드 바이럴 글 유형 측정에 따로 정리했습니다. 이번 글은 무엇을 올리느냐가 아니라 얼마나 올리느냐의 문제였습니다.
진짜 원인은 무엇이었나? 체인과 조각을 같은 단위로 셌다
두 알리바이를 확인한 뒤에도 "그럼 비교 계정처럼 하루 10체인으로 맞추면 된다"로 끝낼 수는 없었습니다. 체인 하나에 들어가는 조각 수가 우리와 비교 계정이 전혀 달랐기 때문입니다.
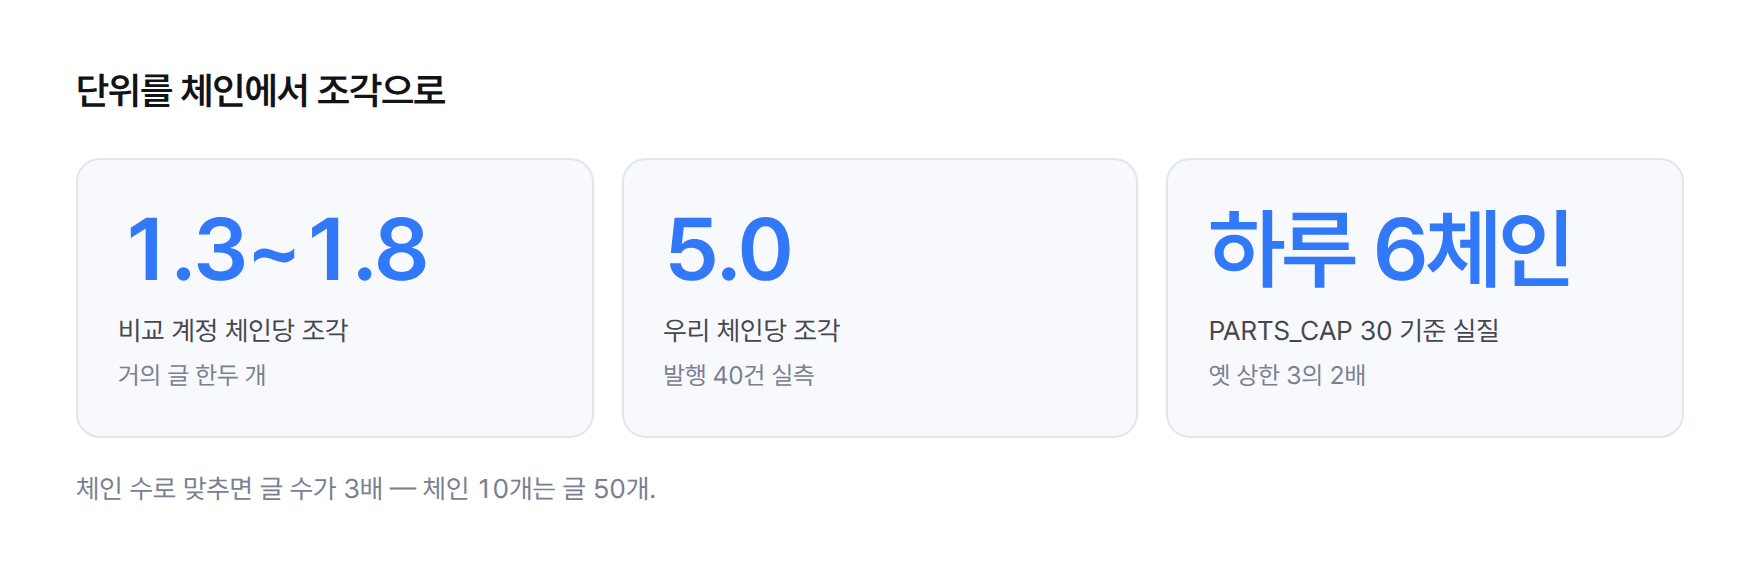
비교 계정의 체인은 평균 1.3~1.8조각입니다. 거의 글 한두 개짜리입니다. 우리 체인은 5.0조각입니다(발행 40건 실측). 체인 수로 맞추면 화면에 찍히는 글 수가 3배가 됩니다. 체인 10개면 글 50개입니다. 스레드의 봇 탐지가 세는 것은 소재 개수가 아니라 화면에 찍히는 글이므로, 상한은 체인이 아니라 조각에 걸어야 했습니다.
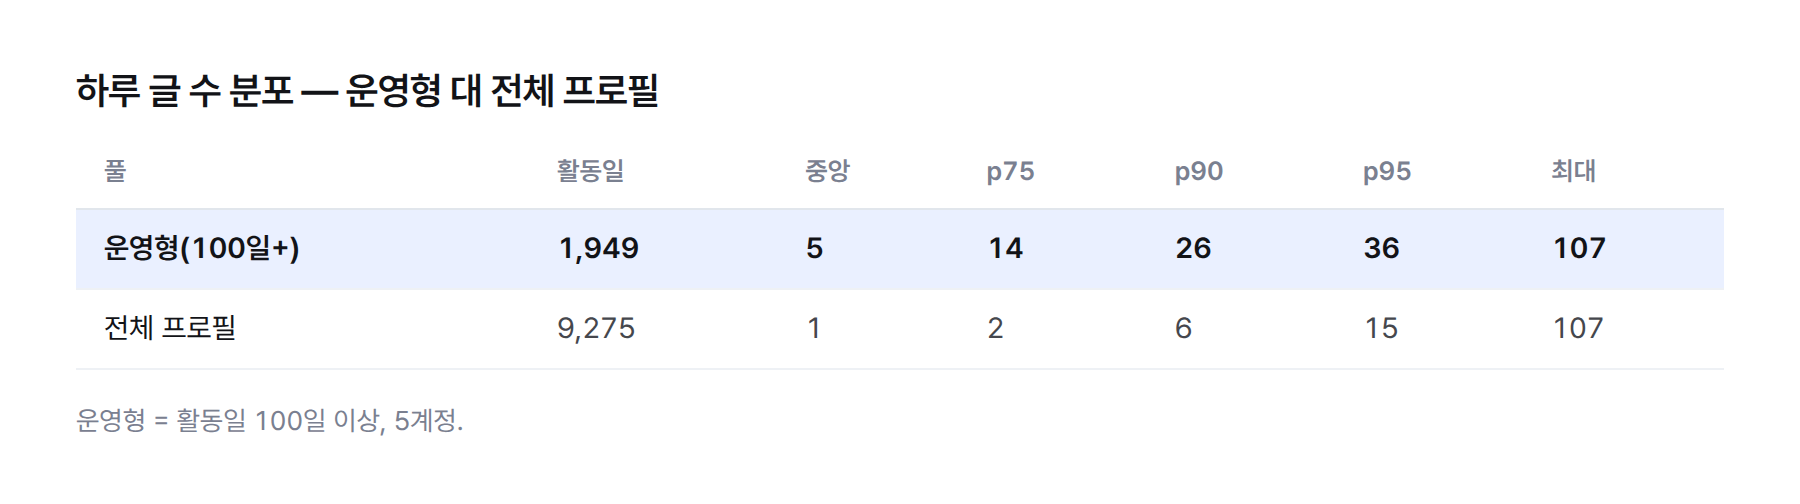
비교 대상을 고르는 방식에도 구멍이 있었습니다. 코퍼스 전체 프로필로 백분위를 내면 일주일에 한 번 쓰는 계정이 섞여 숫자가 눌립니다. 전체 프로필 9,275 활동일로 재면 하루 글 p90이 6인데, 활동일 100일 이상인 운영형 계정 5곳(1,949 활동일)만 재면 p90이 26입니다. 우리가 비교해야 할 대상은 매일 굴리는 계정이지 지나가는 계정이 아닙니다.
정리하면 원인은 세 겹이었습니다. 옛 숫자(147일·중앙값 3건)는 지금 코퍼스와 맞지 않았고, 지표(글당 반응)는 운영 목표와 어긋났고, 단위(체인)는 우리와 비교 계정 사이에서 뜻이 달랐습니다. 셋 중 마지막이 가장 오래 숨어 있었습니다. 앞의 두 오류만 고쳤다면 하루 체인 10개, 곧 글 50개를 올리는 설정이 나올 뻔했습니다.
어떻게 고쳤나? 체인 상한과 조각 상한 두 개를 걸었다
상한을 두 개로 나눴습니다. 체인 수 상한 DAILY_CAP은 3에서 10으로 올리고, 조각 수 상한 PARTS_CAP 30을 새로 만들었습니다. 둘 중 먼저 닿는 쪽이 그날 발행을 끝냅니다.
30은 운영형 계정 하루 글 수의 p90(26)과 p95(36) 사이에서 골랐습니다. 매일 굴리는 계정들의 상위권 안쪽입니다. 현행 체인 길이 5조각 기준으로 계산하면 실질 상한은 하루 6체인입니다. 기존 3체인의 2배이지 10배가 아닙니다. 운영자가 말한 10체인은 체인이 짧게 나오는 날에만 닿습니다.
운영자가 제안한 대로 체인 상한만 10으로 올렸다면 어땠을지도 계산해 봤습니다. 우리 체인은 5.0조각이므로 체인 10개는 글 50개입니다. 운영형 계정의 하루 글 수 p95가 36이니, 50은 매일 굴리는 계정들 가운데서도 상위 5% 바깥에 놓이는 물량입니다. 체인 상한만 올리는 안은 그래서 기각했고, 조각 상한을 따로 둬서 이런 날이 나오지 않게 막았습니다.
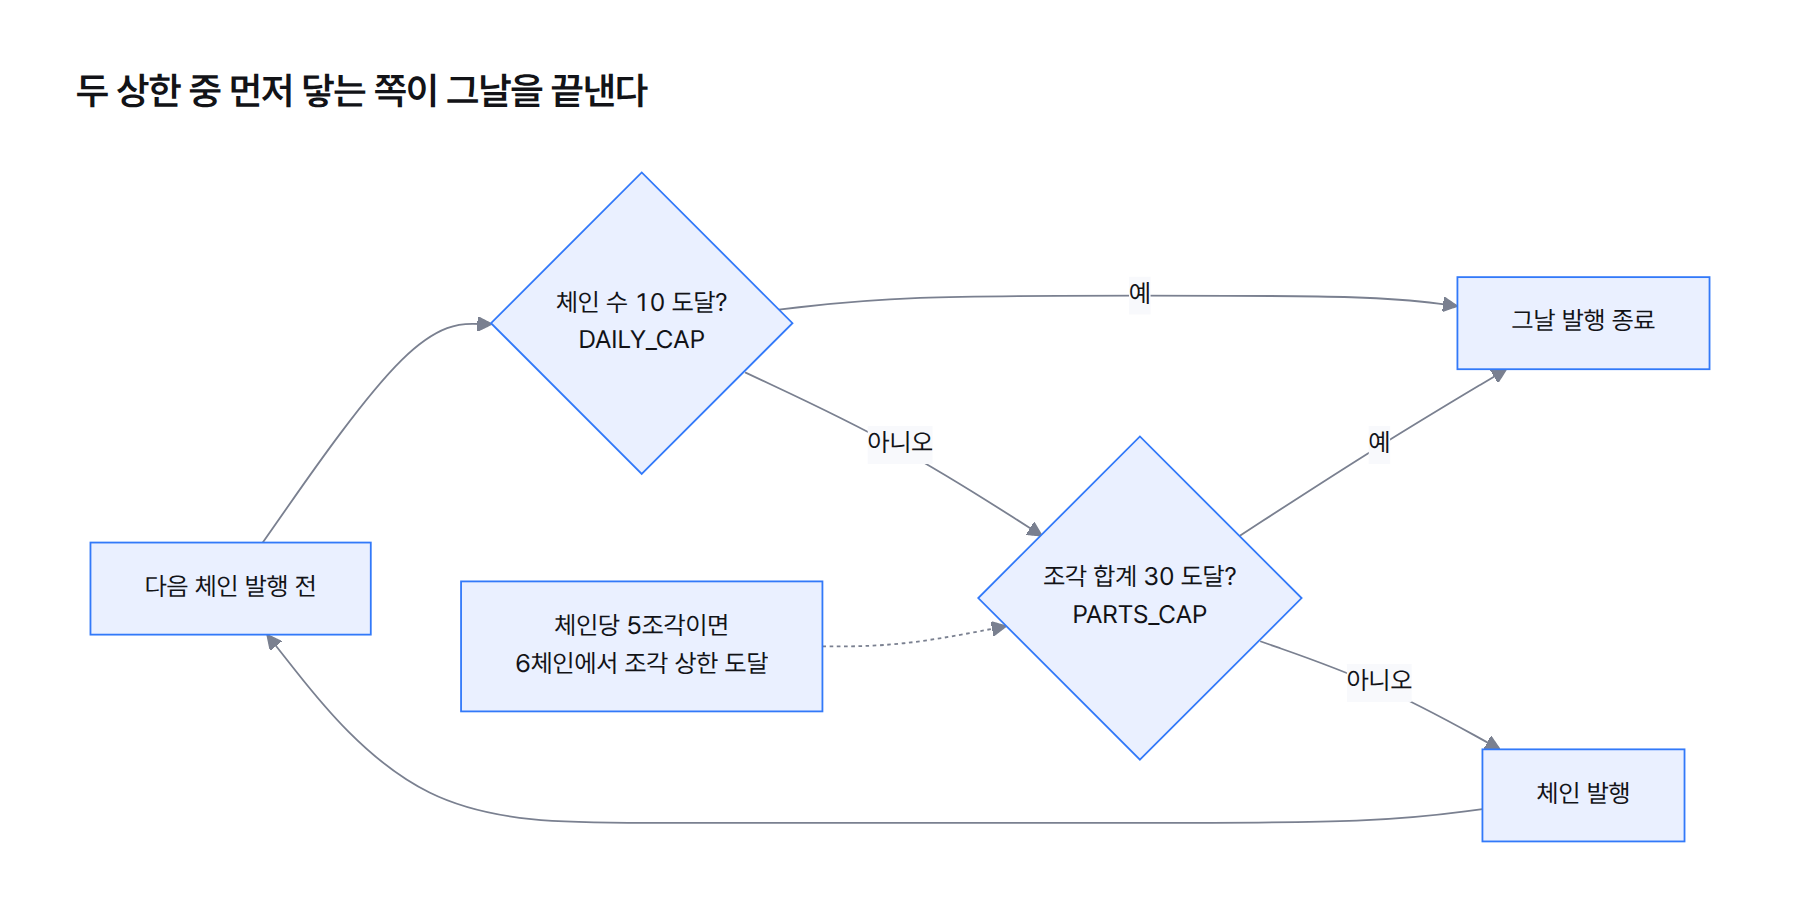
이 구조의 장점은 상한이 체인 길이에 맞춰 움직인다는 점입니다. 앞으로 체인을 더 짧게 쓰면 같은 30조각 안에서 더 많은 소재가 나갑니다. 체인을 길게 쓰면 자동으로 체인 수가 줄어듭니다. 단위를 조각에 걸어 두었기 때문에 체인 길이가 바뀔 때마다 상한을 다시 계산할 필요가 없습니다.
같은 실수를 막는 장치는 무엇인가?
첫째, 비교 대상을 규칙으로 못 박았습니다. 활동일 100일 이상인 계정만 운영형으로 보고, 발행 빈도 판정은 이 코호트로만 합니다. 다음에 누가 재측정해도 주 1회 쓰는 계정이 섞여 백분위가 눌리는 일이 다시 생기지 않습니다.
둘째, 재측정 명령을 판정 기록에 함께 남겼습니다. python3 collector/corpus-verdict-style.py --cadence 한 줄이면 같은 숫자를 다시 뽑을 수 있습니다. 이번 오류는 실측값을 인용만 하고 다시 재지 않아서 생겼으므로, 인용하기 전에 한 번 돌리는 비용을 최대한 낮춰 두는 쪽을 택했습니다.
셋째, 되돌릴 조건을 미리 정했습니다. 이 판정은 반응(♥)만 봅니다. 물량이 늘 때 스레드가 계정 도달을 조용히 누르는지(shadow throttling)는 이 코퍼스로 잴 수 없습니다. 관측할 수 있는 대리 지표는 우리 계정의 글당 반응 중앙값이고, 상한을 올린 뒤 이 값이 더 내려가면 되돌립니다. 다만 지금은 중앙값이 0이라 더 내려갈 자리가 없습니다. 이 한계는 숨기지 않고 판정 기록에 그대로 적었습니다.
돌아보면 가장 위험했던 순간은 "실측으로 내린 값"이라는 말이었습니다. 실측이라는 딱지가 붙으면 다시 볼 이유가 사라집니다. 이번에는 소재 부족이라는 엉뚱한 가설을 먼저 기각하는 과정에서 원래 판정을 다시 열었고, 그 덕분에 숫자·지표·단위 세 군데의 오류를 한 번에 찾았습니다. 자동 발행이나 콘텐츠 운영 규칙을 데이터로 정하는 일이 필요하다면 상담으로 연락 주셔도 좋습니다.