스레드 마케팅 글이 읽히는데 좋아요가 0이면 무엇이 문제인가?
스레드 마케팅에서 글이 읽히는데 좋아요가 0이라면, 먼저 의심할 곳은 문장이 아니라 무엇에 대해 쓰느냐다. 우리 계정이 정확히 그 경우였다. 9월 7일에 노출을 재 보니 발행한 글은 노출 102에서 488 사이로 읽히고 있었고 좋아요는 0이었다. 글이 안 보인 상황이 아니라, 보고도 누르지 않은 상황이었다.
이 글은 그 원인을 추적한 기록이다. 처음 잰 숫자, 세운 가설, 가설이 틀린 지점, 진짜 원인, 고친 내용, 재측정 계획, 남는 한계 순서로 적는다. 결론부터 말하면 원인은 글솜씨도 첫 문장도 아니었다. 글감을 뽑는 출처 파일이 전부 회의록이었고, 회의록에서 뽑으면 글은 구조적으로 자동화 내부 이야기로 흘러간다. 그 주제는 좋아요 중앙값이 가장 낮은 쪽에 있다.
스레드 마케팅을 막 시작한 사람이라면 우리와 같은 상황에 놓일 수 있다. 계정은 매일 돌아가고, 노출 숫자는 나오고, 좋아요 칸만 비어 있다. 이때 숫자가 알려 주는 사실은 글이 읽혔다는 점 하나다. 왜 안 눌렀는지는 숫자 밖에 있으니 비교 대상을 따로 모아야 알 수 있다. 우리가 한 일은 그 비교 대상을 모으는 것이었다.
글이 안 먹힐 때는 첫 줄부터 의심하기 쉽고, 우리도 그랬다. 첫 문장(오프너)을 고치고 검사 단계를 세 층이나 얹은 내역이 기록에 남아 있다. 그런데도 이 축은 움직이지 않았다. 고칠 곳을 잘못 짚으면 고치는 만큼 시간만 든다.
반응이 낮다는 신호는 이전에도 있었다. 8월 31일 기록에는 발행 49건의 반응이 좋아요 30, 답글 8이라서 글 한 건당 0.6이라고 적혀 있다. 그때는 도달이 원인이라고 읽었다. 9월 7일에 노출을 직접 재자 다른 그림이 나왔다. 도달은 되고 있었고, 반응만 없었다. 숫자 하나가 원인 후보를 한 칸 옮겼다.
비용은 시간만이 아니다. 이 계정은 사람이 쓰지 않고 프로그램이 글을 만들어 올린다. 주제가 틀리면 프로그램이 틀린 방향으로 글을 계속 쌓는다. 하루 발행 상한은 10으로 잡혀 있고, 9월 7일부터 11일까지 닷새 동안 올린 글만 21편이다.
처음 잰 숫자: 어떤 주제의 글이 좋아요를 받는가?
비교 기준이 먼저 필요했다. 측정 방법은 이렇다. 같은 판에서 수집한 스레드 검색 표본(수집 표본 파일에서 출처 종류가 스레드 검색인 글)을 주제별로 나누고, 글이 150건 이상 모인 주제만 골라 좋아요 중앙값을 냈다. 평균이 아니라 중앙값을 쓴 이유는 소수의 터진 글이 평균을 끌어올리기 때문이다.
| 상위 주제 (표본 수) | 좋아요 중앙값 | 하위 주제 (표본 수) | 좋아요 중앙값 |
|---|---|---|---|
| AI 챗봇 (539) | 275 | AI 에이전트 (1,261) | 37 |
| 챗GPT (1,462) | 195 | AI 자동화 (1,278) | 30 |
| 사이트 제작 (564) | 133 | 검색광고 (584) | 27 |
| 외주 (1,216) | 116 | 컨설팅 (157) | 21 |
| 앱 제작 견적 (584) | 115 | 창업 (1,709) | 20 |
괄호 안은 그 주제로 분류한 글의 수다.
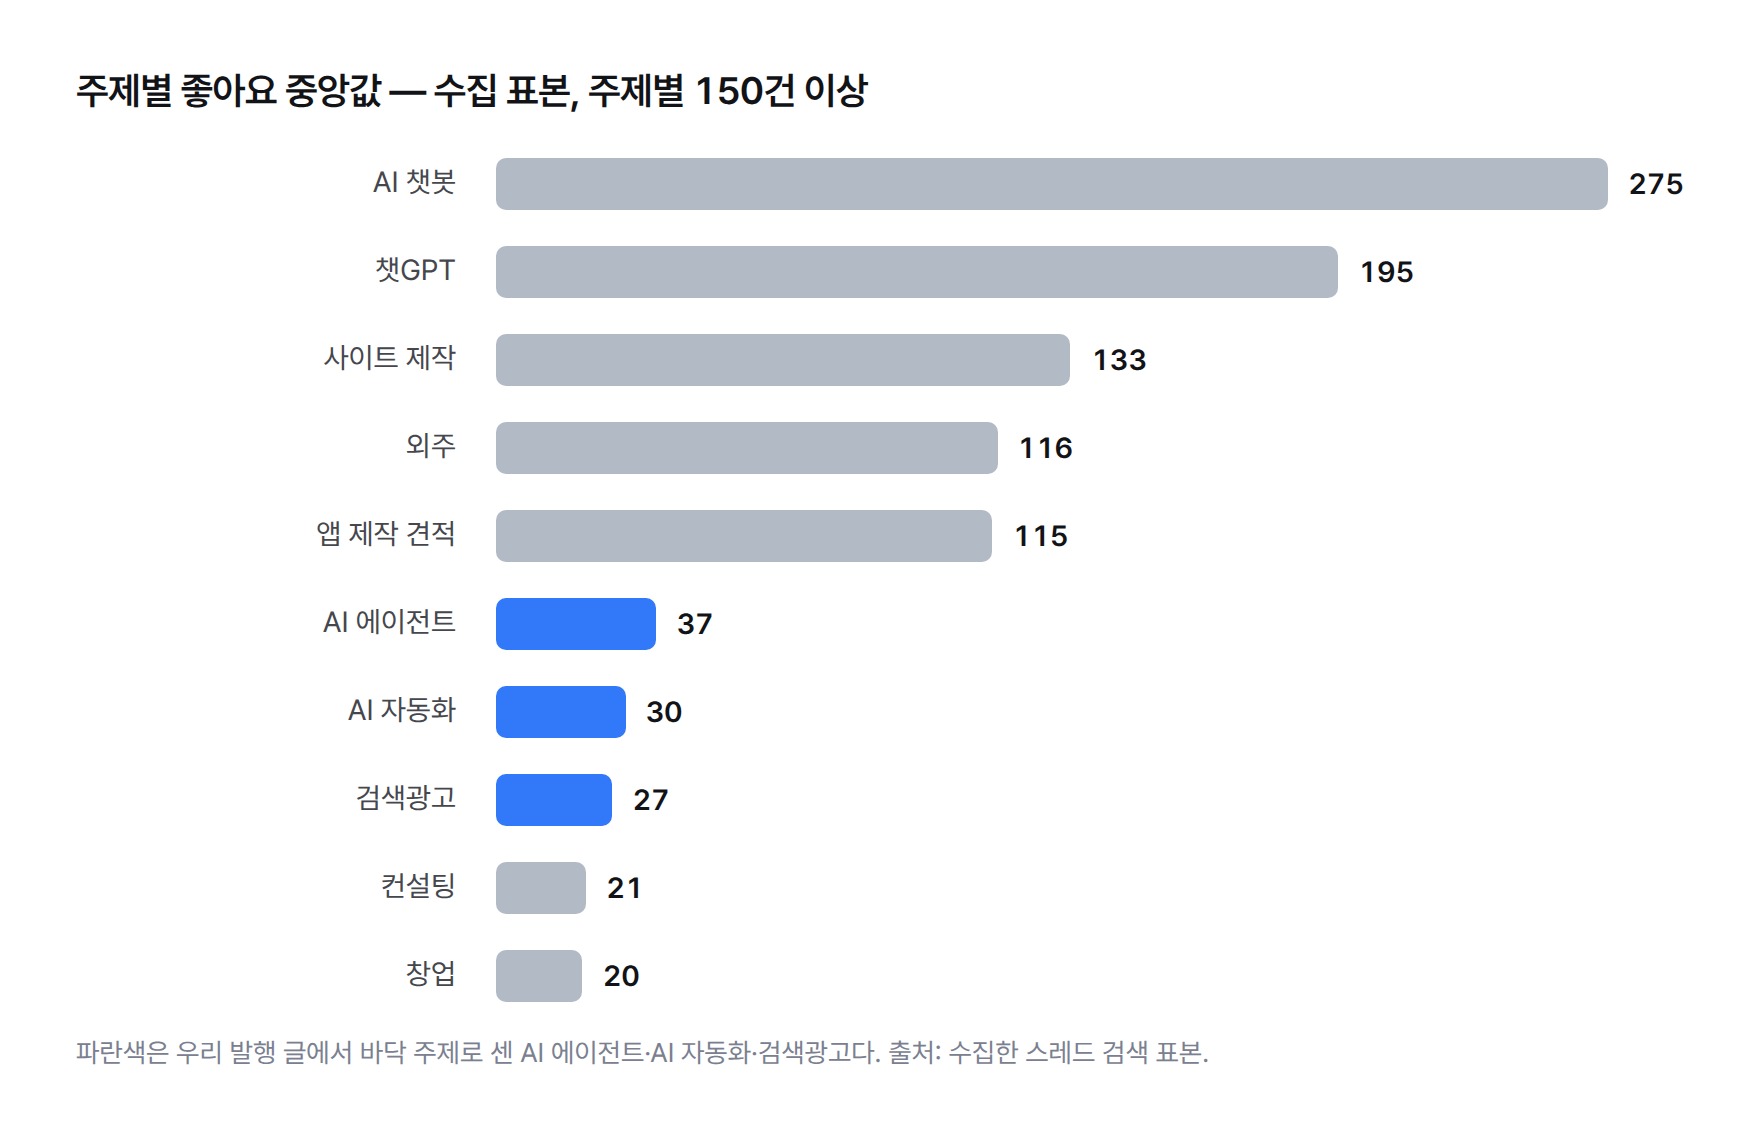
위쪽 다섯 주제는 AI 챗봇 275, 챗GPT 195, 사이트 제작 133, 외주 116, 앱 제작 견적 115다. 아래쪽 다섯은 AI 에이전트 37, AI 자동화 30, 검색광고 27, 컨설팅 21, 창업 20이다. 표본 크기가 중앙값을 설명하지도 않는다. 컨설팅은 157건으로 가장 작은데 21이고, 챗GPT는 1,462건인데 195다. 주제 자체가 반응의 높이를 가른다.
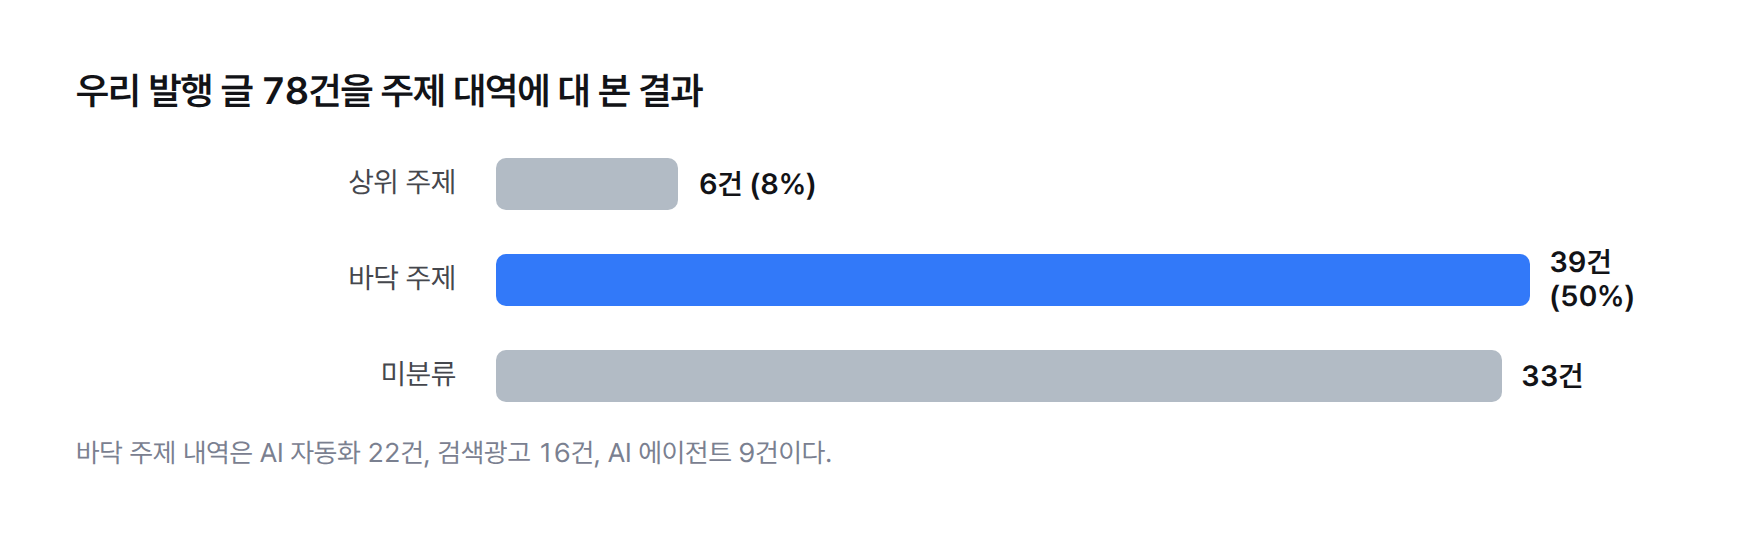
이 대역에 우리 발행 글 78건을 대 봤다. 상위 주제에 걸린 글이 6건(8%), 바닥 주제에 걸린 글이 39건(50%), 어느 쪽에도 안 들어가는 미분류가 33건이었다. 바닥 39건의 내역은 AI 자동화 22건, 검색광고 16건, AI 에이전트 9건이다. 세 내역을 더하면 39건을 넘는데, 한 글이 두 주제에 걸칠 때 양쪽에서 센 것으로 짐작한다(추정: 기록에 중복 처리 설명이 없다).
우리 기록 안에서도 방향이 같았다. 사업·시장 도메인(성장·리서치·매매) 40건은 글 한 건당 좋아요가 0.42였고, 자동화 내부 도메인(운영 체계·에이전트 운영·하네스·최신 동향) 33건은 0.18이었다. 다만 두 값의 차이를 Fisher 검정으로 보니 양측 p=0.123이다. 우리 표본만으로는 판정하지 않기로 했다. 방향만 적어 두고, 판정은 수천 건짜리 수집 표본 쪽에 맡긴다. (일반 지식) Fisher 검정은 두 그룹의 비율 차이가 우연히 생길 확률을 재는 방법이고, 0.123이면 우연으로 설명할 여지가 아직 크다.
세운 가설: 문장·유형·전문성을 고치면 되는가?
처음 세운 가설은 셋이었고, 셋 다 글 안쪽을 고치는 방향이었다. 출처는 충분하고 가공 방법이 문제라는 같은 전제 위에 서 있었다.
- 가설 1 — 글 유형이 문제다. 9월 1일에 같은 방식으로 재 보니 우리 발행 53건 중 실패·자백형이 41.5%였고, 수집 표본에서는 그 유형이 1.8%였다. 우리가 23배 많이 쓰는 유형이었다. 경험담 평문도 우리 54.7%, 표본 18.5%였다. 반대로 번호·불릿 리스트는 우리 0%, 표본 3.7%였다.
- 가설 2 — 전문성이 부족하다. 9월 4일 점검에서 발행 68건 중 64건(94퍼센트)에 전문 용어가 한 개도 없었다. 출처를 세어 보니 결정문 32건, 실측 26건, 자산 7건, 원고 3건이었고 코드에서 온 글은 0건이었다. 그래서 코드 구현 설명을 글감으로 여는 출처를 새로 만들었고, 소재 71건을 확보했다.
- 가설 3 — 첫 문장과 검사 단계가 문제다. 검사 단계를 세 층으로 얹고 첫 문장 작성 방식을 고쳤다.
가설 1은 반증하기 쉬워 보였다. 9월 1일 기록은 이미 스스로 반증 조건을 적어 뒀다. 다음 발행 20건에서 리스트 보유율이 0%에서 50% 이상으로 오르고 실패·자백 비중이 41.5%에서 20% 아래로 내려가는지 본다는 것이고, 안 내려가면 프레이밍이 아니라 소재 출처가 원인이니 출처를 바꾼다고 못 박았다. 6일 뒤 우리는 실제로 출처로 내려갔다. 그 20건 판정 결과 자체는 이 글이 본 기록에 없다.
수정이 늘 매끄러웠던 것도 아니다. 9월 1일에 유형 지시를 프롬프트에 27줄 더 얹었더니 새 지시가 기존 지시와 같은 동사(끊어라와 나눠라)를 써서 충돌했고, 실행한 세 번 모두 반려당해 발행이 0건이었다. 지시를 17줄로 줄이고 충돌 지점을 적은 뒤에야 8조각, 1,399자짜리 초안이 통과했다. 이 한 건만으로는 유형이 바뀐 증거로 쓸 수 없다. 막히지 않는다는 확인일 뿐이다.
가설이 틀린 지점: 전문성을 올렸더니 주제가 독자 없는 쪽으로 밀렸다
세 가설은 각자 다른 모양으로 어긋났다. 어긋난 자리를 숨기지 않고 하나씩 적는다.
- 전문 용어는 반응을 올리지도 내리지도 않았다. 같은 작성자와 비슷한 길이로 글을 짝지어 비교한 결과, 기술어가 있는 쪽이 이긴 짝과 없는 쪽이 이긴 짝이 516 대 522였다. 짝은 1,078쌍이다. 개발·AI 빌더 계정 18곳(14,563건)으로 좁히면 355 대 355, 짝 729쌍으로 정확히 비겼다. 통계적으로 낮다는 판정(p=0.026, 0.040)은 방향이 아니라 꼬리 크기에서 나왔다.
- 첫 문장과 검사 단계는 이 축을 움직이지 못했다. 세 층을 얹고 첫 문장을 고쳐도 주제의 분포는 그대로였다.
- 전문성을 올리려고 연 출처가 주제를 밀었다. 구현·소식 출처를 열자 자동화 내부 글의 비중이 8월 중순 43%에서 9월 상순 72%로 늘었다.
짝지어 비교하는 방식을 풀어 쓰면 이렇다. 같은 작성자가 같은 수집 경로로 올린 글 중 길이가 ±25% 안에 드는 두 글을 한 짝으로 묶고, 기술어가 있는 글과 없는 글 중 어느 쪽이 좋아요를 더 받았는지 센다. 작성자와 길이가 같으니 주제 외의 차이가 줄어든다. 통제 없이 비교하면 결과가 정반대로 보이는 경우가 있어서(실패담은 통제 없는 비교에서 중앙 29 대 4로 압도적이었다) 이 방식을 썼다.
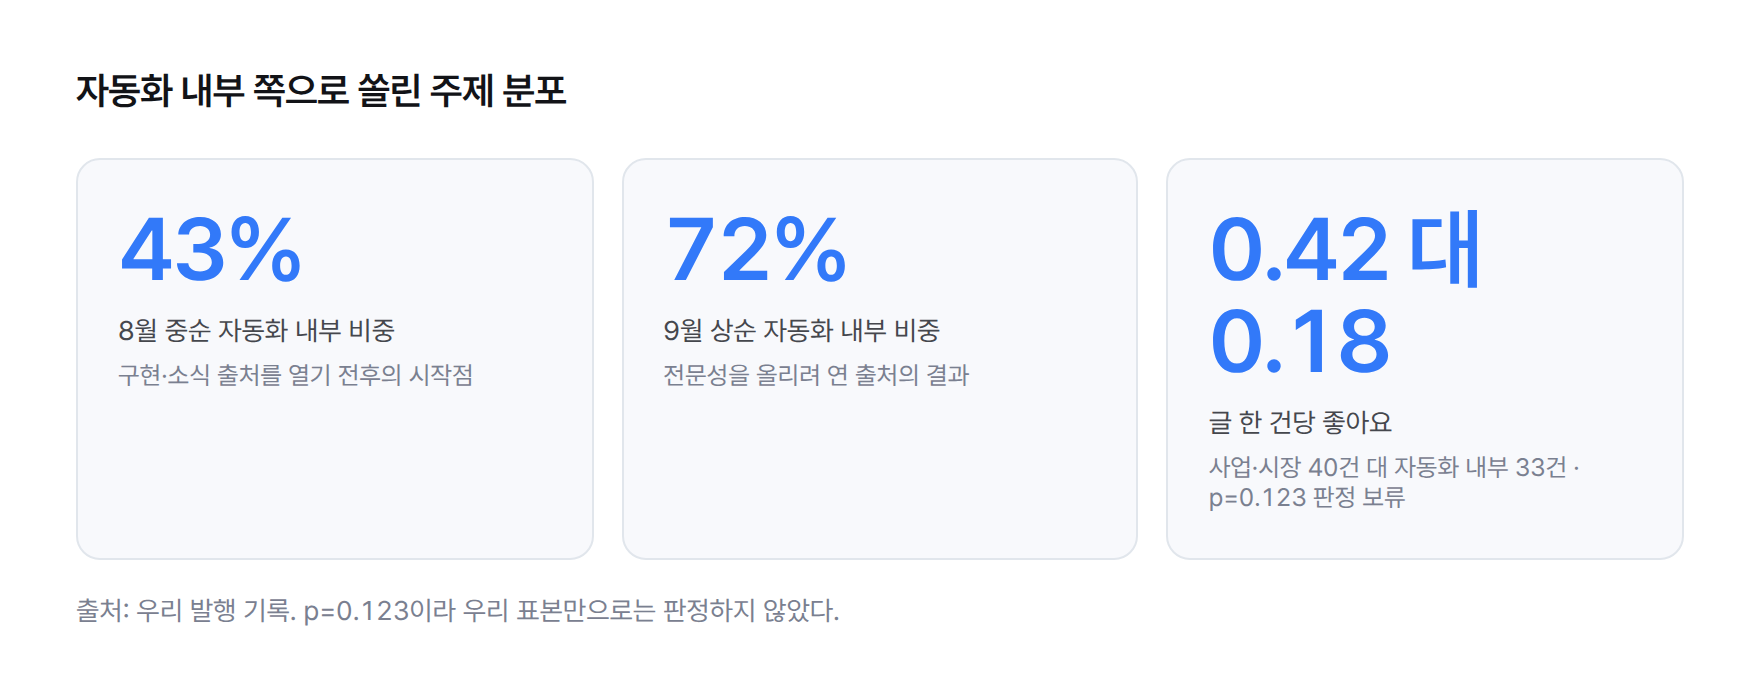
세 번째가 가장 쓰라렸다. 전문성이 부족하다는 진단은 맞았다. 그래서 고쳤다. 그런데 고친 방법이 독자가 없는 쪽으로 주제를 밀어 버렸다. 우리는 반응을 올리려고 한 일이 오히려 비중을 43%에서 72%로 끌어올린 셈이다. 개별 수정은 모두 합리적이었고, 합쳐서 틀렸다.
돌아보면 단서는 일찍부터 있었다. 가설 1과 가설 2는 모두 우리 발행분의 모양을 수집 표본의 모양에 맞추려는 시도였고, 맞추는 대상은 글의 겉모양(유형·용어)이었다. 그런데 글의 겉모양은 소재가 정한다. 실패담이 41.5%였던 이유도, 리스트가 0%였던 이유도 소재가 회의록이어서라고 보는 쪽이 설명이 간단하다(추정: 소재와 유형의 인과는 이 기록에서 직접 시험하지 않았다).
이 지점에서 가설의 방향 자체를 바꿔야 했다. 글 안쪽을 더 고치는 대신, 글이 어디서 나오는지를 봐야 했다.
진짜 원인은 무엇이었나? 글감 출처가 전부 회의록이었다
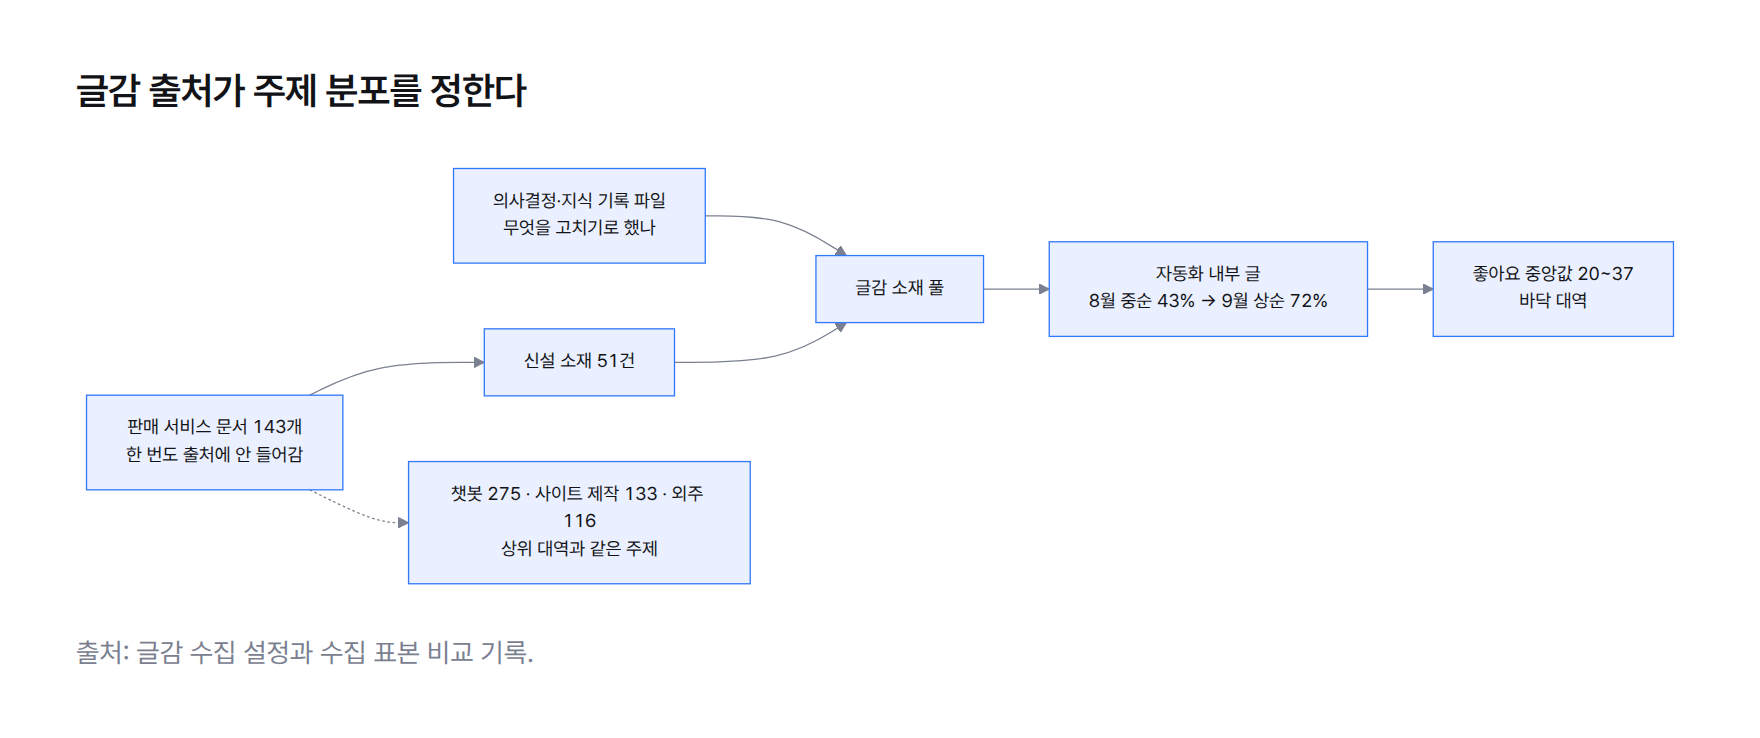
글감을 뽑는 스크립트의 출처 목록은 여러 저장소의 의사결정 기록 파일과 지식 기록 파일뿐이었다. 전부 무엇을 고치기로 했나를 적은 기록이다. 기록에서 뽑은 소재로 글을 쓰면 글은 구조적으로 자동화 내부 이야기로 흘러간다. 사람이 아무리 문장을 다듬어도 소재 자체가 그쪽에 있다.
출처가 한 종류뿐인 상태는 눈에 잘 안 띈다. 프로그램은 매일 정상으로 돌고, 검사도 통과하고, 글도 발행한다. 오류가 나지 않으니 아무도 출처를 의심하지 않는다. 주제 분포를 처음 잰 날에야 우리 글 78건 중 절반이 바닥 주제라는 사실이 드러났다.
한 번도 출처에 들어간 적 없는 문서가 따로 있었다. 우리가 직접 쓴 판매 서비스·구축·견적 문서가 저장소 루트에 143개 있었다. 그리고 그 주제는 정확히 수집 표본의 상위 대역이었다. 챗봇 275, 사이트 제작 133, 외주 116은 우리가 파는 AI 챗봇, 홈페이지 제작, 업무 자동화와 같은 말이다. 독자가 몰리는 자리와 우리가 파는 자리가 겹치는데, 그 자리를 출처 목록에서 비워 둔 채로 글을 쓰고 있었다.
이 모양은 처음이 아니다. 기록은 이번을 세 번째 재발로 센다. 앞선 두 번은 8월 31일(출처의 절반이 연결되지 않았다)과 9월 4일(출처에 코드가 0건이었다) 기록으로 짐작한다(추정: 기록에 재발 횟수 목록은 없다). 문제가 보이면 검사 단계를 더하고 싶어지지만, 이 축은 게이트가 아니라 출처가 정했다.
조치: 판매 서비스 문서 143개를 글감 출처로 열었다
조치는 단순하다. 판매 서비스 문서 143개를 글감 출처에 새로 넣었다. 다만 넣는 방법에 규칙을 달았다.
- 소재 51건을 새로 뽑았다. 내역은 챗봇 화면 설계 7건, 홈페이지 점검 9건, 진료소 사이트 8건, 서비스 운영 5건 등이다.
- 시장조사, 업계 지형 정리, 스캔 결과, 빈 서식은 뺐다. 남의 수치를 1인칭으로 쓰면 앞서 겪은 사고, 곧 타인의 분석을 우리 경험인 것처럼 발행한 일이 그대로 되살아난다.
- 글감을 고르는 순서에서 이 출처를 1순위로 올렸다.
- 상태 집계(재고 수)에도 이 출처를 넣었다. 재고 2,778건이 전부 자동화 내부라는 사실을 다음 사람이 숫자로 볼 수 있게 했다.
- 테스트 4건을 새로 만들고 기존 회귀 248건이 전부 통과한 뒤 합쳤다.
제외 규칙은 이전 경험에서 왔다. 9월 4일에 코드 구현 출처를 열었을 때, 열자마자 소재 71건을 전수로 훑었더니 8건에서 남의 계정 핸들이, 2건에서 채널별 리드 수율 같은 영업 내부 수치가 나왔다. 그대로 두면 라이브 사이클이 그 소재를 쓰고 있었을 것이고, 소재 단계에서 빼서 61건으로 줄였다. 출력 검사로는 막지 못했다. 모델이 퍼센트 표기를 열 건 중 한 건 같은 말로 풀어 쓰면 검사를 통과하기 때문이다. 출처를 열 때는 열자마자 전수로 훑는 편이 낫다.
이 조치는 범위가 좁다. 글 형식, 첫 문장, 검사 단계는 건드리지 않았고 출처 목록 한 곳만 바꿨다. 한 번에 여러 곳을 바꾸면 반응이 달라져도 어느 변화가 원인인지 알 수 없다. 출처 하나만 움직였으니 9월 21일 판정은 이 변화 하나의 답이 나온다.
조치 직후에 확인한 것은 구조뿐이다. 새 출처가 글감 목록에 들어갔고, 테스트가 통과했고, 회귀가 없었다. 글 반응이 좋아졌다는 증거는 아직 아니다.
재측정 결과: 조치가 통했는지 어떻게 판정하나?
한 번 재고 끝내지 않으려고, 판정 규칙을 조치와 같은 날 적어 뒀다. 2주 뒤인 9월 21일에 판매 서비스 문서에서 나온 글의 노출 대비 좋아요를 자동화 내부 글과 견준다. 이번에는 노출로 나눈 값을 비교하므로, 절대값만 보던 지금까지보다 훨씬 적은 표본으로 답이 난다. 지지되지 않으면 출처가 아니라 형식으로 축을 옮긴다.
이 글을 쓰는 10월 3일 기준으로 9월 21일 판정 결과는 우리가 본 기록에 없다. 그래서 효과가 있었다고 쓰지 않는다. 판정 결과가 나왔는지는 확인 필요 항목이다.
대신 조치 이후 기록에서 구조 변화 두 가지를 읽었다.
- 새 출처는 실제 발행까지 닿았다. 9월 7일부터 11일까지 발행 21편의 축 순서를 보니 판매 서비스 문서와 자동화 코드가 한 편도 빠짐없이 번갈아 나갔다. 1순위로 올린 출처가 살아 있다는 확인이다.
- 그 번갈아 나가기 자체가 새 문제를 낳았다. 9월 11일에 운영자가 피드가 이 주제 저 주제로 흩어져 특정 주제에 관심 있는 사람이 모이지 않는다고 짚었고, 우리는 발행을 하루 한 축으로 묶었다. 축은 AI·자동화 구축과 사업·마케팅 실측 둘이고, 발행 102건을 나누면 AI·자동화 구축 59건, 사업·마케팅 실측 36건, 미분류 7건이었다.
두 번째 항목의 분포는 효과가 아니라 분류다. 누적 발행 102건 중 구축 축이 아직 59건으로 더 많은 이유는 도입 전 글이 섞인 숫자라서다. 노출 대비 좋아요라는 판정 숫자가 나오기 전에는 이 분포를 성과로 읽지 않는다.
남는 한계: 아직 모르는 부분은 무엇인가?
이 개선기에서 확인한 내용과 확인하지 못한 내용을 구분해 둔다.
- 효과는 미확인이다. 9월 21일 판정 결과가 기록에 없고, 지금 있는 자료는 판정 규칙뿐이다.
- 우리 표본만으로는 방향을 말할 뿐이다. 사업·시장 40건과 자동화 내부 33건의 차이는 p=0.123이라 판정하지 않았다.
- 바닥 주제 매핑은 거칠다. 78건 중 33건은 어느 대역에도 못 넣었고, 바닥 내역 세 개의 합이 39건과 안 맞는다.
- 좋아요는 문의가 아니다. 이 계정의 목적은 바이럴이 아니라 의뢰 문의이고, 팔로워가 11명인 규모에서는 전환까지 재지 못한다. 막힌 곳은 전환 이전의 도달과 관계다.
- 기록 사이에 숫자가 어긋난다. 8월 31일 기록은 출처 저장소를 12개에서 31개로 늘렸다고 적고, 9월 7일 기록은 12개라고 적는다. 어느 쪽이 맞는지 이 글에서는 확인하지 못했다.
- 판매 서비스 문서 출처에 대해, 코드 출처 때 했던 열자마자 전수 훑기의 결과는 기록에 없다. 같은 누출이 없다고 확인한 결과는 아니다.
판정이 기대와 다르게 나올 경우의 다음 수도 미리 정해 뒀다. 지지되지 않으면 출처가 아니라 형식으로 축을 옮긴다. 우리 가설이 한 번 더 반증될 수 있다는 뜻이고, 그 가능성을 지우지 않고 남겨 둔다.
한계 중 가장 큰 것은 첫 번째다. 이 글의 결론은 원인에 관한 것이지 해결의 증거가 아니다. 주제가 바닥이었다는 측정은 두 곳(수집 표본과 우리 기록)에서 같은 방향으로 나왔지만, 주제를 바꾸면 반응이 오른다는 주장은 아직 시험하지 않았다.
내 스레드 계정에서는 무엇부터 재야 하나?
스레드 마케팅 글이 읽히는데 반응이 없을 때 우리가 쓴 순서는 이렇다. 글 안쪽을 고치기 전에 아래 다섯 칸을 먼저 채운다.
- 내 업종과 맞닿은 검색어로 스레드 글을 모아 주제별로 나누고, 주제마다 150건 이상 모이는지 본다.
- 주제마다 좋아요 중앙값을 낸다. 평균은 터진 글 한두 개가 끌어올리므로 쓰지 않는다.
- 내가 올린 글을 같은 주제 분류에 대 보고, 상위 주제·바닥 주제·미분류의 개수를 센다.
- 글감을 뽑는 출처 목록을 열어 본다. 출처가 한 종류의 문서뿐이면 글도 한 종류로 쏠린다.
- 판정 기준은 좋아요 절대값이 아니라 노출 대비 좋아요로 잡고, 날짜를 미리 정해 적는다.
다섯 칸 중 파급이 가장 큰 칸은 네 번째다. 출처 목록은 한 번 바꾸면 이후 모든 글에 영향을 주고, 한 번 잘못 열어 두면 모든 글이 같은 방향으로 쏠린다. 우리가 겪은 일이 정확히 그 경우였다.
재기 전에 무엇을 재는지부터 확인하는 순서는 AI업체 홈페이지 실적 수치 글에서도 같았다. 같은 점검을 자기 계정에 해 보고 싶다면 상담 문의에 글감 출처 목록과 발행 기록을 붙여 주면 같은 표로 대 볼 수 있다.