WSL 메모리 부족이 왜 4시간 멈춤으로 번졌나?
WSL 메모리 부족이라고 하면 보통 「프로그램 하나가 튕긴다」 정도를 떠올립니다. 메모리가 모자라면 리눅스 커널이 가장 무거운 프로세스를 골라 강제로 끝내고, 나머지는 계속 돌아간다는 그림입니다. 이 역할을 맡는 장치를 OOM killer라고 부릅니다. 우리도 그렇게 믿었고, 그래서 메모리 문제를 따로 걱정한 적이 거의 없었습니다.
실제로 겪은 일은 그림과 달랐습니다. 2026년 7월에 WSL 가상 머신이 새벽 시간대에 두 번 멈췄고, 두 번 다 4시간 가까이 아무 입력도 받지 않았습니다. 프로그램 하나가 튕기는 수준이 아니라 가상 머신 전체가 굳었습니다. 아침에 화면을 열었을 때는 이미 여러 시간이 지나 있었고, 밤새 돌아야 할 작업은 하나도 끝나 있지 않았습니다.
피해는 한 창에서 끝나지 않았습니다. 우리는 Claude Code 세션 여러 개를 한 WSL 위에 나란히 띄워 둡니다. 한 세션은 블로그 초안을 쓰고, 다른 세션은 데이터를 모으고, 또 다른 세션은 코드를 고치는 식입니다. 그 4시간 동안 병렬로 돌던 다른 세션 전부가 함께 인질로 잡혔습니다. 당시 떠 있던 세션 수는 정확히 세지 못했고 8개 정도로 추정합니다. 문제를 일으킨 프로세스는 1개였는데, 손실은 가상 머신 전체의 4시간이었습니다.
처음 잰 숫자 — 35GB, 30.7GB, 그리고 10번의 kill 시도
먼저 한 일은 기억이 아니라 커널 로그를 읽는 일이었습니다. 리눅스는 OOM killer가 움직일 때마다 어떤 프로세스를 골랐고 그 프로세스가 메모리를 얼마나 쓰고 있었는지 시스템 로그에 남깁니다. journalctl로 두 사고 시각 전후의 커널 메시지를 뽑아 날짜와 프로세스 번호(pid)별로 정리했습니다.
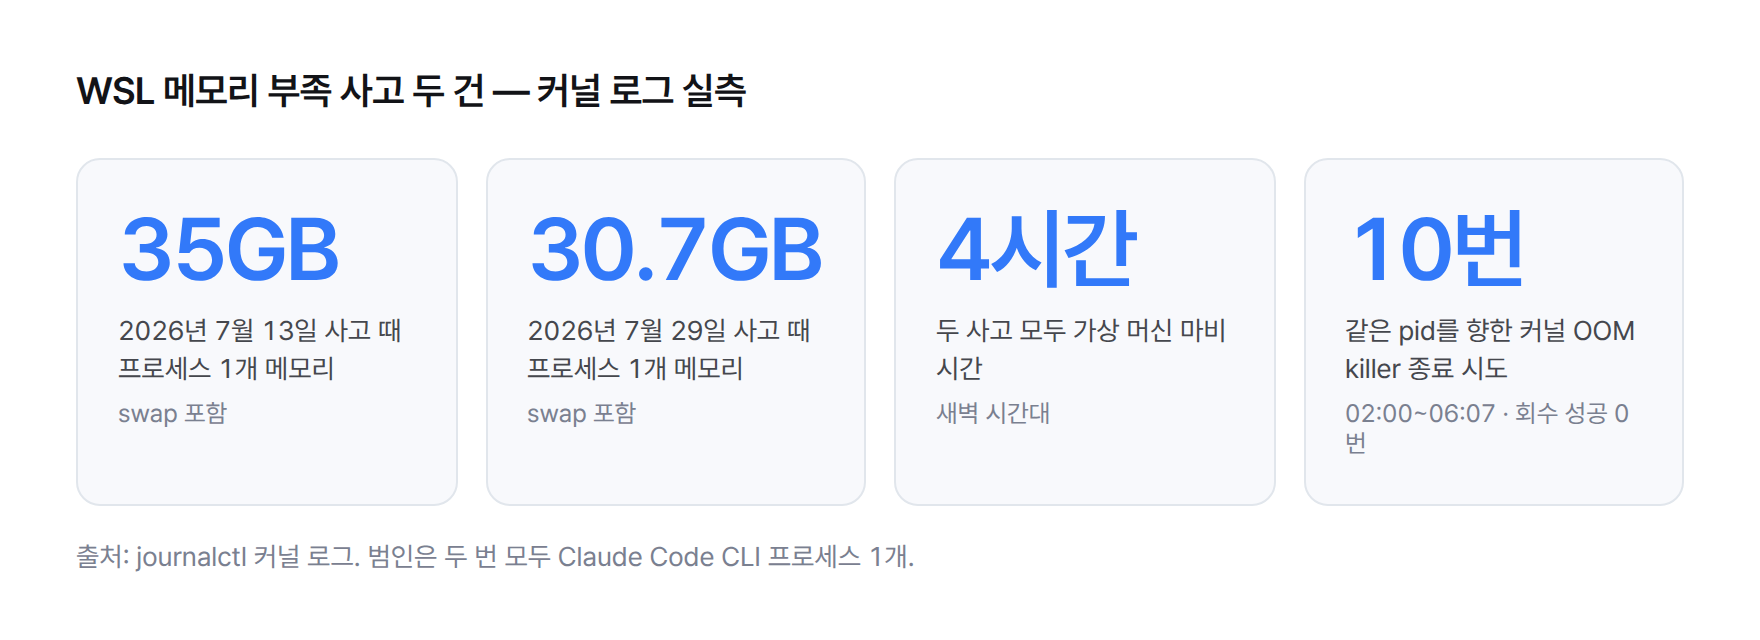
숫자는 이렇게 나왔습니다. 2026년 7월 13일 사고에서는 프로세스 하나가 swap까지 합쳐 35GB를 차지했고, 2026년 7월 29일 사고에서는 30.7GB였습니다. 두 번 모두 범인은 Claude Code CLI 프로세스 1개였습니다. 평소 이 프로세스가 쓰는 메모리는 0.3~0.5GB라서, 사고 때는 평소의 수십 배로 부풀어 있었던 셈입니다.
둘째 숫자는 더 이상했습니다. 사고 로그에서 커널 OOM killer는 같은 pid를 02:00부터 06:07까지 10번 골랐습니다. 한 번 고른 프로세스를 또 고른다는 말은, 앞선 종료 시도가 끝나지 않았다는 뜻입니다. 로그에 찍힌 그 프로세스의 물리 메모리 사용량(RSS)은 10번 모두 같은 값이었습니다. 커널은 죽이라는 명령을 10번 내렸고, 프로세스는 10번 모두 그 자리에 그대로 있었습니다.
셋째는 사고 간격입니다. 첫 사고와 둘째 사고 사이가 16일이었습니다. 16일 사이 2회라는 빈도는 우연으로 넘기기 어려웠고, 그대로 두면 다음 사고가 가장 유력한 다음 손실이라는 판단이 섰습니다.
세운 가설 — 커널 OOM killer가 최후 방어선이다
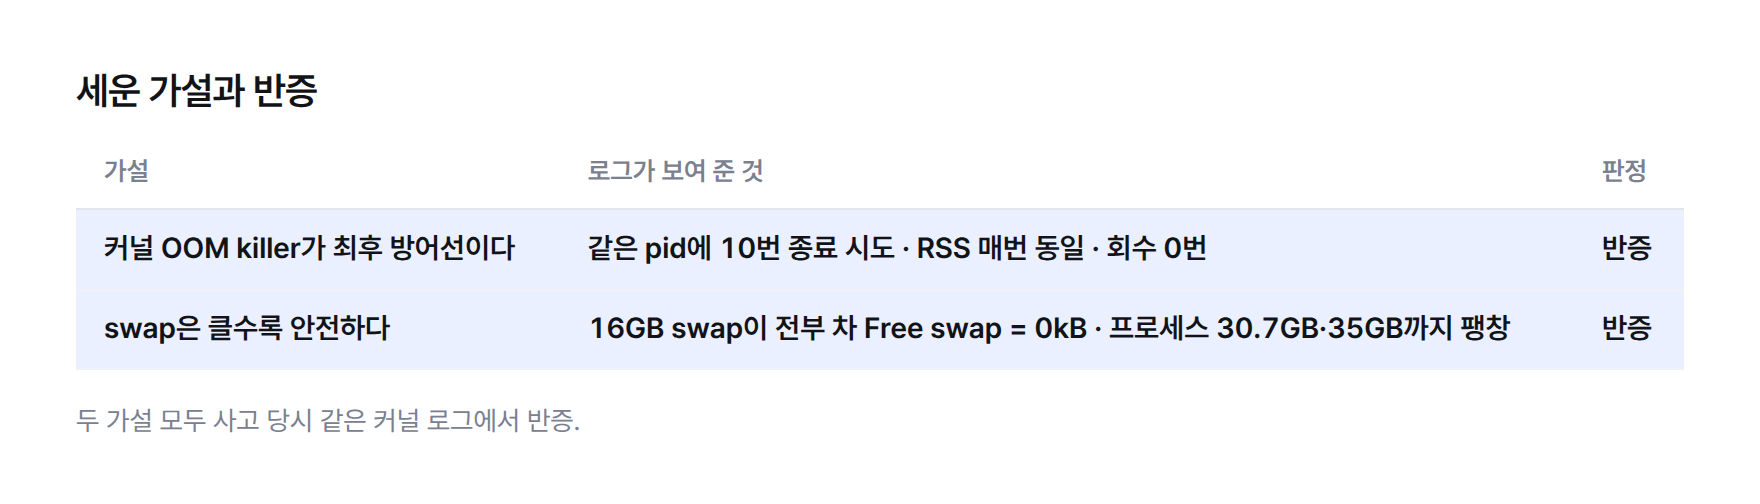
사고 전까지 우리가 품고 있던 가설은 두 가지였습니다. 둘 다 명시적으로 적어 둔 적은 없지만, 메모리 감시 장치를 따로 두지 않은 이유가 바로 이 두 가지 믿음이었습니다.
첫째 가설은 「커널이 최후 방어선이다」였습니다. 어떤 프로세스가 메모리를 다 먹어도 커널 OOM killer가 그 프로세스를 끝내고 메모리를 돌려받는다고 여겼습니다. 이 믿음 위에서는 최악의 경우에도 세션 하나를 잃을 뿐, 가상 머신 전체가 멈출 일은 없습니다. 그래서 당시 운영하던 메모리 감시는 관찰 전용이었습니다. 프로세스별 메모리를 로그 파일(rss.log)에 계속 적기만 하고, 아무것도 끊지 않았습니다. 그 로그 파일은 끝없이 불어나기만 했고 사고를 막는 데는 쓰이지 않았습니다.
둘째 가설은 「swap은 넉넉할수록 안전하다」였습니다. swap은 물리 메모리가 모자랄 때 디스크 일부를 메모리처럼 빌려 쓰는 공간입니다. 우리 WSL 설정 파일(.wslconfig)에는 swap이 16GB로 잡혀 있었습니다. 이미지 생성 도구(ComfyUI)나 로컬 언어 모델 실행기(ollama)처럼 원래 메모리를 많이 쓰는 정상 작업이 있어서, swap을 크게 잡아 두면 그런 작업이 버틸 여유가 생긴다고 봤습니다.
두 가설을 합치면 이런 그림이 나옵니다. 메모리가 모자라면 먼저 swap이 받아 주고, swap까지 차면 커널이 가장 무거운 프로세스를 끝낸다. 어느 쪽이든 가상 머신은 살아남는다. 두 번의 새벽 사고는 이 그림이 어딘가에서 틀렸다는 증거였습니다.
가설이 틀린 지점 — 커널은 왜 10번이나 실패했나?
첫째 가설은 10번이라는 숫자 앞에서 무너졌습니다. OOM killer가 제 역할을 했다면 첫 번째 시도에서 프로세스가 사라지고 메모리가 돌아왔어야 합니다. 그런데 로그는 같은 프로세스가 4시간 넘게 같은 크기로 남아 있었다고 말했습니다. 커널은 프로세스를 고르는 데까지는 성공했고, 그 프로세스를 실제로 거둬들이는(reap) 데는 한 번도 성공하지 못했습니다.
여기서 짚어 둘 점이 있습니다. 커널이 종료 신호를 보내는 일과, 그 프로세스가 실제로 사라지고 메모리를 반납하는 일은 별개입니다. 프로세스가 끝나려면 자기가 쥐고 있던 메모리 영역을 하나씩 풀어야 합니다. 이 과정이 막히면 커널은 신호를 보냈는데도 메모리는 돌려받지 못한 상태에 갇힙니다. 우리가 믿은 「커널이 끝낸다」는 앞 단계만 본 믿음이었습니다.
둘째 가설도 같은 로그에서 반증이 나왔습니다. 사고 시점 커널 메시지에는 Free swap = 0kB가 찍혀 있었습니다. 16GB로 넉넉하게 잡은 swap이 전부 차 있었다는 뜻입니다. swap이 여유를 주기는커녕, 프로세스가 30GB대까지 부풀 수 있게 판을 깔아 준 셈이었습니다. swap이 작았다면 프로세스는 그렇게 커지기 전에 멈췄을 겁니다.
진짜 원인 — swap이 클수록 OOM은 느린 마비가 된다
두 가설의 실패를 겹쳐 보면 하나의 구조가 보입니다. 프로세스가 끝나려면 쥐고 있던 메모리를 풀어야 하고(unmap), 그 메모리의 상당 부분이 이미 디스크의 swap으로 밀려나 있었습니다. 리눅스는 이런 영역을 정리하는 과정에서 swap에 있던 데이터를 다시 메모리로 읽어 들여야 하는 경우가 생깁니다. 그런데 swap은 0kB 남은 상태였고, 물리 메모리도 바닥이었습니다.
결과적으로 종료 경로 자체가 멈춰 섰습니다(stall). 30GB를 풀려면 먼저 읽어 들여야 하고, 읽어 들일 자리가 없으니 아무것도 풀리지 않습니다. 커널은 몇 번이고 다시 이 프로세스를 골랐지만, 매번 같은 벽에 부딪혔습니다. 10번의 시도가 전부 같은 RSS를 기록한 이유가 여기 있습니다. 그 사이 디스크와 메모리를 둘러싼 경합이 가상 머신 전체를 붙잡았고, 다른 세션들도 한 줄도 진행하지 못했습니다.
swap이 클수록 OOM은 「빠른 죽음」이 아니라 「느린 마비」가 된다.
이 문장이 우리가 얻은 핵심입니다. swap이 작으면 프로세스는 덜 부푼 상태에서 커널에게 잡히고, 종료도 빨리 끝납니다. swap이 크면 프로세스는 훨씬 크게 부풀 시간을 얻고, 막상 끝내야 할 때는 풀어야 할 양이 너무 많아 끝내지 못합니다. 16GB swap은 안전망이 아니라, 실패를 4시간짜리로 늘려 주는 완충재였습니다.
그렇다면 무엇이 프로세스를 그렇게 키웠을까요. 이 부분은 확정하지 못했습니다. 문제의 세션은 서브에이전트 4개를 동시에 돌려 웹 페이지 구조(DOM)를 대량으로 모으고 있었고, 이 동시 실행이 가장 유력한 계기라고 추정합니다. 우리는 이미 「서브에이전트 동시 실행은 1개씩」이라는 작업 원칙을 두고 있었는데, 이번 사고는 그 원칙이 옳은 방향이었다는 실증 사례가 되었습니다.
조치 — 커널보다 먼저 끊는 사용자 공간 가드
결론은 커널을 최후 방어선으로 믿지 않는다는 쪽이었습니다. 커널이 움직이는 시점은 이미 늦습니다. 그래서 커널보다 훨씬 앞에서, 사용자 공간의 작은 스크립트가 먼저 문제의 프로세스를 끊게 했습니다. 스크립트 이름은 mem-guard.py이고, 크론으로 1분마다 돕니다. 기존의 관찰 전용 감시는 이 스크립트로 대체했습니다.
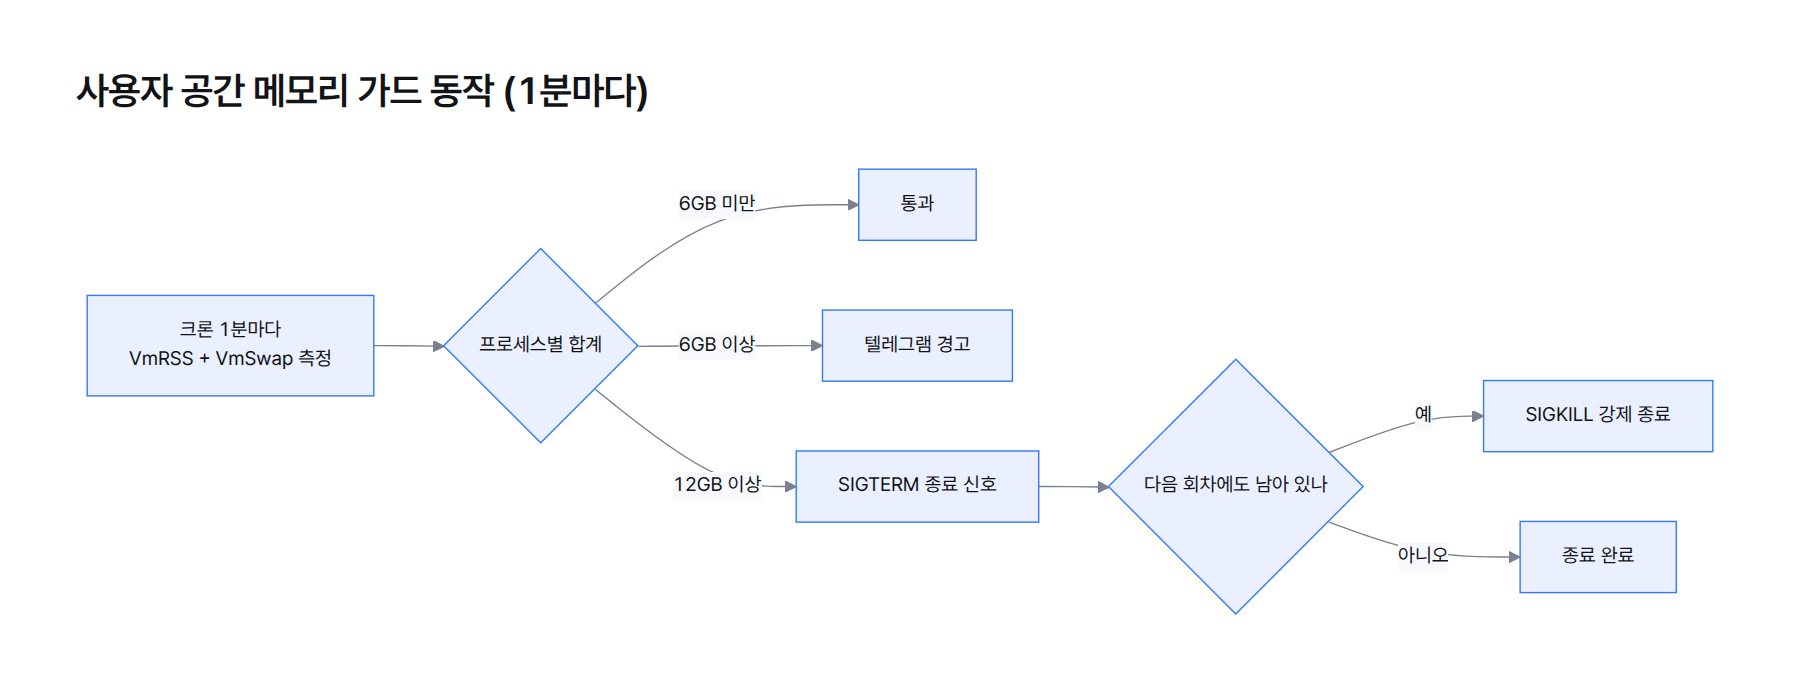
재는 값은 한 프로세스의 물리 메모리 사용량(VmRSS)과 swap 사용량(VmSwap)을 더한 합계입니다. 물리 메모리만 보면 swap으로 밀려난 부분을 놓칩니다. 이번 사고에서 부푼 몸집의 상당 부분이 swap 쪽에 있었기 때문에, 둘을 합쳐야 실제 크기가 보입니다.
임계는 두 단계입니다. 합계가 6GB에 닿으면 텔레그램으로 경고만 보냅니다. 12GB에 닿으면 그 프로세스에 종료 신호(SIGTERM)를 보내고, 다음 회차 검사 때도 남아 있으면 강제 종료(SIGKILL)를 보냅니다. 부드럽게 끝낼 기회를 한 번 주고, 그래도 안 끝나면 끊는 순서입니다.
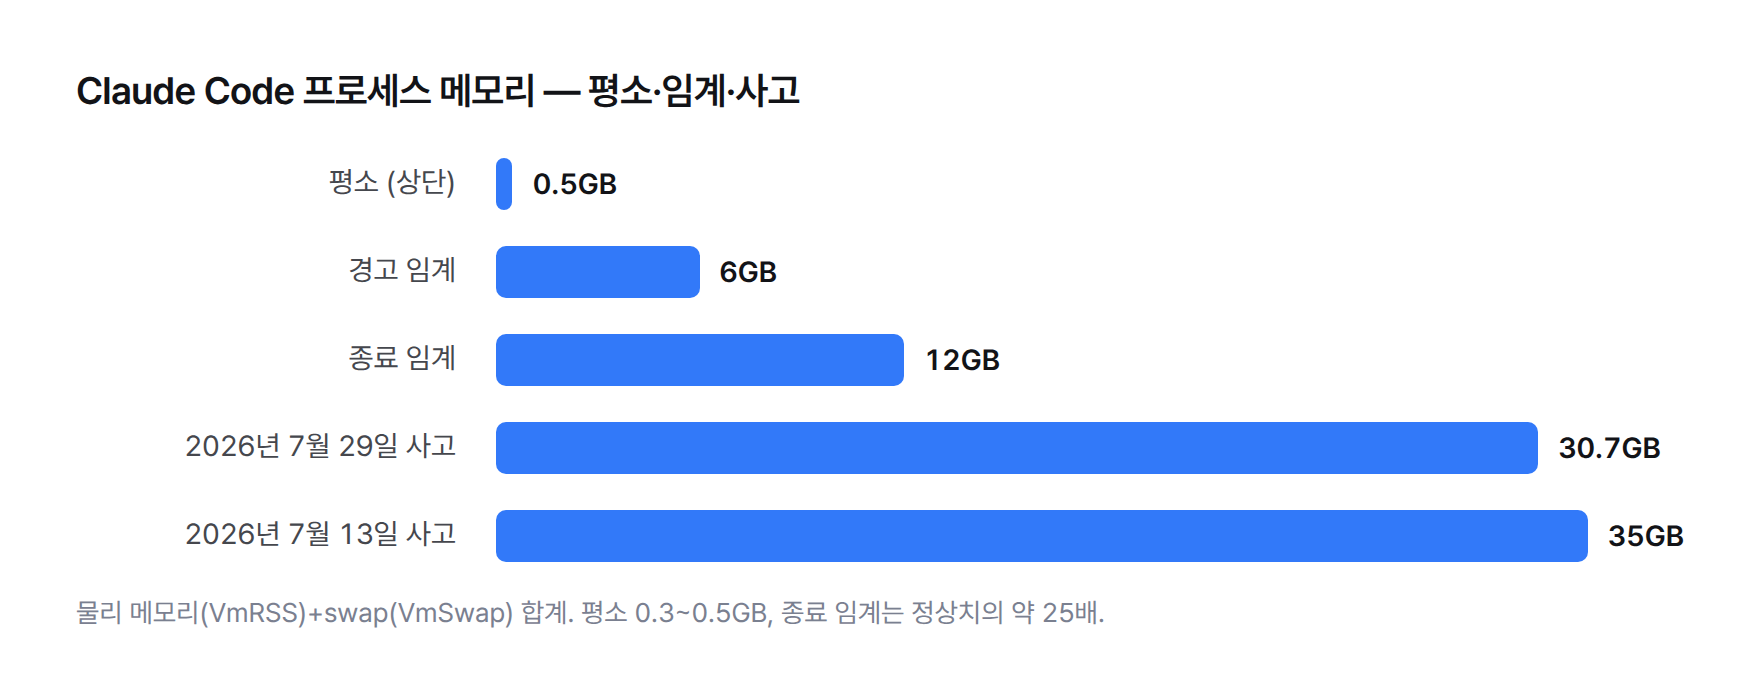
12GB라는 값은 평소 크기에서 거꾸로 잡았습니다. 정상 Claude Code 프로세스는 0.3~0.5GB를 쓰니, 12GB는 정상치의 약 25배입니다. 멀쩡한 세션이 이 선을 넘을 여지는 거의 없어서, 오탐으로 멀쩡한 작업을 끊을 위험은 낮다고 봤습니다. 동시에 12GB는 사고 때의 30.7GB, 35GB보다 한참 아래라, swap이 바닥나 종료 경로가 막히기 전에 끝낼 수 있습니다.
이 조치의 대가도 분명히 적어 둡니다. 임계에 닿으면 가장 무거운 세션 1개를 강제로 잃습니다. 그 세션이 하던 작업은 날아갑니다. 그래도 세션 1개를 잃는 편이 가상 머신 전체가 4시간 멈추는 편보다 언제나 낫다고 판단했습니다. 손실을 없애는 조치가 아니라, 손실의 크기를 정해 두는 조치입니다.
다른 방법은 왜 고르지 않았나?
감시 스크립트를 직접 만들기 전에 대안 세 가지를 검토했습니다. 셋 다 그럴듯했고, 각각 다른 이유로 지금 당장은 고르지 않았습니다.
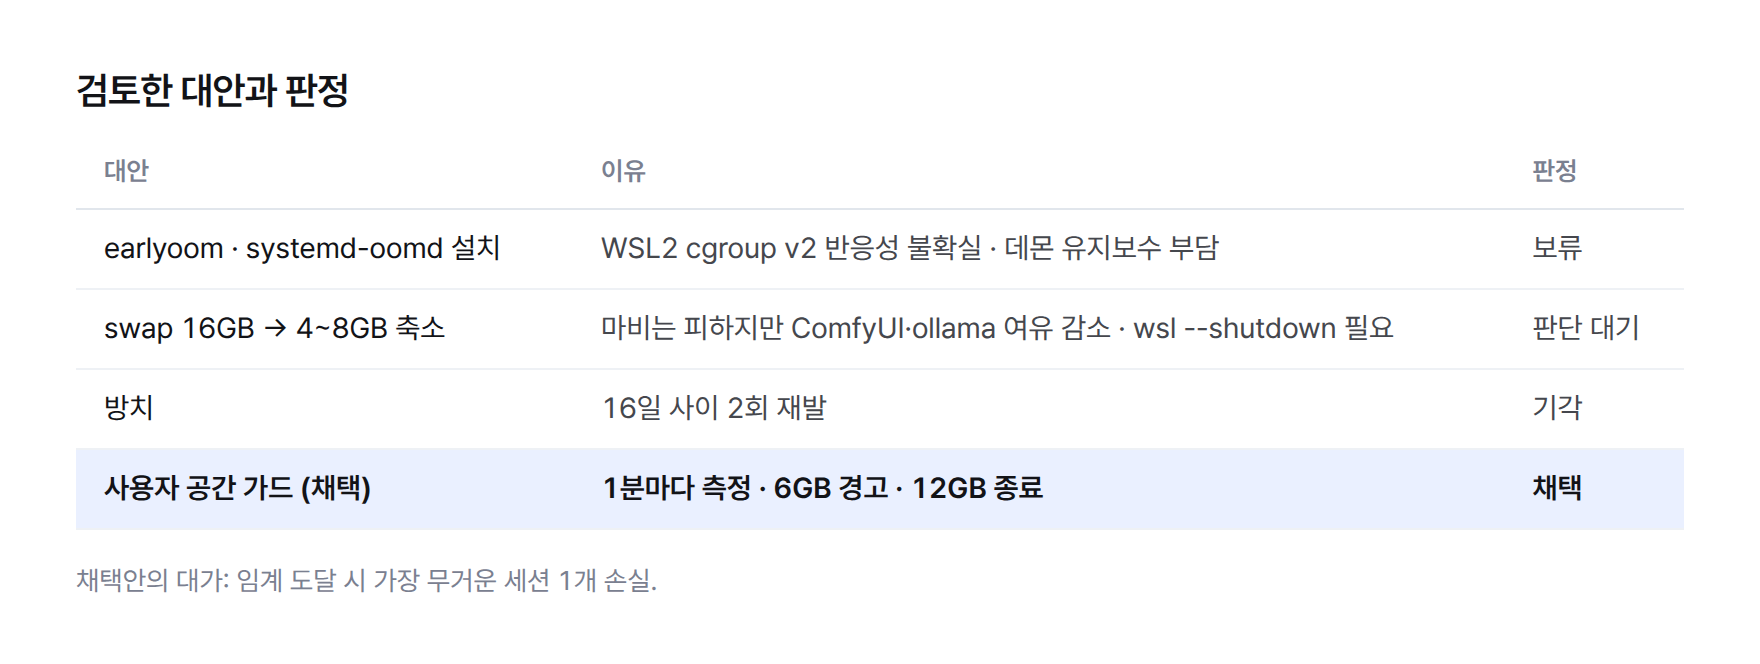
첫째 대안은 earlyoom이나 systemd-oomd 같은 기존 메모리 감시 데몬입니다. 범용 도구라 우리가 직접 만드는 스크립트보다 검증된 면이 있습니다. 다만 WSL2의 cgroup v2 환경에서 이 도구들이 얼마나 빠르게 반응하는지 확인하지 못했고, 상주 프로그램을 하나 더 관리하는 부담도 생깁니다. 확인 없이 들이기에는 무거웠습니다.
둘째 대안은 swap 자체를 줄이는 방법입니다. .wslconfig의 swap을 16GB에서 4~8GB로 낮추면, 앞에서 본 구조대로 OOM이 더 일찍, 더 빨리 성공해 마비를 피할 수 있습니다. 원인에 가장 가까운 처방입니다. 그러나 ComfyUI, ollama처럼 원래 메모리를 많이 쓰는 정상 작업의 여유가 줄어듭니다. 게다가 설정을 적용하려면 wsl --shutdown으로 WSL을 통째로 내려야 하고, 그 순간 돌고 있던 병렬 세션이 전부 끝납니다. 그래서 바로 실행하지 않고 판단 대기 목록에 올려 두었습니다.
셋째 대안은 아무것도 하지 않는 방법이었습니다. 16일 사이 2회라는 재발 간격을 보면, 그대로 두는 선택은 다음 사고를 기다리는 선택과 같았습니다. 이 안은 바로 기각했습니다.
재측정 결과 — 실제 발동 기록은 아직 0건
개선기라면 여기서 「이후 마비 0회」 같은 숫자를 보여 줘야 합니다. 정직하게 말하면 그 숫자는 아직 없습니다. 지금 가진 재측정 결과는 두 가지뿐입니다.
첫째, 감시 스크립트는 dry-run으로만 검증했습니다. 실제로 신호를 보내지 않고, 임계를 넘었다면 무엇을 했을지만 기록하게 돌려 봤습니다. 이 방식으로는 측정과 판정 로직이 맞게 도는지는 확인할 수 있지만, 경고 메시지가 실제로 텔레그램에 도착하는지, 종료 신호가 실제로 프로세스를 끝내는지는 확인하지 못합니다.
둘째, 도입 이후 실제로 임계를 넘은 사건은 0건입니다. 6GB 경고도 12GB 종료도 아직 한 번도 울리지 않았습니다. 이 0건을 성과로 읽으면 안 됩니다. 그 사이 사고를 부를 만한 큰 작업이 없었을 수도 있고, 가드가 작동하지 않는데 우연히 조용했을 수도 있습니다. 0건은 「막았다」가 아니라 「아직 시험받지 않았다」입니다.
진짜 재측정 기준도 미리 정해 두었습니다. 서브에이전트를 여러 개 동시에 돌리는 대형 작업을 다시 치를 때, 부푸는 프로세스에 6GB 경고가 먼저 도착하는지, 12GB에서 종료 신호가 나가는지, 다음 회차에 강제 종료까지 이어지는지, 그리고 그동안 나머지 세션이 멈추지 않고 계속 도는지를 봅니다. 넷 중 하나라도 어긋나면 가드는 아직 방어선이 아닙니다.
그래서 이 글의 전후 비교는 측정값이 아니라 설계값으로 적습니다. 도입 전에는 프로세스 1개가 30.7GB, 35GB까지 커지는 동안 아무도 끊지 않았고, 결과는 4시간 마비였습니다. 도입 후에는 같은 프로세스가 12GB에 닿는 순간 끊도록 상한을 걸었고, 최악의 손실을 세션 1개로 정해 두었습니다. 이 설계가 실제로 버티는지는 다음 대형 작업이 알려 줄 겁니다.
남는 한계 — 무엇이 아직 검증되지 않았나?
- 실제 발동 경로가 비어 있다 — 경고와 종료가 실전에서 울린 기록이 0건이다. 1~2주 관찰하거나, 서브에이전트를 여러 개 동시에 돌리는 대형 작업을 한 번 치른 뒤에야 진짜 검증이 된다
- 원인 제거가 아니다 — swap 16GB 구조는 그대로라, 가드가 놓치는 경로로 프로세스가 커지면 같은 느린 마비가 다시 올 수 있다. swap을 4~8GB로 줄이는 조치는 WSL 전체 재시작이 필요해 판단 대기 상태다
- 감시 대상이 좁다 — 가드는 Claude Code 프로세스를 기준으로 짰다. 다른 프로그램이 같은 방식으로 부풀면 이 가드의 사정권 밖이다
- 부푼 이유를 확정하지 못했다 — 서브에이전트 4개 동시 실행이 유력한 계기라는 판단은 추정이다. 그래서 가드와 별개로 동시 실행을 1개씩으로 묶는 작업 원칙을 함께 유지한다
- 1분 간격의 틈 — 검사가 1분마다 돌기 때문에, 그 사이에 12GB를 훌쩍 넘어 swap까지 채우는 급격한 폭주는 이론상 놓칠 수 있다
가장 큰 한계는 첫 줄입니다. 가드를 달았다는 사실과 가드가 작동한다는 사실은 다릅니다. 우리는 앞의 사실만 확인했고, 뒤의 사실은 아직 기다리는 중입니다.
WSL 메모리 부족을 겪는다면 무엇부터 확인해야 하나?
WSL 메모리 부족으로 가상 머신이 멈춘 경험이 있다면, 새 도구를 들이기 전에 아래 네 가지부터 확인해 보길 권합니다. 대부분 로그 한 번, 설정 파일 한 번 열어 보면 답이 나옵니다.
- 커널 로그에서 같은 pid가 여러 번 OOM 대상으로 찍혔는가 — 그렇다면 커널이 고르기는 했지만 끝내지는 못했다는 신호다
- 사고 시점 로그에 Free swap = 0kB가 있는가 — swap이 바닥났다면 swap 크기가 실패를 늘리고 있을 가능성이 크다
- 메모리 감시가 기록만 하는가, 실제로 끊는가 — 로그 파일만 쌓는 감시는 사고를 막지 못한다
- 감시 기준이 물리 메모리만 보는가 — swap으로 밀려난 부분까지 합쳐야 실제 크기가 보인다
같은 PC에서 AI 에이전트 여러 개를 동시에 돌릴 때 생기는 다른 사고, 곧 세션끼리 기록을 덮어쓰는 문제는 Claude Code 병렬 세션 기록 유실 글에 따로 적었습니다. 사내 업무에 AI 에이전트를 여러 개 붙이면서 이런 안전장치를 어디에 둘지 고민 중이라면 상담으로 문의해 주세요.
SGK 스튜디오 개발팀이 WSL2 위에서 Claude Code 에이전트를 운영하며 남긴 기록입니다.