무엇이 문제였나: 두 달 동안 무엇이 늘었는지 한 줄로 말할 수 없었다
개발 생산성 지표를 저장소 수와 커밋 수로 잡으면, 숫자는 정직하게 늘어나는데 그 숫자가 무엇을 뜻하는지는 흐려집니다. 우리 사정이 그랬습니다. 대표 한 사람이 AI 코딩 도구와 함께 고객 홈페이지, 영업 자동화, 사내 업무 자동화를 동시에 만들다 보니 두 달이 지나도 "그래서 무엇이 얼마나 늘었나"를 한 줄로 답하지 못했습니다.
이 질문이 중요한 이유는 둘이었습니다. 하나는 경력 기록입니다. 외부에 "두 달 동안 이만큼 만들었다"고 적으려면 같은 방법으로 두 번 잰 숫자가 있어야 합니다. 다른 하나는 운영입니다. 자동으로 도는 작업이 늘면 그만큼 확인할 것도 늘어나는데, 얼마나 늘었는지 모르면 확인 체계를 언제 손봐야 하는지도 정할 수 없습니다.
그래서 2026년 8월 21일에 기준선 스냅샷을 찍어 두고, 10월 23일에 같은 항목을 다시 셌습니다. 세는 대상은 세 묶음입니다. 개인 저장소와 커밋, 새로 생기거나 커진 저장소 목록, 그리고 AI 작업 도구 자산(스킬·에이전트·규칙·훅·스크립트·크론)입니다.
처음 잰 숫자: 저장소 17개, 커밋 3,696개가 늘었다
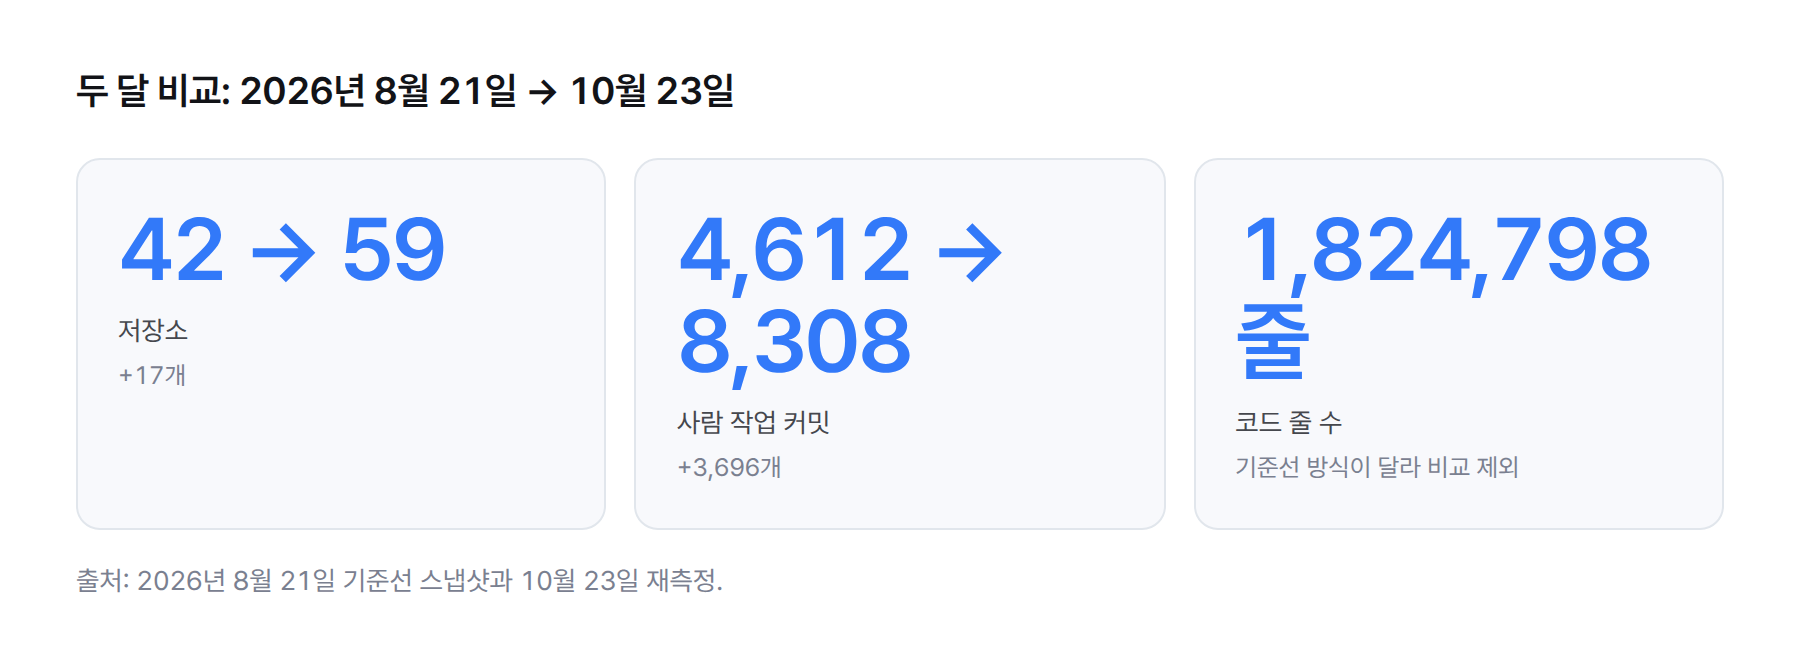
첫 비교는 시원하게 나왔습니다. 저장소는 42개에서 59개로 17개 늘었고, 사람이 직접 한 작업만 센 커밋은 4,612개에서 8,308개로 3,696개 늘었습니다. 여기서 "사람 작업"은 자동화가 스스로 남긴 커밋을 빼고 사람이 한 작업으로 분류한 커밋만 센 숫자입니다.
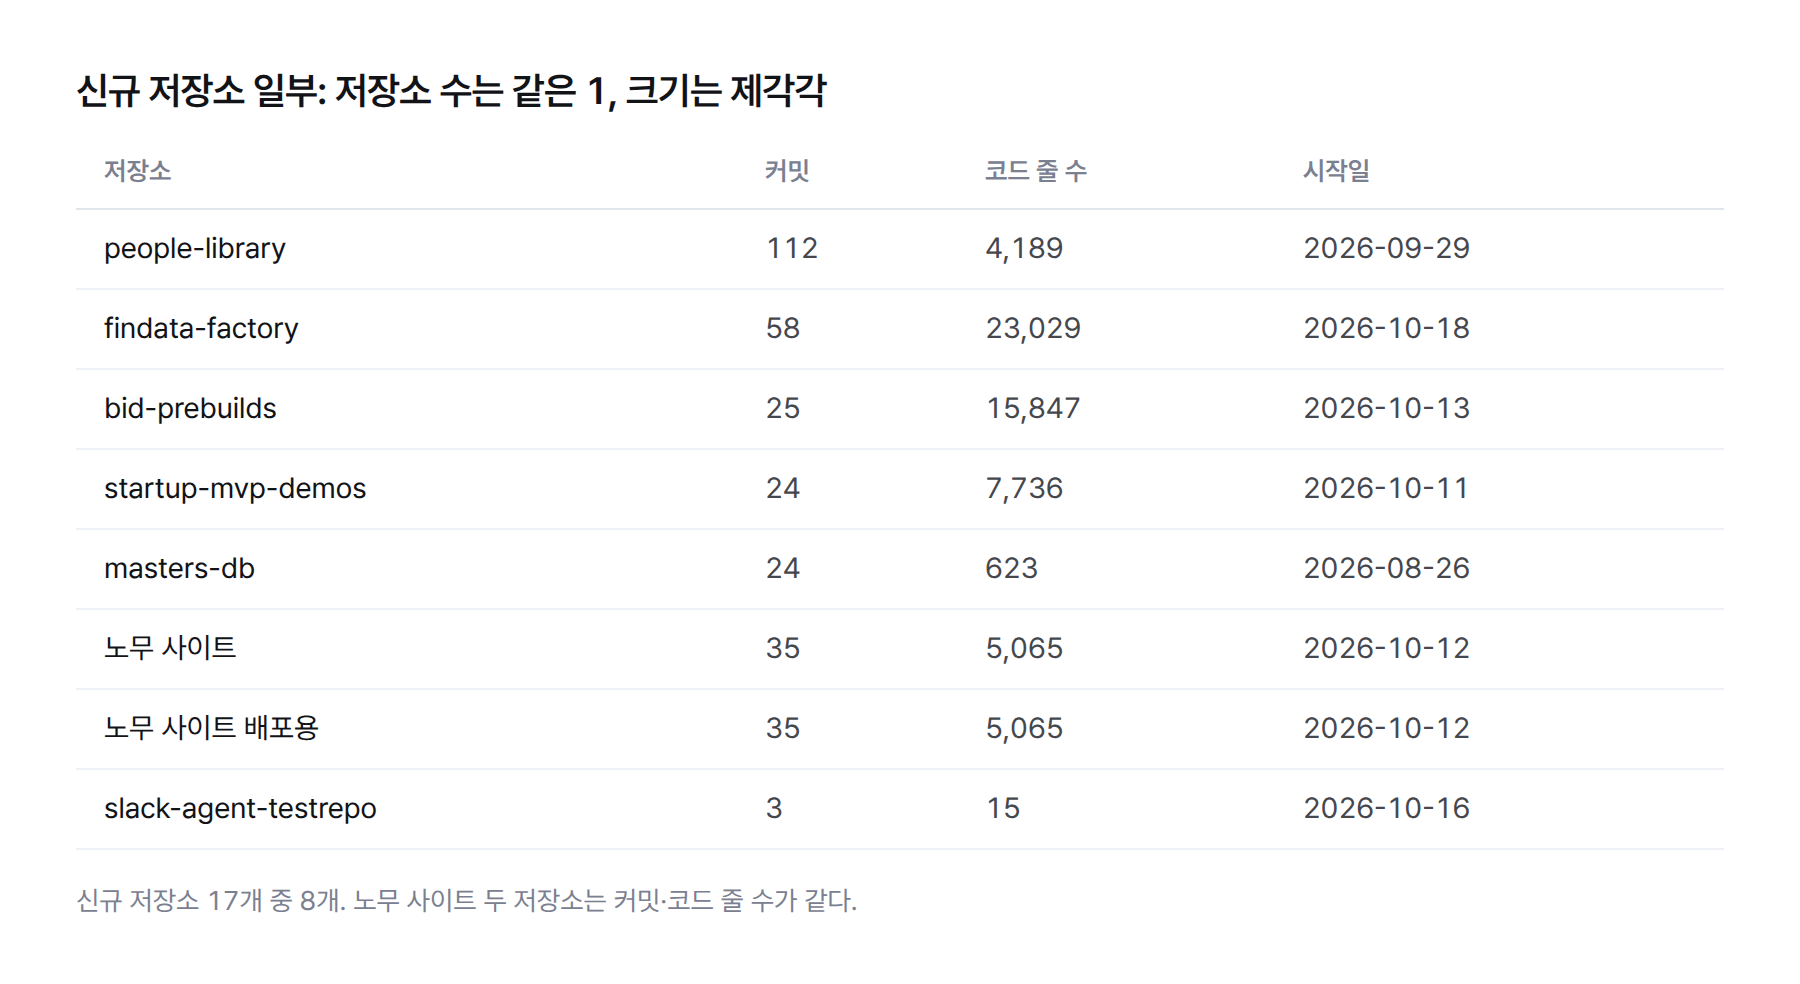
측정 방법은 단순하게 잡았습니다. 기준선 날짜에 저장소 목록과 저장소별 커밋 수, AI 작업 도구 자산의 종류별 개수를 파일로 남겨 두고, 재측정 날짜에 같은 항목을 같은 방식으로 다시 셉니다. 두 목록을 맞대어 기준선에 없던 저장소는 신규로, 있던 저장소 중 커밋이 는 것은 성장으로 나눕니다. 이번에는 신규가 17개, 성장이 14개였습니다. 신규 저장소에는 커밋 수와 코드 줄 수, 시작일을 붙였고, 성장한 저장소에는 전후 커밋 수를 붙였습니다.
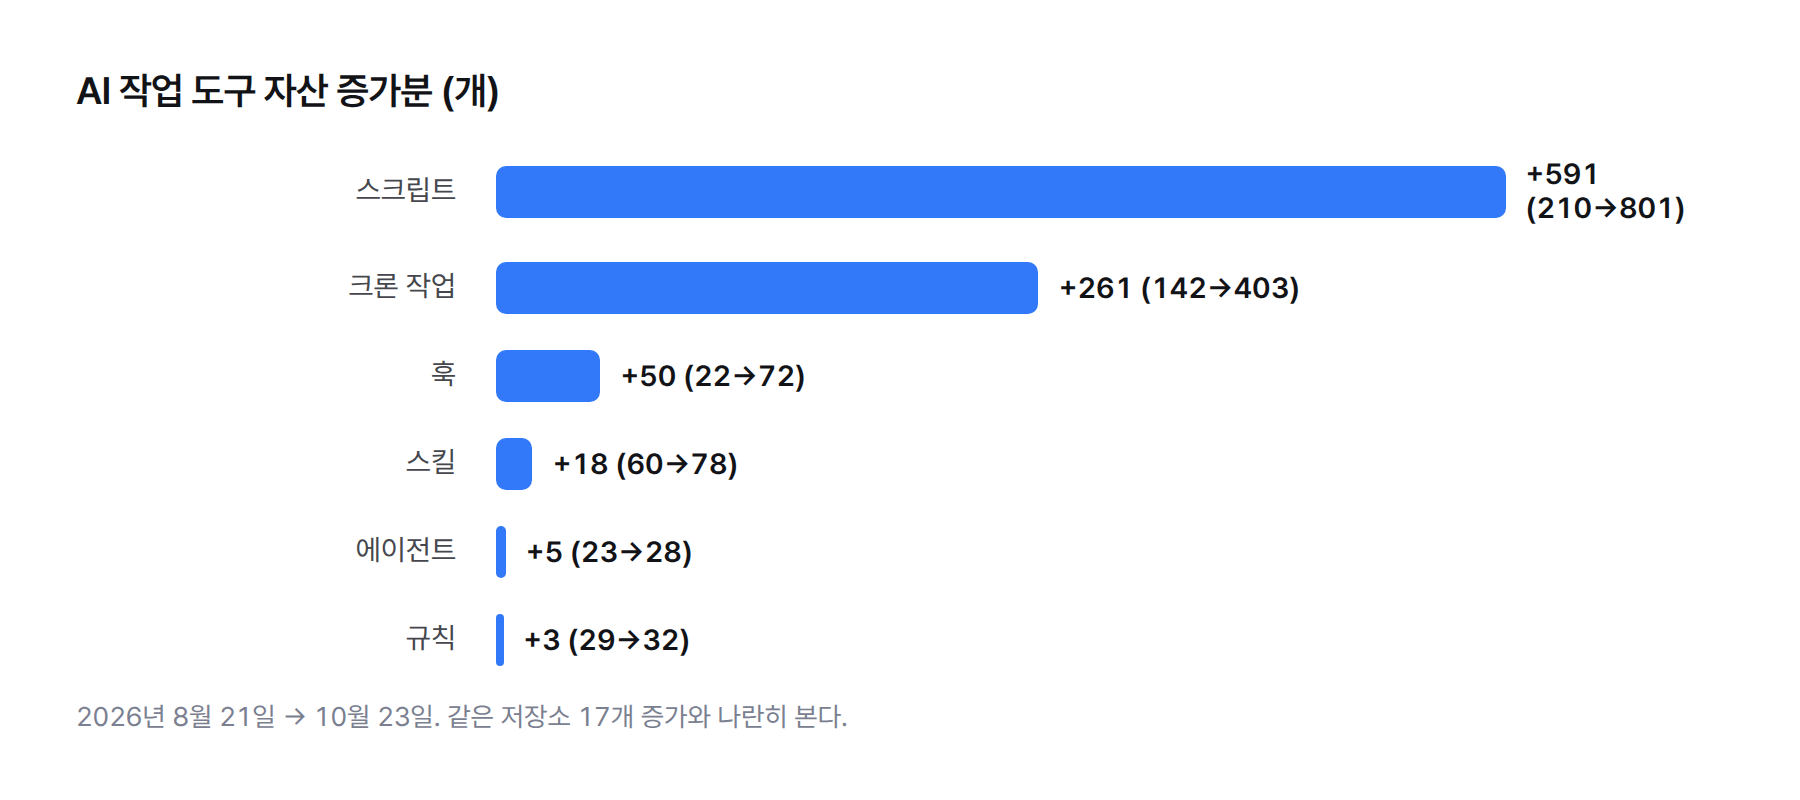
AI 작업 도구 자산은 더 가파르게 늘었습니다. 스크립트는 210개에서 801개로 591개, 크론 작업은 142개에서 403개로 261개, 훅은 22개에서 72개로 50개 늘었습니다. 스킬은 60개에서 78개로 18개, 에이전트는 23개에서 28개로 5개, 규칙 문서는 29개에서 32개로 3개 늘었습니다.
여기까지만 보면 결론은 간단해 보였습니다. 두 달 동안 저장소가 40% 넘게 늘었고 커밋은 두 배 가까이 됐으니, 작업량도 그만큼 늘었다는 결론입니다. 이 글은 그 결론이 어디서 틀렸는지를 다룹니다.
세운 가설: 저장소 수와 커밋 수가 작업량을 그대로 보여 줄까?
처음 세운 가설은 이랬습니다. 저장소 하나는 제품이나 고객 작업 하나에 대응하고, 커밋 하나는 의미 있는 변경 하나에 대응한다. 그러니 저장소 수는 일의 가짓수를, 커밋 수는 일의 양을 보여 준다.
이 가설은 그럴듯했고, 무엇보다 재기 쉬웠습니다. 저장소 목록과 커밋 로그는 이미 컴퓨터에 있고, 사람 판단 없이 기계로 셀 수 있습니다. 측정이 싸고 매번 같은 답이 나온다는 점은 지표의 큰 장점입니다.
코드 줄 수도 같은 이유로 처음에는 지표 후보에 넣었습니다. 저장소별로 코드 줄 수(흔히 LOC라고 부릅니다)를 세면 "얼마나 큰 것을 만들었나"를 보여 줄 수 있다고 봤습니다.
- 저장소 수 = 일의 가짓수
- 커밋 수 = 일의 양
- 코드 줄 수 = 만든 것의 크기
가설이 틀린 지점은 어디였나
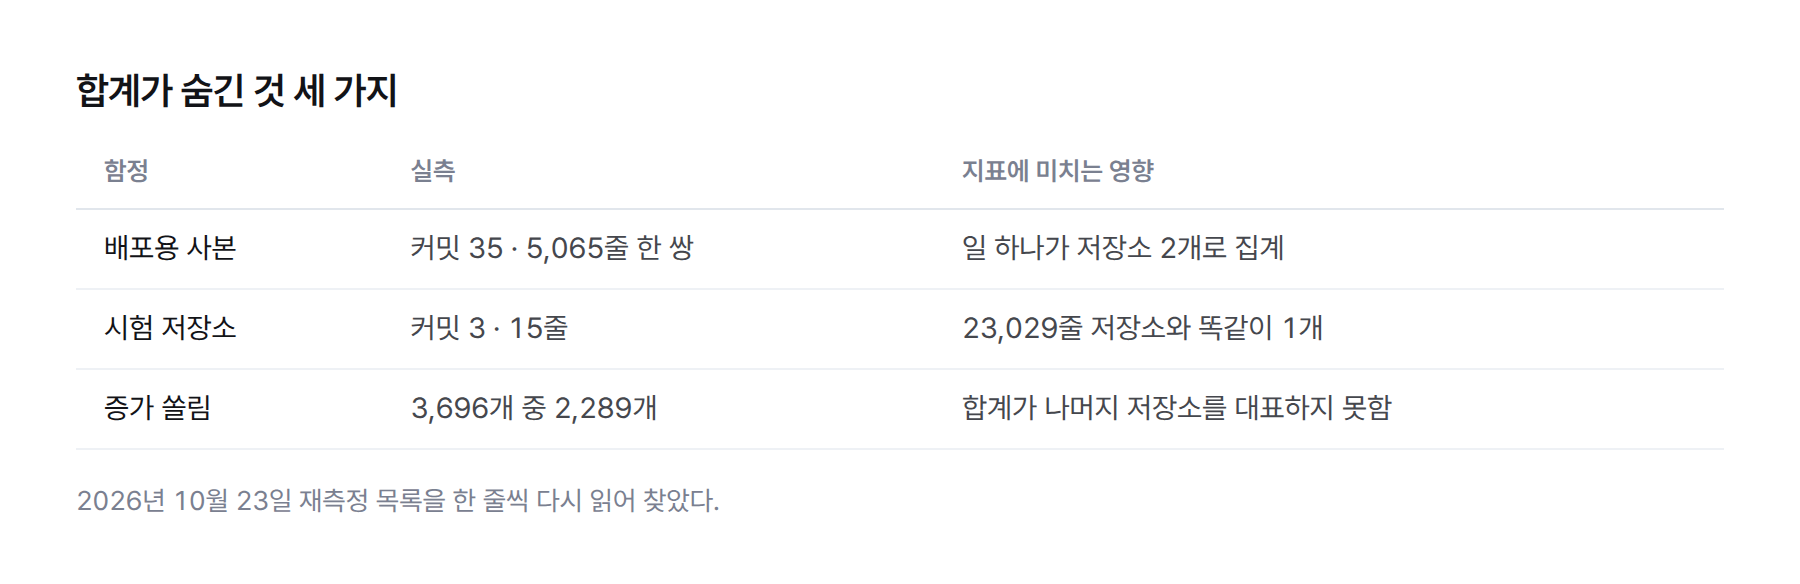
가설은 숫자를 합계로 볼 때는 버텼고, 저장소를 한 줄씩 열자 무너졌습니다. 틀린 자리는 네 군데였습니다.
첫째, 코드 줄 수는 애초에 비교할 수 없었습니다. 10월 23일에 센 코드는 1,824,798줄인데, 8월 21일 기준선은 저장소가 추적하지 않는 파일까지 센 옛 방식이었습니다. 빌드 결과물이나 내려받은 라이브러리 같은 파일이 섞이면, 줄 수에는 사람이 쓰지 않은 코드가 들어갑니다. 두 숫자를 빼면 "늘었다" 또는 "줄었다"는 답이 나오지만, 그 답은 작업이 아니라 세는 방식의 차이를 잽니다.
둘째, 새 저장소 17개 안에 같은 코드를 두 번 센 한 쌍이 있었습니다. 고객사 노무 사이트 저장소와 그 배포용 저장소가 둘 다 커밋 35개, 코드 5,065줄로 숫자가 정확히 같았습니다. 이름대로라면 배포용 사본을 따로 둔 것이라 일의 가짓수로는 하나인데, 저장소 수에는 둘로 잡혔습니다.
셋째, 저장소의 크기가 너무 고르지 않았습니다. 가장 작은 시험 저장소는 커밋 3개, 코드 15줄이었습니다. 반대로 금융 데이터 저장소는 커밋 58개로 23,029줄이었습니다. 둘 다 저장소 수에서는 똑같이 1입니다.
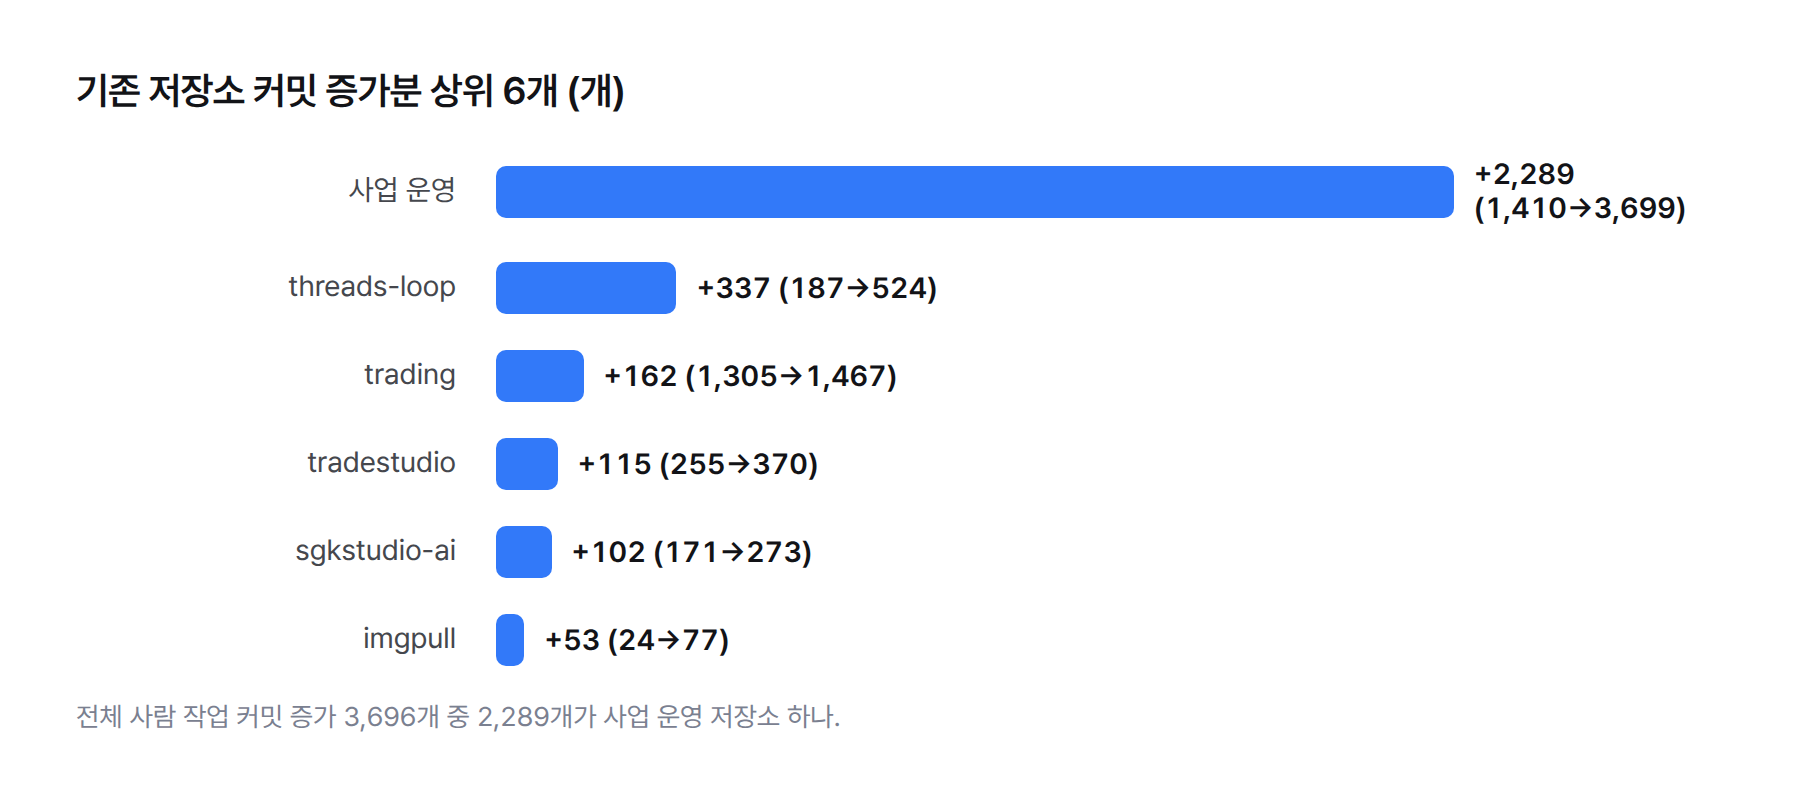
넷째, 커밋 증가는 한 저장소에 몰려 있었습니다. 늘어난 커밋 3,696개 중 2,289개가 회사 사업 운영 저장소 하나에서 나왔습니다. 이 저장소는 1,410개에서 3,699개가 됐습니다. 두 번째로 많이 늘어난 저장소는 337개(187개에서 524개), 세 번째는 162개(1,305개에서 1,467개)였습니다.
진짜 원인: 세는 단위와 일의 단위가 달랐다
네 가지를 모아 보면 원인은 하나였습니다. 저희가 센 단위(저장소·커밋·줄)는 도구가 쓰는 단위이고, 일의 단위가 아니었습니다. 저장소는 배포 편의 때문에 둘로 쪼개지기도 하고, 시험용으로 잠깐 만들어지기도 합니다. 커밋은 잘게 자주 남기는 저장소와 큰 단위로 남기는 저장소에서 같은 일이라도 개수가 다르게 나옵니다.
커밋 수와 코드 줄 수가 서로 따로 노는 모습도 이 원인을 뒷받침합니다. 커밋이 24개로 같은 두 저장소 중 하나는 623줄, 다른 하나는 7,736줄이었습니다. 커밋 25개짜리 저장소는 15,847줄이었습니다. 반대로 커밋이 가장 많은 신규 저장소는 112개인데 4,189줄이었습니다. 커밋 하나가 담는 변경의 크기가 저장소마다 이만큼 다르면, 커밋 합계는 서로 다른 단위를 더한 값이 됩니다.
코드 줄 수 문제는 성격이 조금 달랐습니다. 이쪽은 단위가 아니라 측정 방법이 바뀐 경우입니다. 같은 지표라도 두 시점에 다른 규칙으로 세면 차이는 작업량이 아니라 규칙 변경을 보여 줍니다. 그래서 개발 생산성 지표에서 먼저 지킬 조건은 "좋은 지표를 고른다"보다 "두 번 잴 때 같은 방법으로 잰다"였습니다.
시간 분포도 같은 방향을 가리켰습니다. 신규 저장소 17개의 시작일을 달별로 나누면 8월이 2개(8월 21일·8월 26일), 9월이 3개(9월 6일·9월 16일·9월 29일), 10월이 12개였습니다. 10월 21일에 시작한 rag-bench 저장소는 재측정 이틀 전에 생겼는데 이미 커밋이 23개였습니다. 두 달 구간의 합계는 고르게 쌓인 두 달이 아니라 마지막 3주에 몰린 작업을 평균 낸 값이었습니다.
합계는 버텼고, 한 줄씩 열자 무너졌다. 세는 단위가 일의 단위와 맞는지는 합계로는 보이지 않는다.
어떻게 고쳤나: 같은 방법으로 잰 것만 비교하고, 저장소는 한 줄씩 적었다
조치는 세 가지였습니다. 새 지표를 만들기보다, 지금 있는 숫자가 거짓말하지 못하게 적는 방식을 바꿨습니다.
- 방법이 다른 숫자는 비교에서 뺀다: 코드 줄 수는 10월 23일 값 1,824,798줄만 적고, 기준선과 차이를 계산하지 않습니다. 이유도 같은 줄에 적었습니다(기준선은 추적 밖 파일까지 센 옛 방식)
- 사람 작업과 기계 작업을 가른다: 커밋은 자동화가 남긴 커밋을 빼고 사람 작업만 셉니다. 4,612개와 8,308개가 둘 다 이 규칙으로 센 값입니다
- 합계 대신 저장소별 목록을 같이 낸다: 신규 저장소 17개는 커밋 수·코드 줄 수·시작일을 한 줄에 적고, 성장한 저장소 14개는 전후 커밋을 나란히 적습니다
이 순서는 AI 품질 평가에서 쓰는 원칙을 그대로 빌려 왔습니다. 평가 지표부터 만들지 말고, 실제 실행 기록 20~50건을 사람이 먼저 한 건씩 읽어 실패 유형을 찾은 다음에 자동 지표를 만든다는 원칙입니다. 지표부터 만들면 재기 쉬운 것만 재고 진짜 문제를 놓친다는 경고가 붙어 있습니다. 저장소 수와 커밋 수가 정확히 그 경우였습니다. 재기 쉬워서 골랐고, 한 건씩 읽기 전까지는 무엇을 놓쳤는지 보이지 않았습니다.
세 번째 조치가 가장 효과가 컸습니다. 합계 한 줄만 있으면 중복 저장소도, 15줄짜리 시험 저장소도 보이지 않습니다. 저장소별 목록을 같이 두니 읽는 사람이 "이 둘은 숫자가 똑같은데 같은 것 아닌가"를 스스로 물을 수 있게 됐습니다. 실제로 노무 사이트 한 쌍은 이 목록을 다시 읽다가 찾았습니다.
시작일을 함께 적은 것도 도움이 됐습니다. 규제 확인 도구 저장소는 시작일이 2026년 8월 21일로 기준선과 같은 날이었습니다. 기준선 스냅샷을 찍은 시각보다 먼저 생겼는지 나중에 생겼는지는 날짜만으로 가릴 수 없습니다. 경계일에 생긴 저장소를 신규로 칠지 기존으로 칠지 규칙을 적어 두지 않으면, 다음 비교에서 같은 저장소가 다르게 잡힐 수 있습니다.
이 방식은 이전 측정 글과 이어집니다. 커밋과 자동화 스크립트의 증가 속도를 처음 비교한 과정은 개발 생산성 측정, 커밋보다 자동화 스크립트가 빨리 늘었다에 적었습니다. 이 글은 그 다음 단계로, 늘어난 숫자 안에 무엇이 섞여 있었는지를 다룹니다.
재측정 결과: 무엇이 남고 무엇이 빠졌나
10월 23일 재측정에서 같은 방법으로 두 번 잰 숫자만 남기자 표는 이렇게 정리됐습니다.
| 항목 | 8월 21일 | 10월 23일 | 증감 | 비교 여부 |
|---|---|---|---|---|
| 저장소 | 42개 | 59개 | +17 | 비교함(중복 한 쌍 포함) |
| 사람 작업 커밋 | 4,612개 | 8,308개 | +3,696 | 비교함 |
| 코드 줄 수 | 옛 방식 | 1,824,798줄 | 계산 안 함 | 비교 제외 |
| 스크립트 | 210개 | 801개 | +591 | 비교함 |
| 크론 작업 | 142개 | 403개 | +261 | 비교함 |
| 훅 | 22개 | 72개 | +50 | 비교함 |
출처: 2026년 8월 21일 기준선 스냅샷과 10월 23일 재측정. 코드 줄 수는 기준선이 추적 밖 파일까지 센 방식이라 차이를 계산하지 않았다.
저장소 17개 증가는 숫자 그대로 두되, 그 안에 노무 사이트와 배포용 사본이 따로 잡혀 있다는 점을 같은 표에 남겼습니다. 일의 가짓수로 다시 읽으면 17개보다 적습니다. 다만 "몇 개가 진짜 일인가"를 정하는 규칙은 아직 없어서, 새 숫자를 만들지 않고 원래 숫자에 주석을 다는 쪽을 택했습니다.
성장한 저장소 14개의 분포도 다시 봤습니다. 커밋이 가장 많이 는 저장소는 2,289개였고 가장 적게 는 저장소는 1개(2개에서 3개)였습니다. 이 범위 안에서 자동매매 저장소는 162개, 이미지 수집 도구는 53개(24개에서 77개), 아이디어 수집 저장소는 50개(38개에서 88개) 늘었습니다. 한 저장소가 증가분의 절반 넘게 차지하는 분포에서는 합계보다 저장소별 목록이 더 많은 것을 말해 줍니다.
개수가 늘어난 자동화는 제대로 돌고 있는가?
재측정에서 가장 큰 숫자는 저장소가 아니라 자동화 쪽에 있었습니다. 크론 작업 403개, 스크립트 801개입니다. 그런데 이 숫자도 저장소 수와 같은 함정을 안고 있습니다. 개수는 "몇 개를 만들었나"를 말할 뿐, "몇 개가 제대로 도나"를 말하지 않습니다.
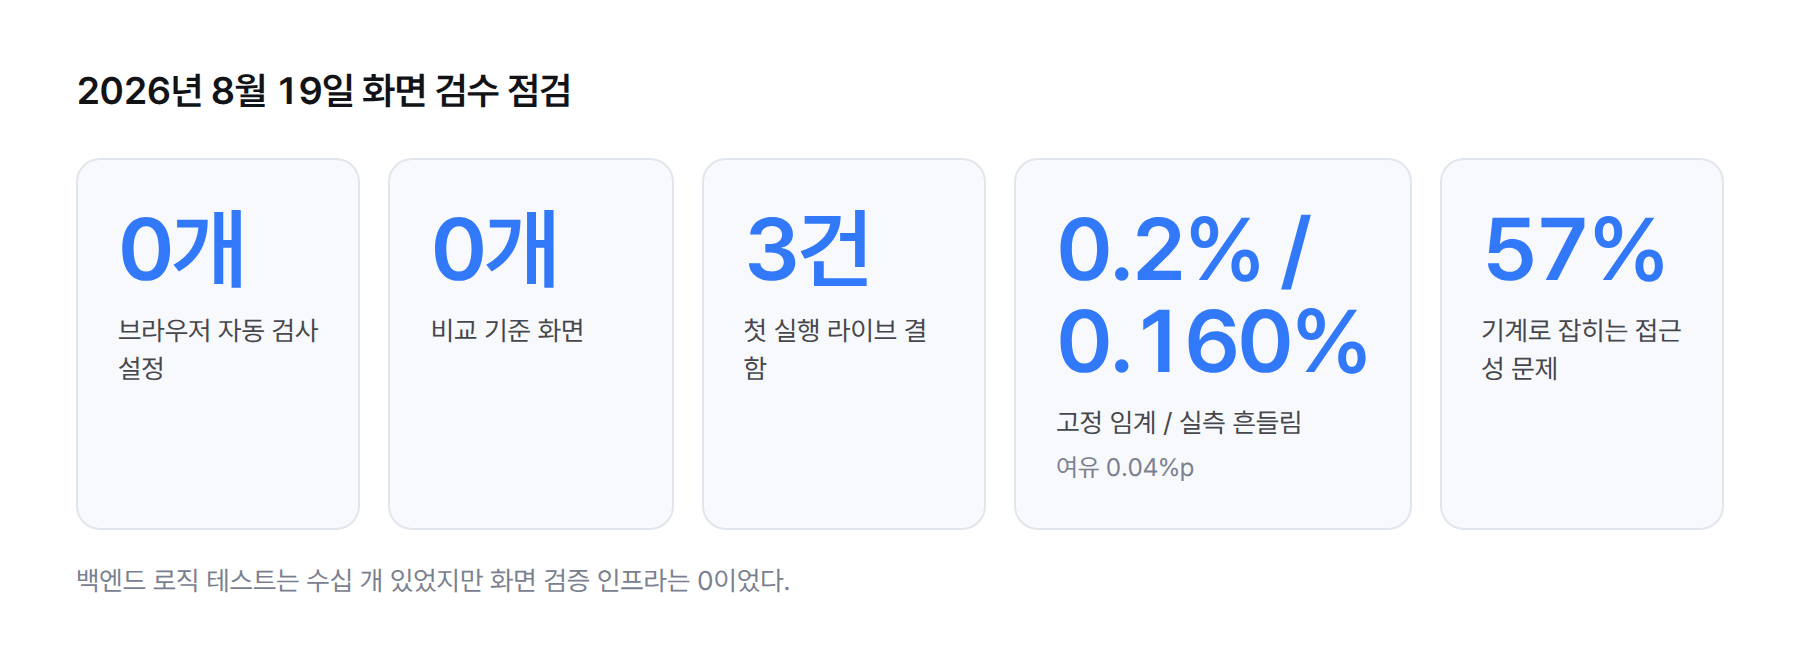
이 간극은 실제로 겪었습니다. 2026년 8월 19일에 화면 검수 체계를 점검했더니, 백엔드 로직 테스트는 사업 운영 저장소에만 수십 개가 있었는데 화면 검증 인프라는 0이었습니다. 브라우저 자동 검사 설정 파일 0개, 비교 기준 화면 0개였습니다. 이 검사를 처음 돌린 날 라이브 사이트에서 결함 3건이 나왔습니다.
검사 자체도 숫자 하나로 믿을 수 없었습니다. 화면 차이를 오류로 판정하는 고정 임계를 0.2%로 잡았는데, 실제로 재 보니 아무것도 안 바꿔도 생기는 흔들림이 0.160%였습니다. 여유가 0.04%p밖에 없어서, 흔들림을 자동으로 재는 단계를 따로 넣었습니다. 영어 페이지 첫 화면의 글자 잘림은 자동 검사를 통과하고 사람 눈에 잡혔습니다.
그래서 자동화 개수는 생산성 지표가 아니라 확인해야 할 대상의 크기로 읽기로 했습니다. 크론이 261개 늘었다는 사실은 성과이기도 하지만, 그만큼 조용히 실패할 수 있는 작업이 늘었다는 뜻이기도 합니다.
남는 한계: 이 표가 끝내 말하지 못하는 것
같은 방법으로 두 번 재도 남는 한계가 있습니다. 이 글에서 바로잡은 것은 세는 방식이지, 무엇을 세야 하는가가 아닙니다.
- 효과는 개수에 안 잡힌다: 사내 메신저 업무 비서의 응답 구조를 바꿔 최대 292초까지 늘어지던 응답을 접수 표시 3.0~5.2초, 명령 완료 3.4초로 줄였는데, 이 개선은 위 표 어디에도 나타나지 않습니다
- 회사 업무는 개수만 적었다: 회사 업무 자동화는 시스템 41개, 작업일 121일로만 적고 시스템 이름은 적지 않았습니다. 개인 저장소 표와 같은 방식으로 비교할 수 없습니다
- 일의 가짓수 규칙이 없다: 배포용 사본·시험 저장소를 어떻게 칠지 규칙이 없어 저장소 17개를 고쳐 쓰지 못했습니다
- 경계일 규칙이 없다: 기준선과 같은 날 시작한 저장소를 어느 쪽에 넣을지 아직 적지 않았습니다
- 자동 검사의 사각지대: 접근성은 기계로 57%만 잡히고, 자동 검사 통과는 "검사한 것 중 걸린 게 없다"는 뜻일 뿐입니다
한 가지 더 조심할 점이 있습니다. 지표를 고치다 보면 "이번엔 숫자가 맞다"는 확신이 생기는데, 우리 평가 규칙은 100% 통과를 목표로 삼는 것 자체를 경고 신호로 봅니다. 모든 항목이 깔끔하게 맞는 표는 덜 까다로운 질문만 던졌다는 뜻일 수 있습니다. 이번 표에서도 노무 사이트 한 쌍은 숫자가 정확히 같아서 눈에 띄었을 뿐이고, 숫자가 조금씩 다른 사본이 있었다면 같은 방법으로는 못 찾았을 겁니다.
사람 작업 커밋을 가르는 규칙도 아직 한 건씩 읽어서 검증하지는 않았습니다. 자동화가 남긴 커밋을 빼는 규칙이 하나라도 빠뜨리면, 4,612개와 8,308개 사이의 차이에 기계 작업이 섞여 들어옵니다. 저장소 목록을 한 줄씩 읽었듯이, 이 규칙도 다음 재측정 전에 표본을 직접 읽어 확인해야 같은 실수를 반복하지 않습니다.
다음 재측정에서는 이 한계 중 앞의 둘보다 뒤의 둘을 먼저 닫을 생각입니다. 배포용 사본과 경계일 규칙은 한 줄짜리 규칙으로 정할 수 있고, 정해 두면 같은 숫자가 다음에도 같은 뜻을 갖습니다. 효과를 재는 문제는 개수로 풀 수 없어서, 개선 하나마다 전후 시간을 따로 재는 방식이 맞다고 봅니다.
정리: 개발 생산성 지표를 정할 때 먼저 확인할 네 가지
개발 생산성 지표는 무엇을 셀지보다 어떻게 셀지에서 먼저 틀립니다. 두 달 비교에서 배운 순서를 적으면 다음과 같습니다.
- 두 시점을 같은 규칙으로 잰다: 규칙이 바뀐 지표는 차이를 계산하지 말고, 이유와 함께 한 시점 값만 적습니다
- 합계 옆에 항목별 목록을 둔다: 저장소마다 커밋·코드 줄 수·시작일을 적으면 중복과 시험용이 보입니다
- 분포를 본다: 증가분 3,696개 중 2,289개처럼 한쪽으로 쏠렸으면 합계가 전체를 대표하지 않습니다
- 개수와 동작을 가른다: 자동화 개수는 성과이자 확인할 대상의 크기입니다. 검증 없이 늘어난 개수는 조용한 실패 후보입니다
우리처럼 작은 팀이 업무 자동화를 늘려 가면서 무엇이 실제로 늘었는지 숫자로 남기고 싶다면, 측정 규칙부터 같이 정리해 드릴 수 있습니다. 필요하면 상담으로 연락 주세요.