무엇이 문제였나: 무엇이 늘었는지 감으로만 알았다
개발 생산성 측정은 한 가지 숫자로 하면 틀립니다. 저희는 처음에 저장소 수와 커밋 수만 보면 충분하다고 생각했고, 두 달이 채 안 되는 기간을 비교하자 그 생각이 세 군데에서 무너졌습니다.
배경부터 적겠습니다. 이 스튜디오는 개발자가 한 명입니다. 그 한 명이 AI 코딩 에이전트에게 일을 맡기고, 결과를 검토하고, 필요하면 규칙을 고칩니다. 이렇게 일하면 만드는 속도는 빨라지지만, 무엇을 얼마나 만들었는지는 오히려 흐려집니다. 어제 만든 스크립트가 오늘 다른 스크립트를 부르고, 사람이 한 번도 열어 보지 않은 파일이 정해진 시각마다 실행됩니다.
문제는 감이었습니다. "요즘 많이 만들었다"는 느낌은 있었지만, 그 느낌이 저장소가 늘어서인지, 한 저장소에서 커밋을 많이 해서인지, 아니면 자동으로 도는 작업이 늘어서인지 구분할 수 없었습니다. 구분하지 못하면 어디에 시간을 더 써야 할지도 정할 수 없습니다.
부담은 검수 쪽에서 먼저 드러났습니다. 저희가 따로 정리한 검수 원칙 문서는 이 상황을 이렇게 적어 둡니다. 활성 프로젝트 13개에 제품마다 화면이 수십 개이고, 매번 바뀔 때마다 본다면 1인이 감당하지 못한다는 내용입니다. 만든 양을 모르면 봐야 할 양도 모릅니다.
병목은 "QA 가 느리다"가 아니다. 검수량이 제품 수에 비례한다는 것이다. 그래서 실제로는 안 보게 되고, 안 보는 QA 는 없는 QA 와 같다.
그래서 2026년 8월 21일에 기준선을 한 번 찍기로 했습니다. 같은 항목을 나중에 다시 세면 무엇이 늘었는지 숫자로 말할 수 있다고 봤습니다. 이 글은 10월 11일에 다시 센 결과와, 그 사이에 측정 단위를 잘못 고른 지점을 순서대로 적은 기록입니다. 틀린 가설도 지우지 않고 남깁니다.
처음 잰 숫자는 무엇이었나
기준선 스냅샷은 2026년 8월 21일 값입니다. 측정 방법은 단순했습니다. 개인이 관리하는 코드 저장소 개수를 세고, 그 저장소들에 쌓인 커밋 가운데 사람 작업으로 표시한 커밋을 더했습니다. 여기에 AI 코딩 에이전트가 쓰는 자산 여섯 종류를 각각 파일 개수로 셌습니다.
기준선 값은 이랬습니다. 저장소 42개, 사람 작업 커밋 4,612개. AI 작업 자산은 스킬 60개, 에이전트 23개, 룰 29개, 훅 22개, 스크립트 210개, 크론 잡 142개였습니다. 코드 줄 수도 함께 셌는데, 이 숫자는 뒤에서 따로 다룹니다.
이 시점에 숫자를 고른 기준은 "세기 쉬운 것"이었습니다. 저장소와 커밋은 git이 바로 알려 주고, 스킬이나 스크립트는 폴더 안 파일을 세면 됩니다. 쉽게 셀 수 있으니 다시 셀 때도 같은 값이 나올 거라고 믿었습니다. 이 믿음이 나중에 한 항목에서 깨집니다.
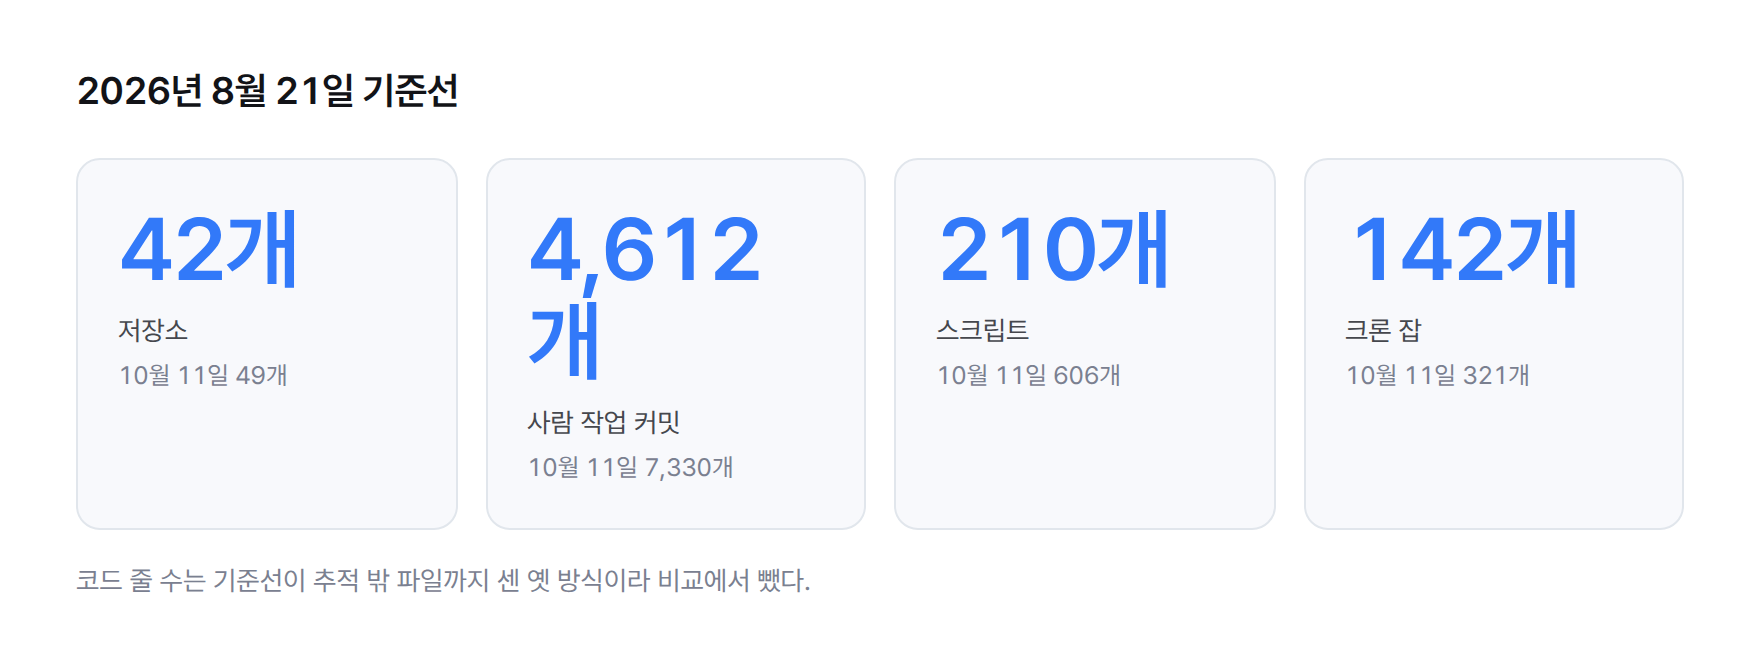
돌아보면 이 단계에서 하나가 빠져 있었습니다. 각 숫자를 어떤 방법으로 셌는지를 숫자 옆에 함께 적어 두지 않았습니다. 값은 남았는데 셈법은 남지 않았고, 그래서 두 달 뒤에 같은 이름의 숫자를 다른 방법으로 세게 됩니다.
세운 가설: 저장소와 커밋이 일한 양을 보여 준다
처음 세운 가설은 셋이었습니다. 하나, 코드 줄 수가 늘면 만든 양이 늘었다. 둘, 커밋 수가 늘면 일한 양이 늘었다. 셋, 저장소 수가 늘면 벌인 일의 폭이 넓어졌다. 셋 다 소프트웨어 팀이 흔히 쓰는 지표이고, 셋 다 git에서 바로 꺼낼 수 있습니다.
이 가설에는 숨은 전제가 있었습니다. 일이 전부 저장소 안에서 일어난다는 전제입니다. 사람이 혼자 코딩하던 시절에는 대체로 맞는 말이었습니다. 코드를 쓰면 커밋이 생기고, 새 일을 시작하면 저장소가 생깁니다.
AI 코딩 에이전트와 일하면 이 전제가 흔들립니다. 같은 일을 반복하지 않으려고 절차를 스킬로 적고, 실수를 막으려고 훅을 걸고, 사람이 매번 실행하던 일을 크론 잡으로 넘깁니다. 이런 자산은 특정 제품 저장소의 커밋으로 잡히지 않을 수 있습니다. 그래도 처음에는 이 차이를 크게 보지 않았습니다.
가설은 어디서 틀렸나
10월 11일에 같은 항목을 다시 세자 세 가설이 각각 다른 방식으로 틀렸습니다. 하나씩 적습니다.
첫째, 코드 줄 수는 비교 자체가 성립하지 않았습니다. 재측정 값은 1,463,406줄입니다. 그런데 기준선의 줄 수는 git이 추적하지 않는 파일까지 센 옛 방식으로 잰 값이었습니다. 빌드 결과물이나 내려받은 파일처럼 사람이 쓰지 않은 파일이 섞였을 수 있는 셈법이고, 지금 값은 그 방식이 아닙니다. 두 값을 빼면 실제 성장과 셈법 차이가 한데 섞여 나오기 때문에, 이 항목은 숫자만 적고 비교에서 뺐습니다. 이 결정의 경위는 코드 라인 수로 성장을 비교하지 않은 이유에 따로 정리했습니다.
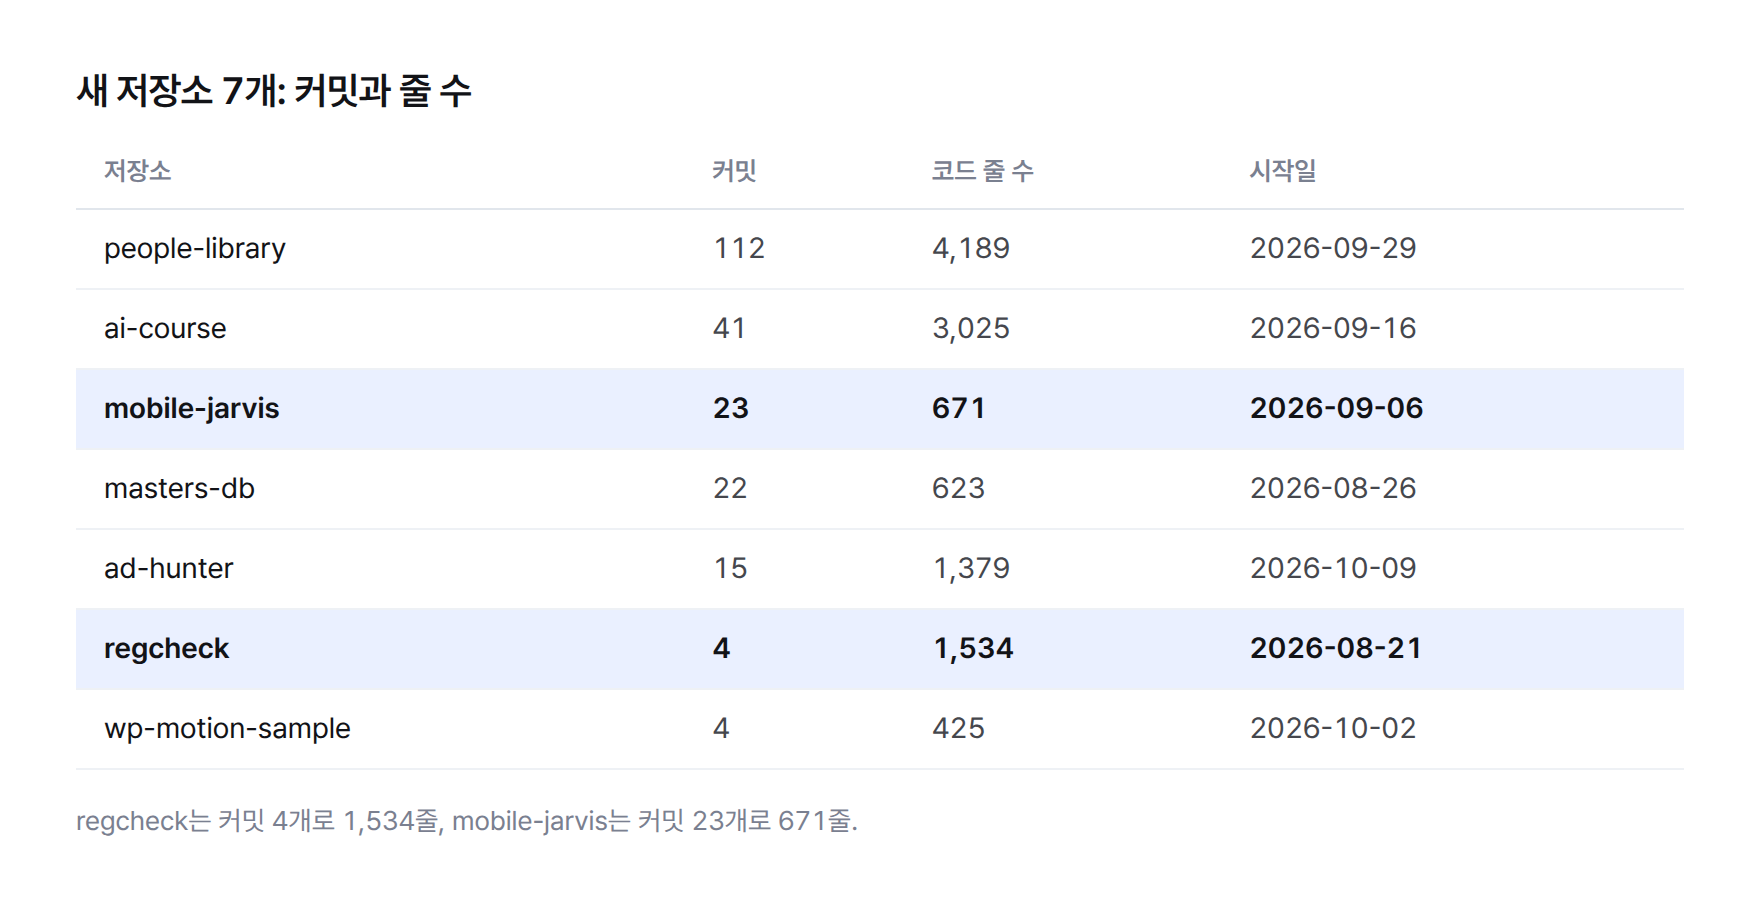
둘째, 커밋 수는 저장소의 크기와 엇갈렸습니다. 이 기간에 새로 만든 저장소 7개를 보면 잘 드러납니다. regcheck는 커밋 4개로 1,534줄이고, mobile-jarvis는 커밋 23개로 671줄입니다. 커밋이 다섯 배 넘게 많은 쪽이 오히려 코드가 적습니다. wp-motion-sample도 커밋 4개지만 줄 수는 425줄로 regcheck와 크게 다릅니다. 커밋 하나에 담기는 일의 크기가 저장소마다 달라서, 커밋 개수만으로는 일의 양을 비교할 수 없었습니다.
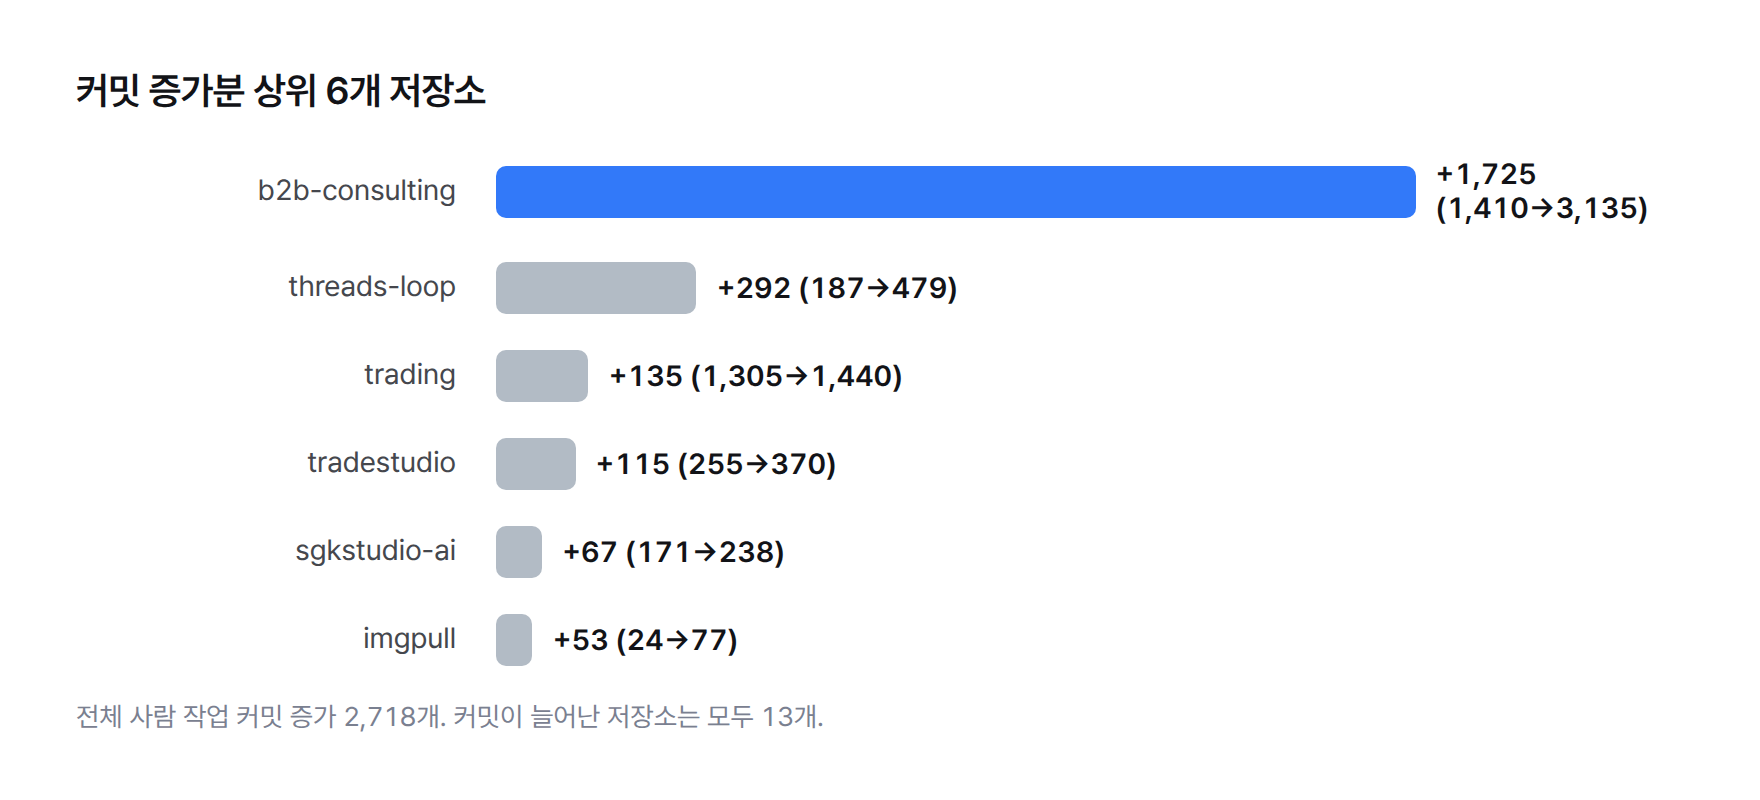
셋째, 커밋 증가분은 한 곳에 몰려 있었습니다. 사람 작업 커밋은 4,612개에서 7,330개로 2,718개 늘었는데, 그중 1,725개가 저장소 하나에서 나왔습니다. 회사 홈페이지와 영업 자료를 함께 담은 저장소로, 커밋이 1,410개에서 3,135개가 됐습니다. 커밋이 늘어난 저장소는 모두 13개였지만, 아래쪽 네 곳은 9개, 5개, 4개, 3개씩 늘었을 뿐입니다. 전체 합계만 봤다면 "모든 저장소에서 고르게 일했다"고 읽었을 겁니다.
넷째로, 이건 가설이 틀렸다기보다 가설이 아예 보지 못한 부분입니다. 저장소는 7개 늘었는데 스크립트는 396개, 크론 잡은 179개, 훅은 37개 늘었습니다. 늘어난 일의 상당 부분이 저장소 개수로는 잡히지 않는 자리에서 일어났습니다.
새 저장소 7개는 무엇을 말해 주나
새 저장소 7개는 커밋 수가 무엇을 담지 못하는지 한 번 더 보여 줍니다. 커밋이 많으면 오래 손댄 저장소일 거라고 짐작하기 쉬운데, 시작일을 옆에 놓으면 그 짐작도 맞지 않습니다.
시작일 순서로 보면 regcheck가 2026년 8월 21일로 가장 먼저 시작했고, masters-db가 8월 26일, mobile-jarvis가 9월 6일, ai-course가 9월 16일, people-library가 9월 29일, wp-motion-sample이 10월 2일, ad-hunter가 10월 9일에 시작했습니다. 가장 먼저 시작한 regcheck의 커밋은 4개이고, 일곱 곳 중 늦게 시작한 편인 people-library의 커밋은 112개입니다.
즉 커밋 수는 저장소의 나이도, 코드의 양도 따라가지 않았습니다. 커밋은 "얼마나 자주 저장했는가"에 가깝고, 그 빈도는 작업 성격에 따라 달라집니다. 한 번에 큰 덩어리를 만드는 작업이면 커밋이 적고, 작은 수정을 여러 번 되풀이하는 작업이면 커밋이 많습니다. 그래서 새 저장소는 커밋 수, 코드 줄 수, 시작일 세 값을 함께 적기로 했습니다. 세 값을 나란히 두어야 각 저장소가 어떤 종류의 일이었는지 짐작이라도 할 수 있습니다.
진짜 원인은 무엇이었나
원인은 두 가지였습니다. 하나는 셈법을 숫자와 함께 남기지 않았다는 점이고, 다른 하나는 측정 단위를 하나로 잡았다는 점입니다.
셈법 문제는 코드 줄 수에서 드러났습니다. 같은 이름의 숫자라도 두 시점의 셈법이 다르면 차이는 성장이 아니라 방법의 차이입니다. 저희는 기준선을 찍을 때 값만 기록했고, 무엇을 포함하고 무엇을 뺐는지는 적지 않았습니다. 그 결과 가장 큰 숫자인 코드 줄 수를 비교에 쓸 수 없게 됐습니다.
단위 문제는 AI 코딩 에이전트와 일하는 방식에서 나왔습니다. 사람이 직접 코딩할 때는 일의 결과가 거의 다 커밋으로 남습니다. 에이전트와 일하면 결과의 일부가 "다음번에 같은 일을 덜 하게 만드는 장치"로 남습니다. 절차를 적은 스킬, 실수를 막는 훅, 사람 대신 도는 크론 잡이 그렇습니다. 이 장치들은 제품 저장소의 커밋이나 저장소 개수로는 크기가 보이지 않습니다.
두 원인은 같은 뿌리를 공유합니다. 세기 쉬운 숫자를 골랐고, 그 숫자가 실제로 무엇을 담는지는 확인하지 않았습니다. 평가 실무 문서에도 같은 경고가 있습니다. 측정할 수 있는 것만 측정하면 진짜 문제를 놓친다는 내용입니다.
"일단 evaluator부터 짜고 데이터는 나중에" → 측정 가능한 것만 측정, 진짜 문제 놓침.
어떻게 고쳤나: 같은 방법으로 센 것만 비교한다
조치는 측정 기록의 모양을 바꾸는 일이었습니다. 새 도구를 만들지 않았고, 대신 숫자를 적는 규칙을 다섯 가지로 정했습니다.
- 기준선 날짜를 기록 맨 위에 고정합니다. 이번 비교의 기준선은 2026년 8월 21일 스냅샷입니다.
- 숫자를 다섯 묶음으로 나눕니다. 개인 저장소 합계, 새로 만든 저장소, 커밋이 늘어난 저장소, AI 작업 자산, 회사 업무입니다.
- 셈법이 바뀐 항목은 지금 값만 적고, 비교하지 않는 이유를 그 자리에 한 줄로 남깁니다. 코드 줄 수가 첫 사례입니다.
- 새 저장소는 커밋 수만 적지 않고 코드 줄 수와 시작일을 함께 적습니다. 커밋 하나의 크기가 저장소마다 다르기 때문입니다.
- 회사 업무 자동화는 시스템 이름과 경로를 빼고 개수와 작업일만 적습니다. 공개 범위 밖 정보이기 때문입니다.
이 규칙은 저희가 화면 검수에 쓰는 원칙과 같은 생각에서 나왔습니다. 검수 원칙 문서는 사람이 한 번 승인한 화면을 기준으로 얼려 두고 그 뒤로는 바뀐 것만 보라고 적습니다. 측정도 같습니다. 기준선을 한 번 얼려 두면 그 뒤로는 같은 방법으로 센 차이만 보면 됩니다.
같은 화면을 두 번 보지 않는다. 승인 = baseline 동결.
숫자를 세는 일 자체는 AI에게 판단을 맡기지 않았습니다. 파일 개수와 커밋 개수는 같은 명령을 다시 돌리면 같은 값이 나와야 하는 숫자입니다. 검수 원칙 문서가 적어 둔 대로 작성은 AI가 하더라도 매번의 실행은 결정론으로 돌려야 결과가 흔들리지 않습니다. 측정에도 이 원칙을 그대로 적용했습니다.
LLM 은 불변식·시나리오를 쓰는 단계에만 쓰고, 매 실행은 결정론 엔진이 돈다. 빠르고 싸고 결과가 흔들리지 않는다.
묶음을 나눈 효과는 바로 보였습니다. 커밋이 늘어난 저장소 13곳을 따로 적자 한 저장소에 몰린 증가분이 드러났고, AI 작업 자산을 따로 적자 저장소 개수로는 안 보이던 증가가 드러났습니다. 합계 한 줄로는 둘 다 보이지 않았습니다.
같은 문서에는 또 하나 새겨 둘 문장이 있습니다. 통과는 "검사한 것 중 걸린 게 없다"일 뿐이라는 문장입니다. 측정 숫자도 마찬가지로, 센 것만 말해 주고 세지 않은 것은 말해 주지 않습니다. 그래서 각 묶음 옆에 무엇을 세지 않았는지도 함께 남깁니다.
재측정 결과: 10월 11일에 다시 센 숫자
2026년 10월 11일 재측정 값입니다. 측정 방법은 기준선과 같고, 코드 줄 수만 위에서 정한 규칙에 따라 비교에서 뺐습니다.
개인 자산부터 보면 저장소는 42개에서 49개로 7개, 사람 작업 커밋은 4,612개에서 7,330개로 2,718개 늘었습니다. 새 저장소 7개 가운데 커밋이 가장 많은 곳은 people-library로 커밋 112개, 4,189줄이고 2026년 9월 29일에 시작했습니다. 가장 최근에 시작한 ad-hunter는 10월 9일에 시작해 커밋 15개, 1,379줄입니다.
AI 작업 자산은 여섯 종류 모두 늘었지만 늘어난 폭이 크게 달랐습니다. 스킬은 60개에서 71개로 11개, 에이전트는 23개에서 28개로 5개, 룰은 29개에서 32개로 3개 늘었습니다. 반면 훅은 22개에서 59개로 37개, 스크립트는 210개에서 606개로 396개, 크론 잡은 142개에서 321개로 179개 늘었습니다.
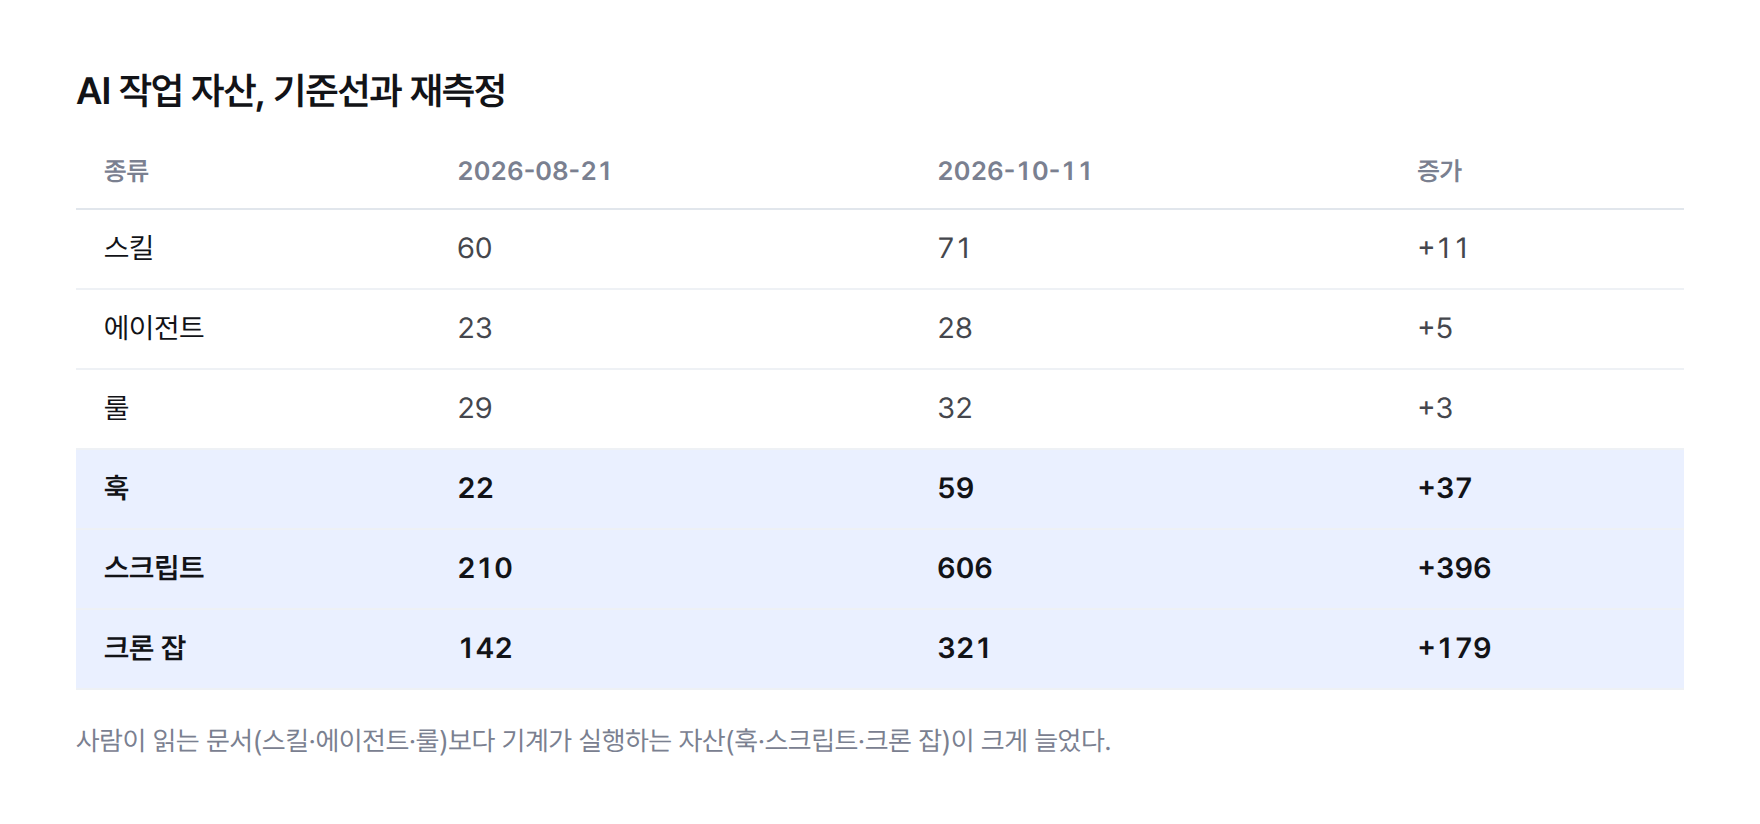
이 표에서 읽을 수 있는 경향은 하나입니다. 사람이 읽고 판단하는 문서인 스킬·에이전트·룰은 조금 늘었고, 기계가 스스로 실행하는 훅·스크립트·크론 잡은 크게 늘었습니다. 스크립트는 세 배 가까이 됐고, 커밋은 절반 남짓 늘었습니다. 제목에 쓴 "커밋보다 자동화 스크립트가 빨리 늘었다"는 이 비교에서 나왔습니다.
저장소별로 나눠 보면 다른 면도 보입니다. 커밋이 늘어난 13곳 가운데 기준선 커밋이 1,305개로 두 번째로 많던 trading 저장소는 1,440개가 되어 135개 늘었고, 기준선 커밋이 187개였던 threads-loop는 479개로 292개 늘었습니다. 기준선의 크기와 이후의 증가가 서로 따로 움직였다는 뜻입니다. 큰 저장소라고 계속 크게 자라지 않았고, 작은 저장소가 짧은 기간에 두 배 넘게 자라기도 했습니다. 합계만 봤다면 이 차이는 전혀 드러나지 않았을 겁니다.
회사 업무 자동화는 같은 기록에 개수만 남겼습니다. 시스템 37개, 작업일 99일입니다. 이 묶음은 기준선이 따로 없어 전후 비교는 하지 않았습니다.
늘어난 자동화는 무엇을 뜻하나
스크립트와 크론 잡이 늘었다는 사실을 "생산성이 올랐다"로 바로 읽으면 다시 같은 실수를 하게 됩니다. 개수는 투입의 흔적이지 결과가 아닙니다. 크론 잡 321개가 각각 사람 일을 얼마나 대신하는지는 이 숫자에 들어 있지 않습니다. 이 질문은 자동화 성과 측정 글에서 따로 쟀습니다.
훅도 마찬가지입니다. 훅이 59개라는 숫자는 그중 몇 개가 실제로 작업을 막는지 알려 주지 않습니다. 사내 검증 규칙 문서는 이 차이를 분명히 적어 둡니다. 훅 스크립트가 종료 코드 1로 끝나면 경고만 남고 작업은 계속되고, 종료 코드 2로 끝나야 실제로 막힙니다. 경고만 하는 훅을 아무리 늘려도 막는 힘은 늘지 않습니다.
exit 1은 warning-only. 실수로 exit 1만 쓰면 hook이 "동작"하는 듯 보이나 실제 차단은 0.
반대로 자동화가 늘어난 만큼 살펴볼 일도 늘었습니다. 기계가 혼자 도는 작업이 많아질수록 그 작업이 조용히 틀렸을 때 알아챌 장치가 필요합니다. 이 부담을 어떻게 줄였는지는 QA 자동화, 검수량을 줄인 기록에 정리했습니다.
남는 한계는 무엇인가
이번 비교에도 한계가 다섯 있습니다. 숨기지 않고 적습니다.
- 개수는 결과가 아닙니다. 저장소·커밋·스크립트 수는 얼마나 만들었는지를 보여 줄 뿐, 만든 결과물이 매출이나 시간 절감으로 이어졌는지는 보여 주지 않습니다.
- "사람 작업" 커밋을 어떤 기준으로 골랐는지는 이 측정 기록에 적혀 있지 않습니다. 기준선과 재측정이 같은 기준을 썼다는 전제 위에서만 2,718개라는 차이를 믿을 수 있습니다.
- 코드 줄 수는 이번에 비교하지 못했습니다. 지금 값 1,463,406줄을 새 기준선으로 삼아 다음 스냅샷에서야 처음으로 같은 방법끼리 비교할 수 있습니다.
- AI 작업 자산은 파일 개수로만 셌습니다. 같은 스크립트라도 크기와 쓰임이 제각각이라, 396개 증가가 같은 무게의 일 396개를 뜻하지는 않습니다.
- 회사 업무 자동화 묶음(시스템 37개, 작업일 99일)은 이 측정 기록에 기준선 값이 없습니다. 이 묶음의 변화는 다음 재측정부터 볼 수 있습니다.
그래도 이번 비교로 분명히 얻은 게 있습니다. 기준선을 한 번 고정하고 같은 방법으로 다시 세자, 감으로는 구분하지 못하던 세 가지가 갈라졌습니다. 일이 어느 저장소에 몰렸는지, 어떤 숫자는 비교할 수 없는지, 그리고 늘어난 일이 저장소 바깥의 자동화 쪽으로 옮겨 갔는지입니다.
다음 측정에서는 셈법을 숫자 옆에 함께 적습니다. 그래야 다음 재측정 때 같은 이름의 다른 숫자를 비교하는 일이 다시 생기지 않습니다. 1인 개발이나 작은 팀에서 AI 코딩 에이전트로 일하며 무엇을 세야 할지 고민하고 있다면, 저희가 쓰는 측정 기록 형식을 상담에서 함께 보실 수 있습니다.