이미지 원본 다운로드는 왜 썸네일에서 끝났나?
이미지 원본 다운로드가 썸네일에서 끝난 이유는 도구가 실패를 실패로 알리지 않았기 때문입니다. 출발점은 질문 하나였습니다. 구글이나 핀터레스트 말고 다른 여러 사이트에서도, 목록에 뜬 축소본이 아니라 클릭했을 때 나오는 원본이 정말 받아지느냐는 질문이었습니다.
겉으로는 문제가 없어 보였습니다. 명령을 돌리면 파일이 생기고, 프로그램은 종료 코드 0(exit 0, 정상 종료)으로 끝났습니다. 단위테스트 82건도 같은 시점에 전부 통과했습니다. 그런데 저장된 파일을 열어 보면 상황이 달랐습니다. 목록 화면에 걸린 작은 썸네일, 사이트 로고 한 장, 혹은 아무것도 없는 폴더가 ‘완료’라는 이름으로 남아 있었습니다.
이미지 수집에서 이 실패는 비용이 큽니다. 쇼핑몰 상품 사진을 옮기거나 블로그 글의 사진을 백업하는 일이라면, 썸네일 수백 장은 0장보다 나쁩니다. 0장이면 다시 돌리지만 썸네일은 작업이 끝났다고 믿게 만들고, 쓸 수 없다는 사실은 나중에 그 사진을 화면에 크게 띄울 때에야 드러납니다.
성공을 장수로만 말하지 않는다. 0장은 실패다.
그래서 이번 작업의 첫 원칙은 ‘몇 장 받았나’ 대신 ‘얼마나 큰 걸 받았나’를 재는 일이었습니다. 비슷한 이유로 자동화가 겉으로는 성공처럼 보이다가 화면 밖 상태에서 막힌 사례는 본인인증 자동화 실패 원인 기록에도 남겨 두었습니다.
처음 잰 숫자: 차단 안 된 10곳 중 5곳이 축소본
측정은 단순하게 했습니다. 실제 사이트 13곳을 고르고, 옵션을 하나도 바꾸지 않은 기본값으로 돌린 뒤, 저장된 파일의 픽셀 크기를 하나씩 쟀습니다. 2026년 9월 17일의 일입니다. 13곳 가운데 3곳은 봇 차단 신호가 떠서 판단 대상에서 뺐습니다.
남은 10곳 중 5곳이 원본을 받지 못했습니다. 썸네일을 받은 곳, 로고를 받은 곳, 0장을 받은 곳이 섞여 있었고, 다섯 곳 모두 exit 0이었습니다. 절반이 틀린 결과를 내는데 프로그램도 테스트도 아무 신호를 주지 않은 셈입니다.
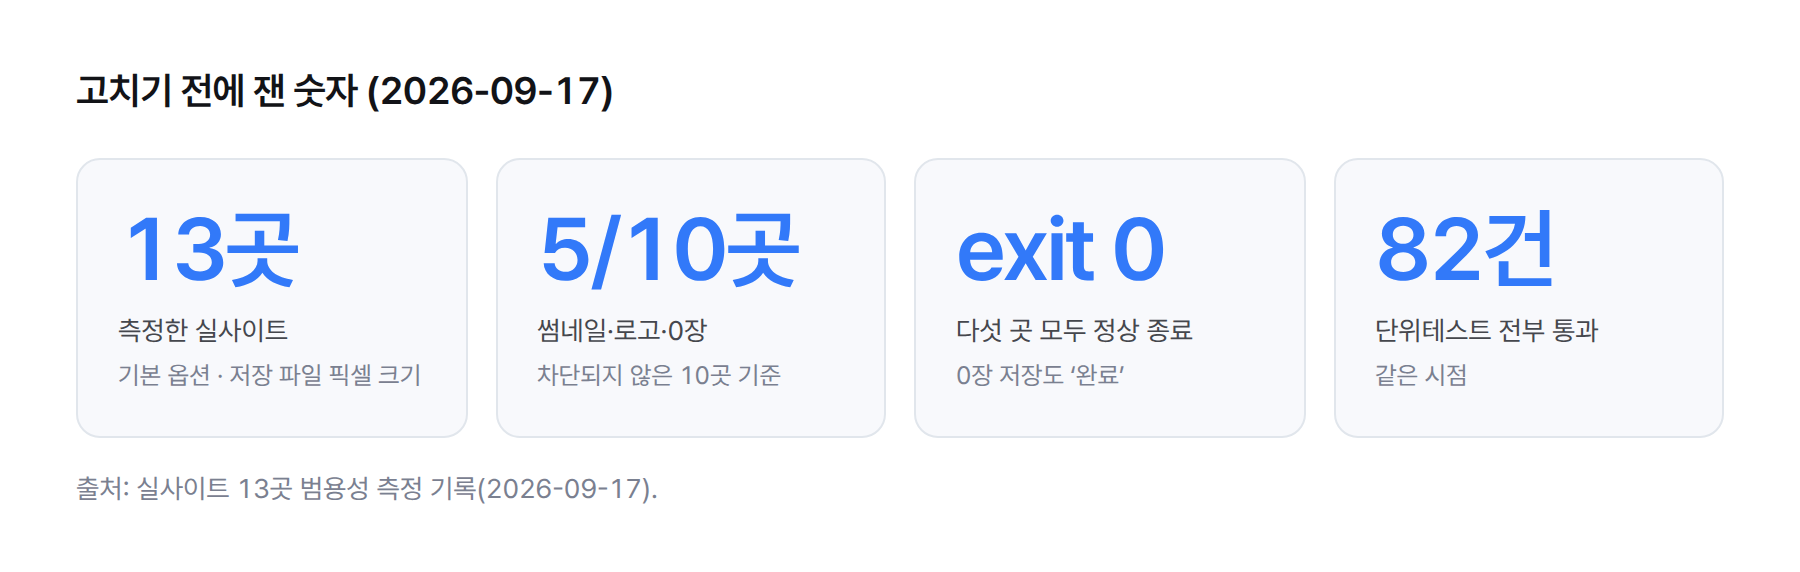
사이트별로 보면 더 구체적이었습니다. 이미지 게시판인 safebooru는 기본값(auto)으로 돌리면 250px짜리를 받았는데, 브라우저 방식을 직접 지정(`--tier browser`)하면 2688px짜리를 받았습니다. 같은 도구, 같은 주소인데 방식에 따라 열 배 넘게 차이가 났습니다. 위키백과는 60여 장이 있는 목록 페이지에서 1장만 받았습니다. 네이버 블로그는 0장이었습니다. 무신사는 상품 사진 대신 공유용 대표 이미지(og 이미지)에 걸린 로고 1장을 받았습니다. 연합뉴스는 사진 사이에 광고 2장이 섞여 들어왔습니다.
측정 기준도 여기서 정했습니다. 같은 주소, 같은 옵션(`--limit 12`, 12장까지 받기)으로 전후를 비교하고, 각 사이트에서 받은 이미지의 긴 변 픽셀을 봅니다. 고친 뒤에도 이 기준을 그대로 씁니다. 개선율만 적으면 250px이 300px이 된 경우도 ‘20% 개선’으로 보이기 때문에, 이 글은 절대값을 같이 적습니다.
세운 가설: 원본을 찾는 장치가 일부 방식에만 있다
가장 먼저 눈에 띈 단서는 safebooru의 250px과 2688px 차이였습니다. 이 도구에는 썸네일을 누르면 열리는 상세페이지로 따라 들어가 원본을 찾는 장치(상세페이지 추적)가 이미 있었습니다. 다만 그 장치는 브라우저 방식과 실제 크롬 방식에만 들어 있었습니다. 기본값은 정적 방식부터 시도하고, 정적 방식이 1장만 저장해도 거기서 끝납니다. 정적 방식이 썸네일 몇 장을 건지면 원본을 찾을 줄 아는 브라우저 방식에는 차례가 오지 않았습니다.
여기서 해법 두 개가 바로 떠올랐습니다.
- 가설 1: 순서가 문제다. 기본값의 순서를 뒤집어 브라우저 방식을 먼저 돌리면 원본 추적이 늘 작동한다
- 가설 2: 주소 규칙이 모자라다. 이미지 서버(CDN)마다 주소에 붙는 축소 신호를 지우는 규칙을 아는 대로 다 넣으면 원본 주소를 바로 만들 수 있다
두 가설 모두 그럴듯했고, 실제로 일부 사이트에서는 효과가 있었을 겁니다. 하지만 둘 다 끝까지 따라가 보면 다른 결과가 나왔습니다.
가설은 어디서 틀렸나?
가설 1은 비용에서 틀렸습니다. 브라우저 방식을 먼저 돌리면 정적 방식으로 금방 끝나던 사이트가 몇 배 느려집니다. 이전에 같은 안을 기각한 이유도 이것이었습니다. 게다가 헤드리스 브라우저가 막히는 사이트에서 정적 방식이 통하던 경우까지 잃습니다. 변형안으로 ‘목록 구조의 페이지면 무조건 브라우저로 넘긴다’도 검토했지만, 관련글 썸네일 때문에 거의 모든 페이지가 목록 구조로 잡혔습니다. 사실상 가설 1과 같아지는 안이었습니다.
가설 2는 결과에서 틀렸습니다. 네이버 블로그 이미지 서버(postfiles)는 주소의 `type` 값이 축소 신호처럼 보입니다. 그런데 이 값을 지우면 원본이 아니라 94px짜리가 왔습니다. ‘축소 신호를 지우면 원본’이라는 전제가 이 서버에서는 거짓이었습니다. 틀린 규칙은 결과를 그대로 두지 않고 더 나쁘게 만듭니다. 그래서 규칙은 라이브로 더 큰 응답을 확인한 6종만 넣고, 나머지 15종은 실패가 예상되는 테스트(xfail)로 빈자리만 표시해 두었습니다.
세 번째 후보도 있었습니다. 썸네일과 받은 원본이 같은 그림인지 지각 해시로 비교해 검증하는 방법입니다. 이건 보류했습니다. 브라우저 안에서 다른 도메인 이미지를 캔버스에 그리면 보안 정책(교차 출처 캔버스 오염) 때문에 계산이 자주 막히고, 가운데만 잘라 낸 썸네일은 원본과 해시가 어긋납니다.
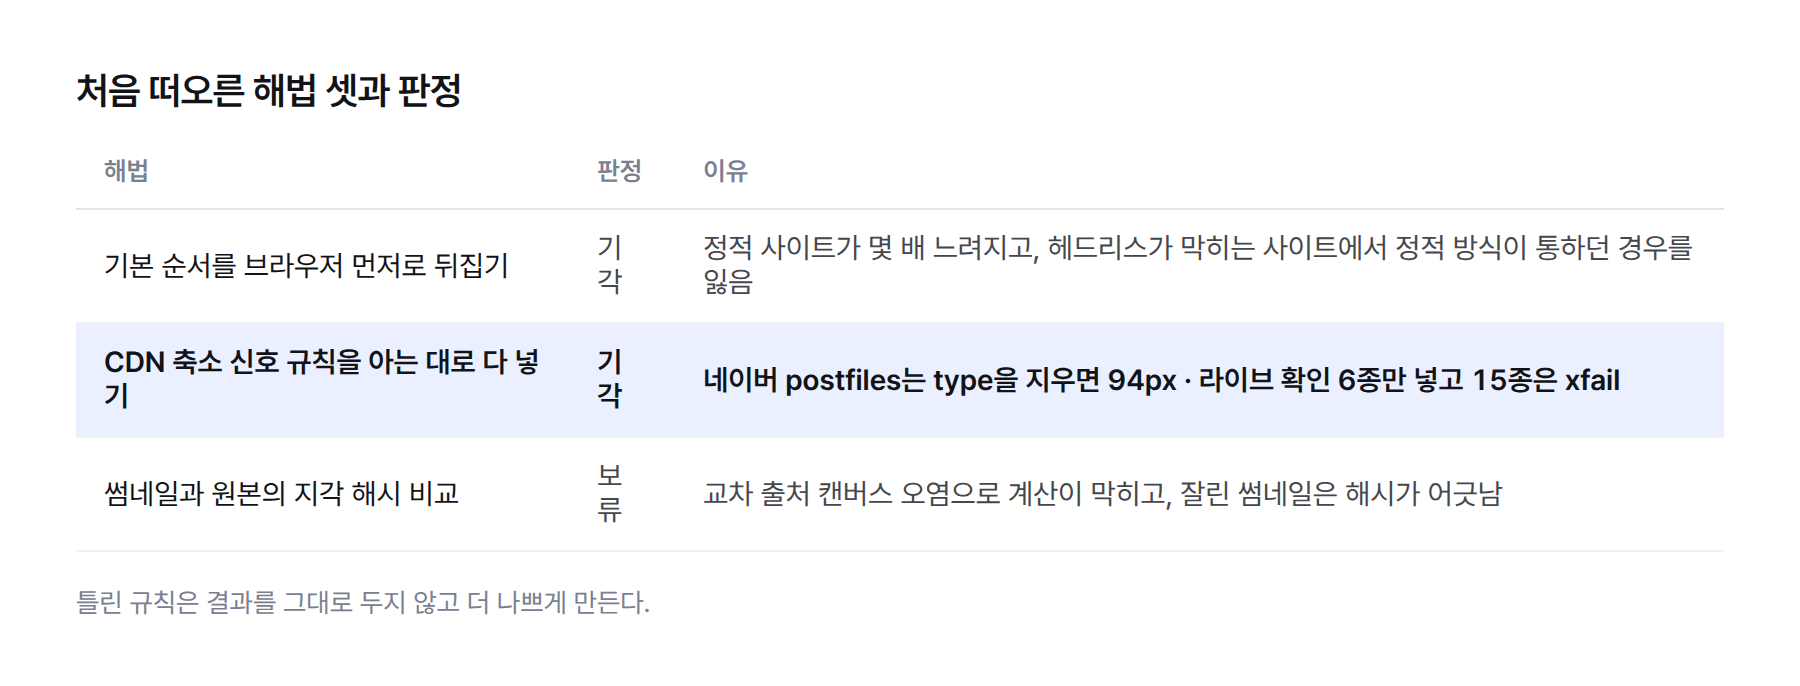
가설을 버리고 나니 질문이 바뀌었습니다. ‘원본 찾는 장치를 어떻게 더 자주 부르나’가 아니라 ‘왜 장치가 있는데도 이미지 하나하나에 닿지 못하나’였습니다.
진짜 원인은 무엇이었나? 작업 단위가 페이지였다
진짜 원인은 도구가 일을 ‘페이지’ 단위로 나누고 있었다는 점입니다. 원본을 찾을지 말지, 성공했는지 실패했는지를 페이지 하나에 한 번씩 판정했습니다. 원본은 이미지마다 따로 있는데 판정은 페이지마다 한 번이니, 한 이미지의 결과가 나머지 전체의 운명을 정했습니다. 진단한 결함 일곱 개를 전부 재현해 보니 대부분이 이 구조에서 나왔습니다.
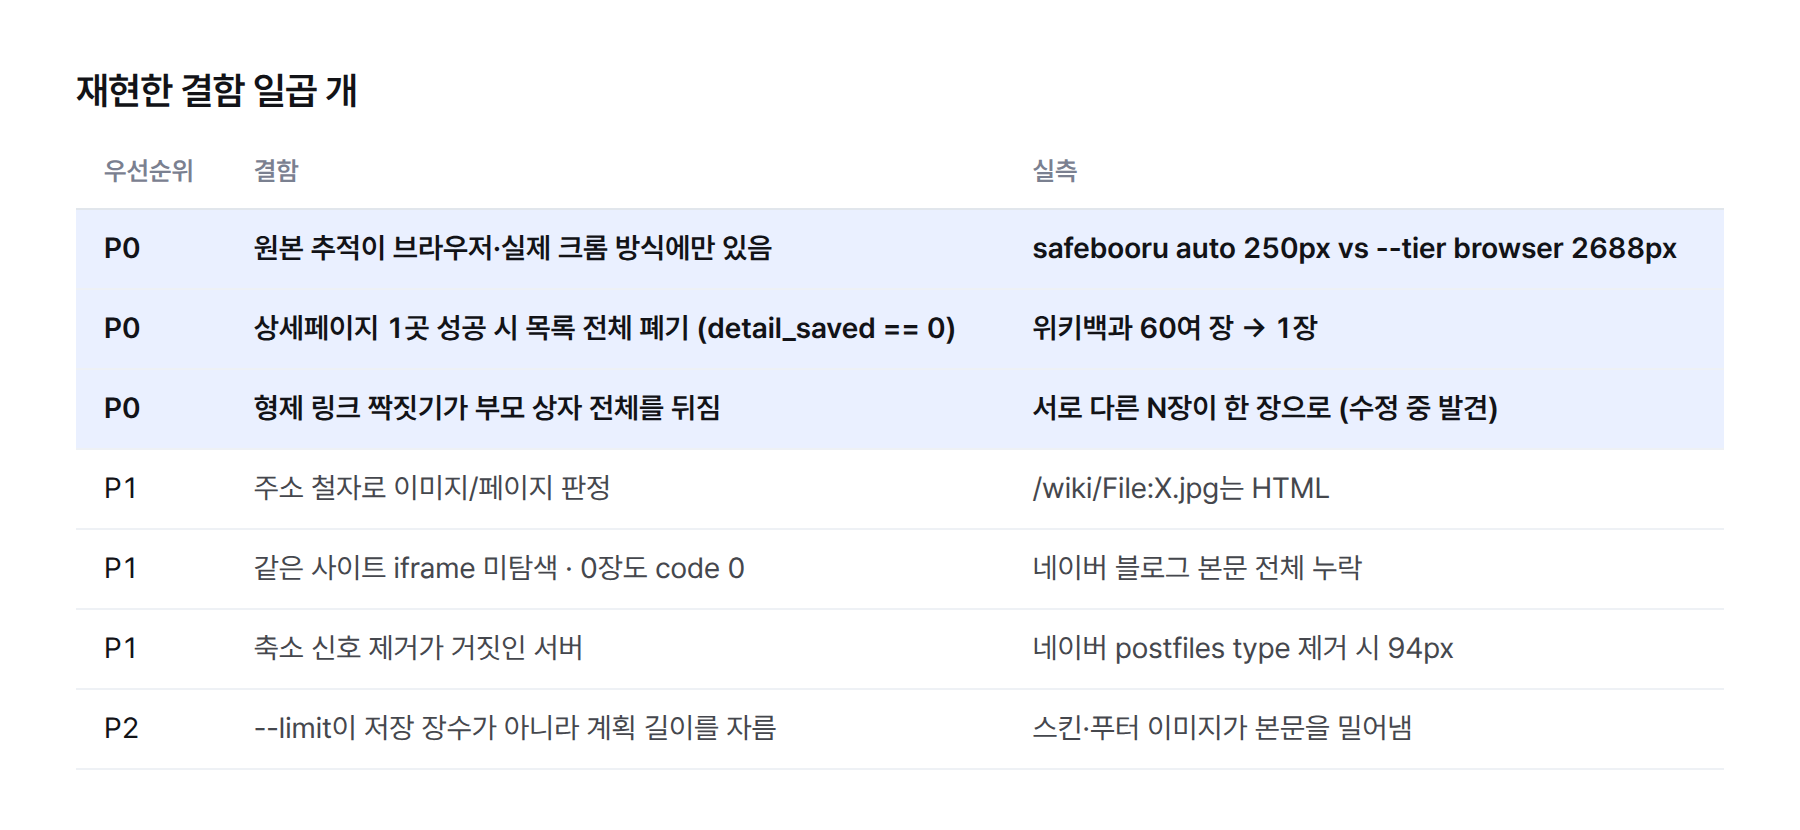
첫째, 상세페이지가 한 곳이라도 성공하면 목록 전체를 버렸습니다. 코드는 ‘상세페이지에서 저장한 장수가 0일 때만 목록 이미지를 쓴다(`detail_saved == 0`)’는 조건이었습니다. 위키백과에서 60여 장이 1장으로 줄어든 이유입니다. 한 장의 원본을 찾은 순간 나머지 이미지는 시도조차 하지 않았습니다.
둘째, 이미지와 링크를 짝짓는 범위가 너무 넓었습니다. 이미지에 직접 링크가 없으면 옆에 있는 링크(형제 앵커)를 찾는데, 그 범위가 부모 상자 전체였습니다. 그래서 링크 없는 이미지 여러 장이 같은 상자 안의 아무 직링크나 ‘자기 원본’으로 가져갔고, 서로 다른 N장이 한 장으로 합쳐졌습니다. 이 결함은 처음 진단에는 없었고, 수정하는 도중 테스트용 고정 페이지(픽스처)에서 발견했습니다.
셋째, 이미지인지 페이지인지를 주소 철자로 갈랐습니다. 위키백과의 `/wiki/File:X.jpg`는 `.jpg`로 끝나지만 실제로는 HTML 페이지입니다. 철자만 보고 이미지라고 받으니 원본 대신 엉뚱한 응답이 왔습니다.
나머지도 같은 뿌리였습니다. 같은 사이트의 iframe 안을 보지 않아 네이버 블로그는 본문 전체가 빠졌고, 0장 저장도 코드 0 ‘완료’로 끝났습니다. `--limit` 옵션은 저장 장수가 아니라 처리 계획의 길이를 잘랐습니다. 그래서 페이지 앞쪽에 있는 스킨·푸터 이미지가 계획의 앞자리를 차지해 본문 이미지를 밀어냈습니다. 12장을 받으라고 하면 본문 사진 12장이 아니라 페이지 맨 위부터 12개 자리를 처리한 셈입니다.
단위테스트 82건이 이걸 하나도 잡지 못한 이유도 여기서 풀립니다. 테스트는 함수가 정해진 입력에 정해진 출력을 내는지 봅니다. ‘받은 파일이 원본 크기인가’는 어떤 테스트도 묻지 않았습니다.
조치: 이미지마다 클릭 대상을 짝짓는다
방향은 이전 결정을 유지했습니다. 다음 방식으로 넘어가는 조건은 건드리지 않고, 세 방식의 능력을 똑같이 맞추는 방향입니다. 바뀐 것은 능력의 단위입니다. 세 방식이 같은 항목 모양 `{s, extra, click, chrome, nw, nh}`와 같은 계획 함수 `plan_items`를 씁니다. 항목 하나가 이미지 하나이고, 그 이미지를 눌렀을 때 가는 곳(click)이 항목 안에 같이 들어갑니다.
이미지 하나는 이 순서로 처리합니다. 클릭 대상을 먼저 시도하고, 안 되면 그 이미지 자신의 후보 주소를 큰 것부터 내려가며 시도하고(후보 사다리), 마지막으로 화면에 뜬 주소를 받습니다.
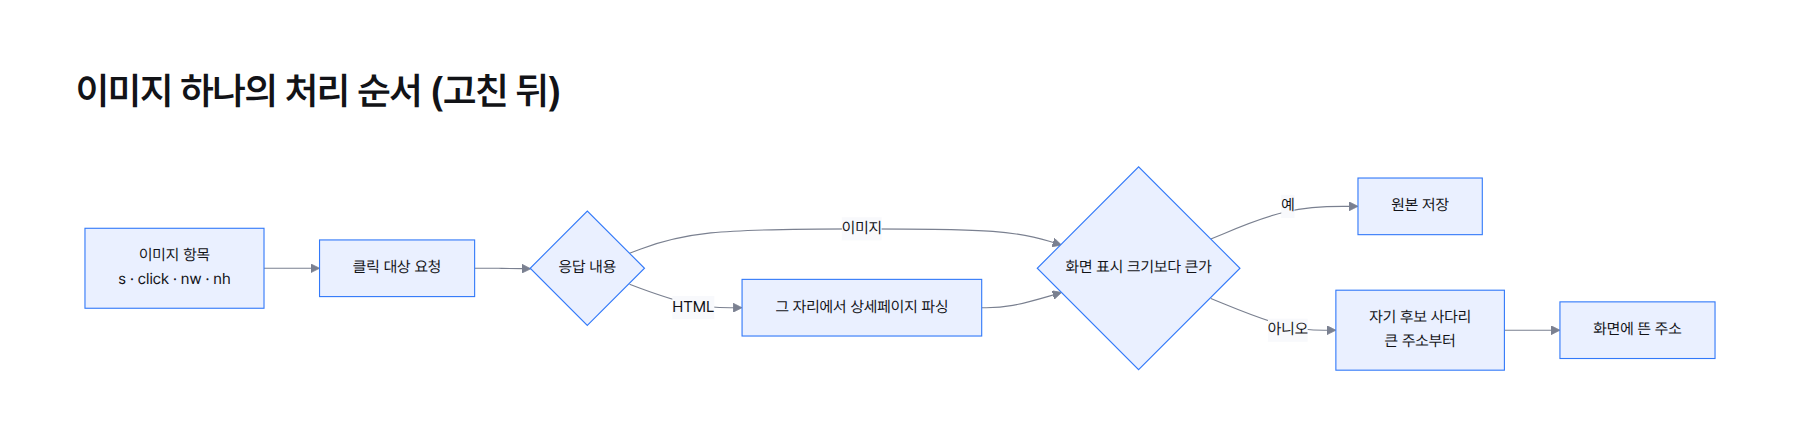
클릭 대상이 이미지인지 페이지인지는 철자가 아니라 응답이 정합니다. 응답이 HTML이면 그 자리에서 상세페이지로 파싱합니다. 정적 방식은 `best_images_static` 함수로, 브라우저 방식은 띄워 둔 페이지의 라이브 DOM으로, 실제 크롬 방식은 DOMParser로 읽습니다.
브라우저 쪽에서는 클릭 대상을 ‘이미지 한가운데를 눌렀을 때 실제로 걸리는 요소’로 짚습니다. 이미지 위에 투명한 덮개(overlay)가 있거나 자바스크립트가 나중에 링크를 끼워 넣는 사이트가 많아서, HTML 구조만 보고 짝지으면 놓칩니다. 화면 밖 이미지는 잠깐 화면으로 데려와 짚습니다. 헤더·내비게이션 안의 이미지는 추적하지 않습니다. 로고를 누르면 홈 화면으로 가고, 홈 화면의 큰 이미지를 그 로고의 원본으로 착각하는 부류를 이 규칙 하나로 막았습니다.
검증은 두 겹입니다.
- 바닥선(floor): 화면에 표시된 크기보다 작은 응답은 원본으로 인정하지 않는다
- 사전 표본: 정적 방식은 저장 전에 앞 3장을 받아 보고, 전부 썸네일 크기면 아무것도 저장하지 않고 브라우저 방식으로 넘긴다
- 리포트: 장수와 함께 긴 변 중앙값을 적고, 600px 미만이면 경고를 띄운다
- 0장 저장은 정상 종료가 아니라 실패로 끝낸다
두 번째 항목이 가설 1의 장점만 가져온 부분입니다. 순서를 뒤집지 않고도, 정적 방식이 썸네일만 건질 상황이면 저장하기 전에 알아채고 브라우저로 넘깁니다. 정적 방식이 원본을 받는 사이트는 예전처럼 빠르게 끝납니다.
주소 규칙은 앞에서 말한 대로 라이브로 확인한 6종만 남겼습니다. 클릭 추적에서 넓은 이미지를 앞에 두는 가중치 `CLICK_AREA_WEIGHT=8`은 처리 순서만 정하는 어림값입니다.
재측정 결과: safebooru 250px에서 2048px로
같은 주소, 같은 기본 옵션(`--limit 12`)으로 다시 쟀습니다. 원본을 못 받던 다섯 곳에 위키백과·Flickr·safebooru 같은 크기 문제 사이트를 더해 비교했습니다.
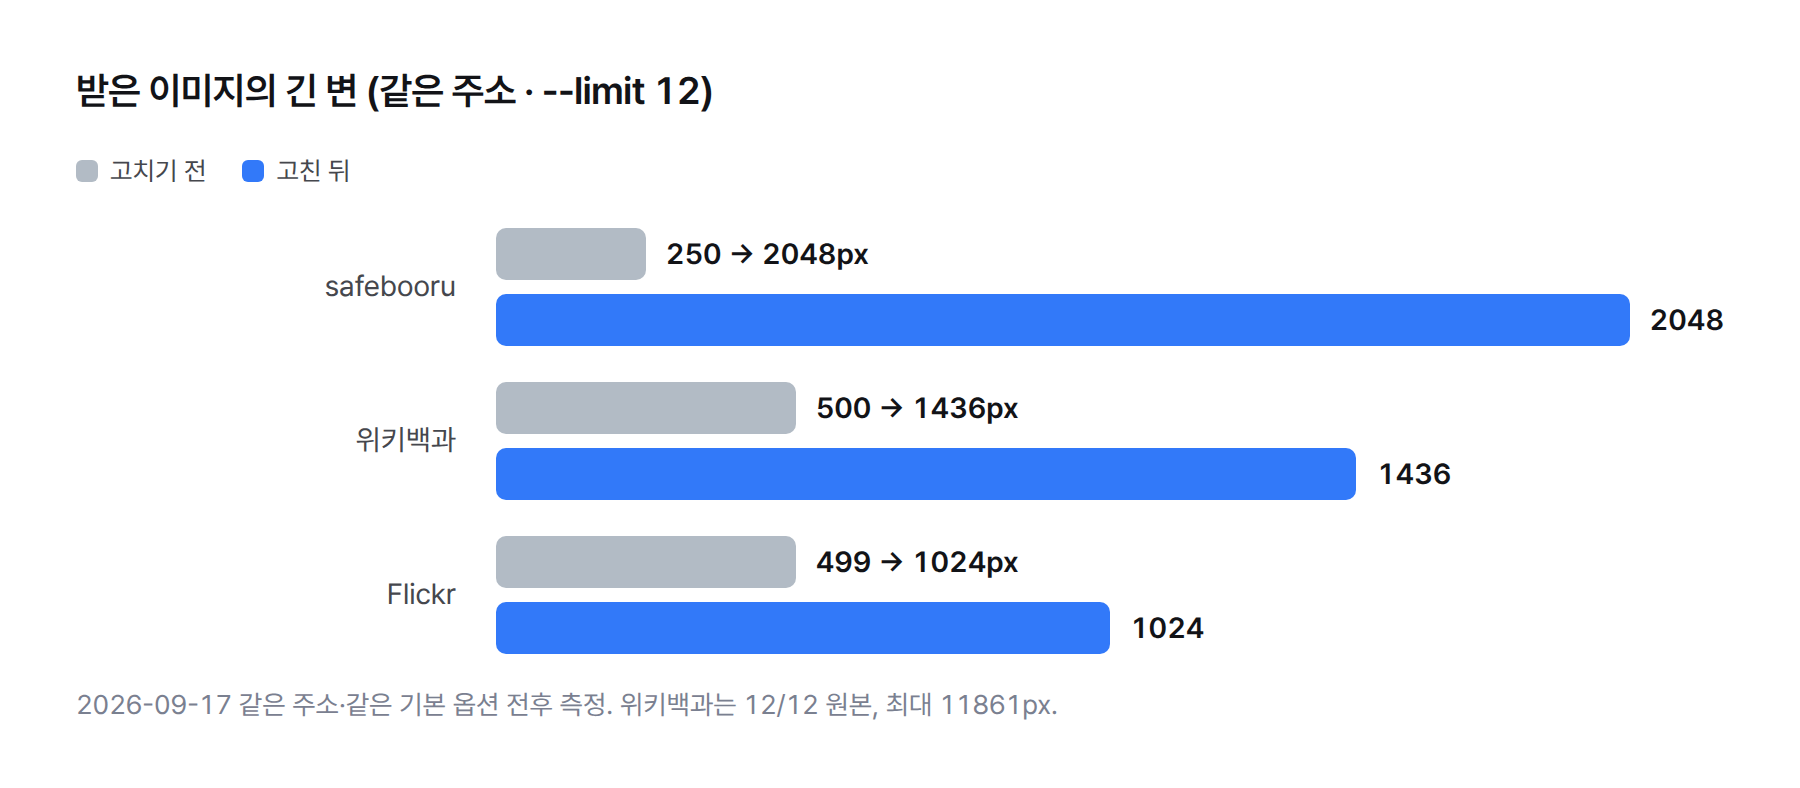
| 사이트 | 고치기 전 | 고친 뒤 |
|---|---|---|
| safebooru | 250px | 2048px |
| 위키백과 | 500px | 1436px (12/12 원본, 최대 11861px) |
| Flickr | 499px | 1024px |
| 무신사 | og 로고 1장 | 상품 원본 12장 (1800px) |
| 네이버 블로그 | 0장 | 12장 (966px, 글 주소 기준) |
| 연합뉴스 | 광고 2장 혼입 | 사진만 12장 |
위키백과는 12장 모두 원본이었고 가장 큰 파일은 긴 변 11861px이었습니다. 무신사는 로고 1장 대신 상품 원본 12장을 1800px로 받았습니다. 네이버 블로그는 0장에서 12장이 됐고 긴 변은 966px입니다. 연합뉴스는 광고가 빠지고 사진만 12장이 남았습니다.
고친 것만큼 중요한 건 망가뜨리지 않았는지입니다. 원래 잘 받던 사이트를 같은 방법으로 다시 돌렸습니다. WordPress 4000px, Shopify 1500px, 티스토리 1200px, 루리웹 900px, 실제 크롬 방식의 Unsplash 5029px로 회귀는 없었습니다.
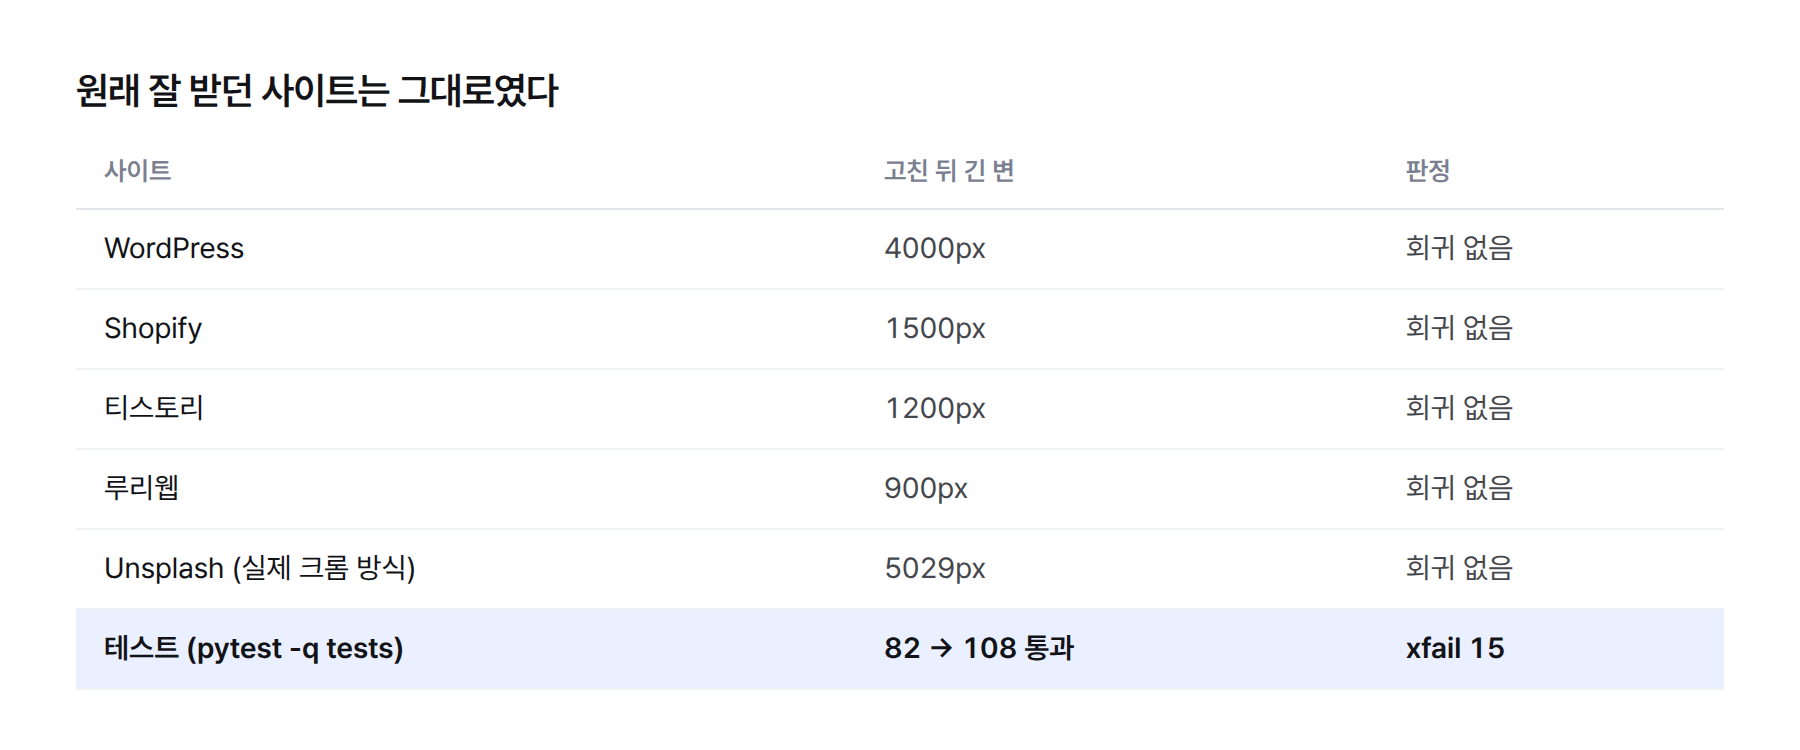
테스트는 82건에서 108건 통과로 늘었고, 확인하지 못한 CDN 규칙 15종은 xfail로 남았습니다(`pytest -q tests`). 늘어난 테스트에는 이번에 찾은 형제 링크 짝짓기 결함처럼, 서로 다른 이미지가 한 장으로 합쳐지지 않는지 보는 경우가 들어갑니다.
한 번 재고 끝내지는 않았습니다. 사흘 뒤인 9월 20일, 실제 배치 수집물에서 받은 주소 124건을 16개 호스트별로 세어 남은 축소본을 다시 봤습니다. 이때도 가설이 절반만 맞았습니다. ‘남은 축소본 3종과 CDN 규칙 15종이 같은 뿌리’라고 봤는데, 세 사이트의 원인이 서로 달랐습니다. 루리웹은 주소 규칙 결함이라 `/img/`를 `/ori/`로 바꾸는 규칙을 라이브 확인(1268px → 2000px) 뒤 넣었고, 838px에서 1920px로 올라갔습니다. 네이버 블로그는 스킨·프로필 같은 장식 이미지가 섞인 문제라 요청 전에 장식을 빼는 함수 `is_site_furniture()`를 두었고, 510px에서 914px로 올라갔습니다. Flickr는 주소로 만들 수 있는 상한이 1024px이라 1024px 그대로 두었습니다. 장식은 크기로 거를 수 없었습니다. 프로필이 600px, 스킨 GIF가 1000px이었기 때문입니다. 테스트는 165건에서 176건 통과로 늘었습니다.
같은 날 구글 블로그(blog.google)에서는 다른 관문이 걸렸습니다. 1장 저장, 못 받은 이미지 49장, 사유는 전부 ‘이미지 아님’이었습니다. Google Cloud Storage가 원본 27장을 전부 `application/octet-stream` 타입으로 내보냈고, 도구는 `image/`로 시작하는 타입만 받고 있었습니다. 25KB~308KB짜리 멀쩡한 WebP가 200 OK로 오는데도 통째로 버린 셈입니다. 같은 판정이 코드 6곳에 흩어져 있어 `may_be_image()` 하나로 모으고, 진짜 판정은 실제로 디코드해 보는 쪽에 맡겼습니다. `--limit 30`으로 두 번 잰 결과 28장 저장, 못 받은 이미지 0장, 긴 변 중앙값 1440px이었습니다. 주소 철자 대신 응답 내용으로 판정한다는 원칙이 응답 헤더까지 넓어진 셈입니다.
남는 한계: 어림값 하나와 다시 못 돌린 사이트
숫자가 좋아졌다고 다 확인한 건 아닙니다. 확인하지 못한 것을 그대로 적어 둡니다.
- 봇 차단 신호가 떴던 Tumblr·Behance와 Unsplash 자동 방식은 다시 돌리지 않았다. 차단 신호가 뜬 사이트는 재시도하지 않는다는 원칙 때문이다
- 클릭 추적 가중치 CLICK_AREA_WEIGHT=8은 어림값이다. 처리 순서만 정하고, 이 값이 최적이라는 근거는 없다
- CDN 규칙 15종은 여전히 xfail이다. 9월 20일 실측에서 Tumblr 2048px·무신사 2000px·Wix 1979px는 규칙 없이 이미 받고 있었지만, 나머지 12종은 샘플이 없어 미확인이다
- Flickr는 주소로 만들 수 있는 상한(1024px)에서 멈춘다. 그 위는 상세페이지의 몫이다
- 지각 해시 검증은 보류 상태다. 지금은 헤더·내비게이션 이미지 제외 규칙으로 로고 부류만 막았다
특히 ‘규칙이 없다’와 ‘못 받는다’는 다른 말이라는 점을 남겨 둡니다. 9월 20일 실측에서 규칙이 없는 세 사이트도 후보 사다리의 다른 단이 원본을 구해 내고 있었습니다. 빈칸을 규칙으로 채우기보다, 빈칸이 실제 실패로 이어지는지 먼저 재는 편이 맞았습니다.
이미지 수집기를 만든다면 무엇부터 확인해야 하나?
이번 일에서 남은 확인 순서를 다섯 줄로 정리합니다. 사이트 종류가 달라도 같은 순서가 통했습니다.
- 받은 장수가 아니라 받은 파일의 긴 변 픽셀을 잰다. 리포트에 중앙값을 남기고 0장은 실패로 끝낸다
- 판정 단위를 이미지 하나로 둔다. 한 이미지의 성공이 다른 이미지의 시도를 막지 않는지 본다
- 이미지인지 페이지인지는 주소 철자도 응답 헤더도 아닌 실제 응답 내용으로 정한다
- 주소 규칙은 라이브로 더 큰 응답을 확인한 것만 넣는다. 틀린 규칙은 결과를 더 나쁘게 만든다
- 고친 뒤 원래 잘 받던 사이트를 같은 옵션으로 다시 돌려 회귀를 잰다
단위테스트가 전부 초록불이어도 결과물을 직접 재지 않으면 절반이 틀린 채로 굴러갈 수 있습니다. 우리 경우 82건이 통과하는 동안 10곳 중 5곳이 축소본을 받고 있었습니다. 사이트 이미지 이전이나 수집 자동화를 검토 중이라면 상담에서 상황을 알려 주세요.