AI 글 판별, 왜 내용이 아니라 조사에서 갈렸나?
AI 글 판별에서 가장 강한 신호는 단어의 뜻이 아니라 '로', '를', '는' 같은 기능어의 빈도였습니다. 저희가 AI로 쓴 짧은 글은 사람 글보다 '로/으로'를 1.77배, '를'을 1.65배, '는'을 1.36배 더 썼습니다. 무엇을 말하느냐보다 어떻게 이어 붙이느냐가 먼저 드러났습니다.
이 측정을 하게 된 계기는 한 편의 논문입니다. arXiv 2608.17399는 기능어 빈도 하나만으로 AI 생성 글을 96% 수준으로 가려냈다고 보고합니다. 영어 연구의 숫자를 한국어 짧은 글에 그대로 옮길 수는 없으니, 우리 데이터로 다시 재 보기로 했습니다. 바로 앞 작업에서 쉼표 쓰는 습관으로 우리 글이 사람 글과 갈린다는 사실을 확인했고, 그 다음 후보로 지목해 둔 축이 기능어였습니다.
코딩 이야기가 아닙니다. AI로 블로그·SNS·고객 안내문을 쓰는 회사라면 누구나 겪는 'AI가 쓴 티가 난다'는 감각을, 숫자로 잡을 수 있는지 확인한 기록입니다. 판별 모델의 성적보다 그 숫자를 보고 무엇을 하지 않기로 했는지가 이 글의 중심입니다.
앞 단계에서 먼저 확인한 것: 쉼표 습관
기능어를 재기 전에 한 단계가 더 있었습니다. 번역체 연구를 찾아보니 원인은 모델 자체보다 학습 데이터에 있다는 결과가 나와 있었습니다. 2025년 논문 “Lost in Literalism”은 지시 학습 데이터의 34% 이상이 이미 번역체라고 보고하고, 프롬프트로 자연스럽게 쓰라고 시키는 방법은 효과가 없었다고 적습니다. 한국어 전용으로는 ACL 2025의 KatFishNet, EACL 2026의 한국어 AI 생성문 비지도 탐지 연구가 있습니다.
그래서 공개된 한국어 문체 계산기(MIT 라이선스)로 우리 발행 글 80건과 같은 플랫폼의 사람 글 400건을 비교했습니다. 가장 크게 갈린 지표는 연결어미 뒤 쉼표율이었습니다. '먹고, 자고'처럼 연결어미 다음에 쉼표를 찍는 비율이 우리 글 중앙 0.222, 사람 글 중앙 0.000이었고 p=1.2e-09였습니다. 한 번이라도 연결어미 뒤에 쉼표를 쓴 글이 우리 쪽 80%, 사람 쪽 26%였습니다.
| 지표 | 우리 글 중앙 | 사람 글 중앙 | p | 처리 |
|---|---|---|---|---|
| 연결어미 뒤 쉼표율 | 0.222 | 0.000 | 1.2e-09 | 차단 검사로 채택 |
| 어휘 다양성 | 0.834 | 0.960 | <1e-15 | 길이 교란, 방향만 참고 |
| 쉼표 든 문장 비율 | 0.363 | 0.250 | 2.9e-04 | 길이 통제 후 p=0.057, 접음 |
모든 차이를 그대로 믿지는 않았습니다. 어휘 다양성은 우리 글 중앙 901자, 사람 글 중앙 177자라는 길이 차이에 크게 끌려갔고, 길이를 맞추면 사람 표본이 20건뿐이라 방향만 보고 차단에는 쓰지 않았습니다. 쉼표 든 문장 비율은 길이를 통제하자 p=0.057로 판정이 불가능해져 접었습니다. 연결어미 쉼표만 길이를 700~1,600자로 맞춰 다시 재도 0.244 대 0.143(p=0.0015)으로 방향이 유지됐습니다. 이번 기능어 측정에서 처음부터 길이를 묶은 이유가 이 경험입니다.
그 결과 넣은 검사는 하나였습니다. 연결어미 뒤 쉼표율 상한 0.40이고, 반려 메시지는 문장을 고치라고 하지 않고 그 쉼표만 지우라고 안내합니다. 지워도 뜻이 바뀌지 않는 자리라서 그렇게 정했습니다. 기능어는 이 검사 다음으로 재 볼 축으로 남겨 둔 후보였습니다.
무엇을 어떻게 쟀나: 조각 433개와 사람 글 10,000개
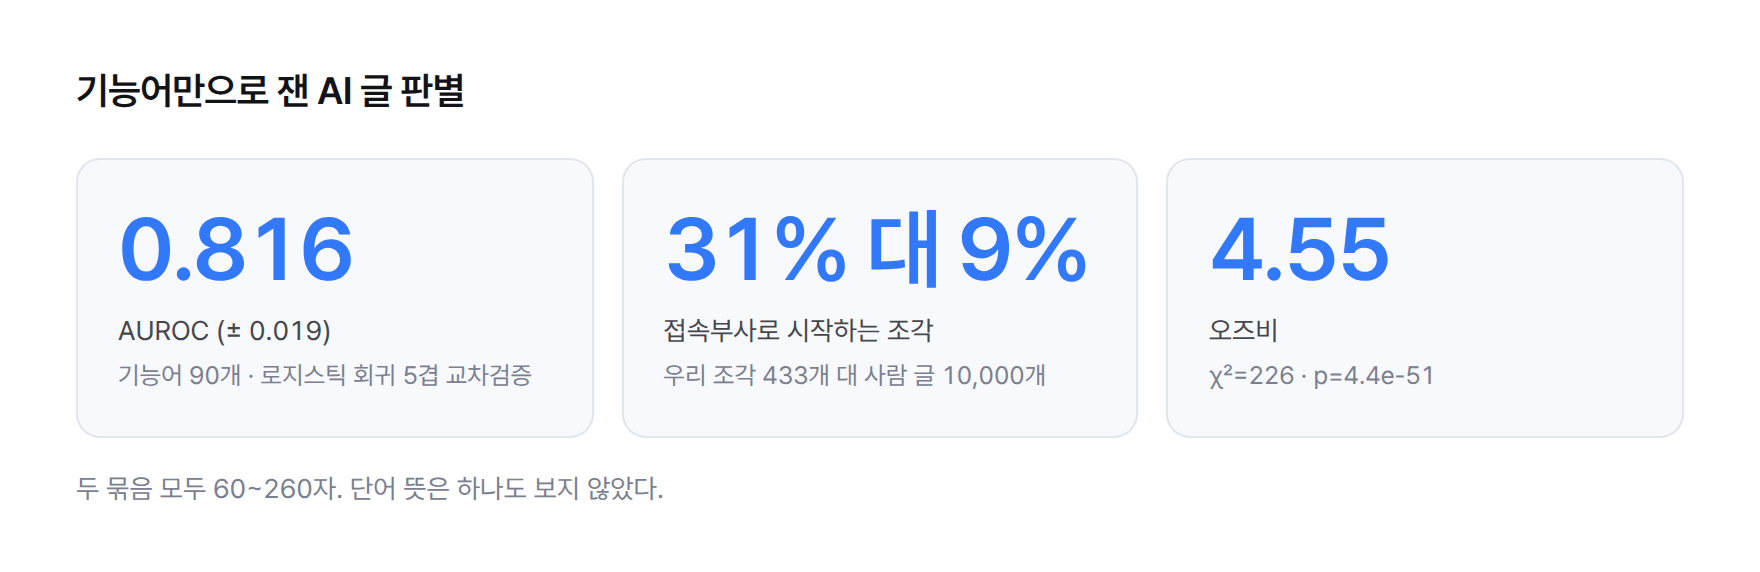
비교 대상은 두 묶음입니다. 한쪽은 우리 시스템이 스레드에 올리려고 AI로 쓴 글 조각 433개, 다른 쪽은 사람이 쓴 글 10,000개입니다. 길이가 다르면 문체 지표가 길이 차이를 따라 움직이기 때문에 두 묶음 모두 60~260자 범위로 맞췄습니다. 앞선 측정에서 어휘 다양성이 우리 글 중앙 901자 대 사람 글 177자라는 길이 차이에 끌려간 일이 있어, 이번에는 처음부터 길이를 묶었습니다.
특징은 기능어 90개입니다. 조사, 어미, 접속부사, 의존명사를 골라 글마다 어절 하나당 몇 번 나오는지 비율로 바꿨습니다. 절대 횟수를 쓰지 않은 이유는 글이 길수록 횟수가 늘어나기 때문입니다. 이렇게 만든 90차원 벡터로 로지스틱 회귀를 학습하고, 데이터를 다섯 묶음으로 나눠 번갈아 검증하는 5겹 교차검증으로 성능을 쟀습니다.
결과는 AUROC 0.816 ± 0.019였습니다. AUROC는 우리 글 하나와 사람 글 하나를 무작위로 뽑았을 때 모델이 우리 글 쪽에 더 높은 점수를 줄 확률입니다. 0.5면 동전 던지기, 1.0이면 완벽한 구분입니다. 단어의 뜻을 하나도 보지 않고 기능어 분포만으로 0.816이 나왔다는 점이 핵심입니다. 다섯 번 검증의 편차가 0.019라 특정 데이터 분할에서만 나온 우연으로 보기도 어렵습니다.
다만 0.816은 글 한 편을 놓고 'AI가 썼다'고 단정할 수 있는 수준은 아닙니다. 두 묶음 전체의 분포가 확실히 다르다는 뜻이지, 개별 글마다 판결을 내려도 좋다는 근거는 아닙니다. 이 차이가 이후 차단 규칙을 넣을지 판단할 때 그대로 걸림돌이 됐습니다. 묶음 단위로는 분명한 신호도 글 한 편 단위의 차단 기준으로 바꾸는 순간 오탐과 놓침이 함께 생기기 때문입니다.
어떤 기능어가 우리 글을 드러냈나?
기능어 90개를 하나씩 따로 검정하면 우연히 차이가 나는 항목이 섞입니다. 그래서 검정 횟수만큼 기준을 엄격하게 낮추는 본페로니 보정을 적용해 유의 수준을 α=5.6e-04로 잡았고, 이 기준을 통과한 기능어가 12개였습니다. 그중 차이가 큰 일곱 개를 아래 표에 옮겼습니다. 숫자는 어절당 평균 출현 비율입니다.
| 기능어 | 우리 글 | 사람 글 | 배율 | z |
|---|---|---|---|---|
| 로/으로 | 0.0516 | 0.0291 | 1.77배 | +12.8 |
| 를 | 0.0324 | 0.0196 | 1.65배 | +9.6 |
| 는 | 0.0699 | 0.0512 | 1.36배 | +9.3 |
| 실제로(문장 첫머리) | 0.0040 | 0.0004 | 11배 | +4.6 |
| 그런데(문장 첫머리) | 0.0033 | 0.0006 | 5.9배 | +4.0 |
| 그래서(문장 첫머리) | 0.0037 | 0.0010 | 3.8배 | +4.2 |
| 의 | 0.0063 | 0.0144 | 0.44배 | −4.8 |
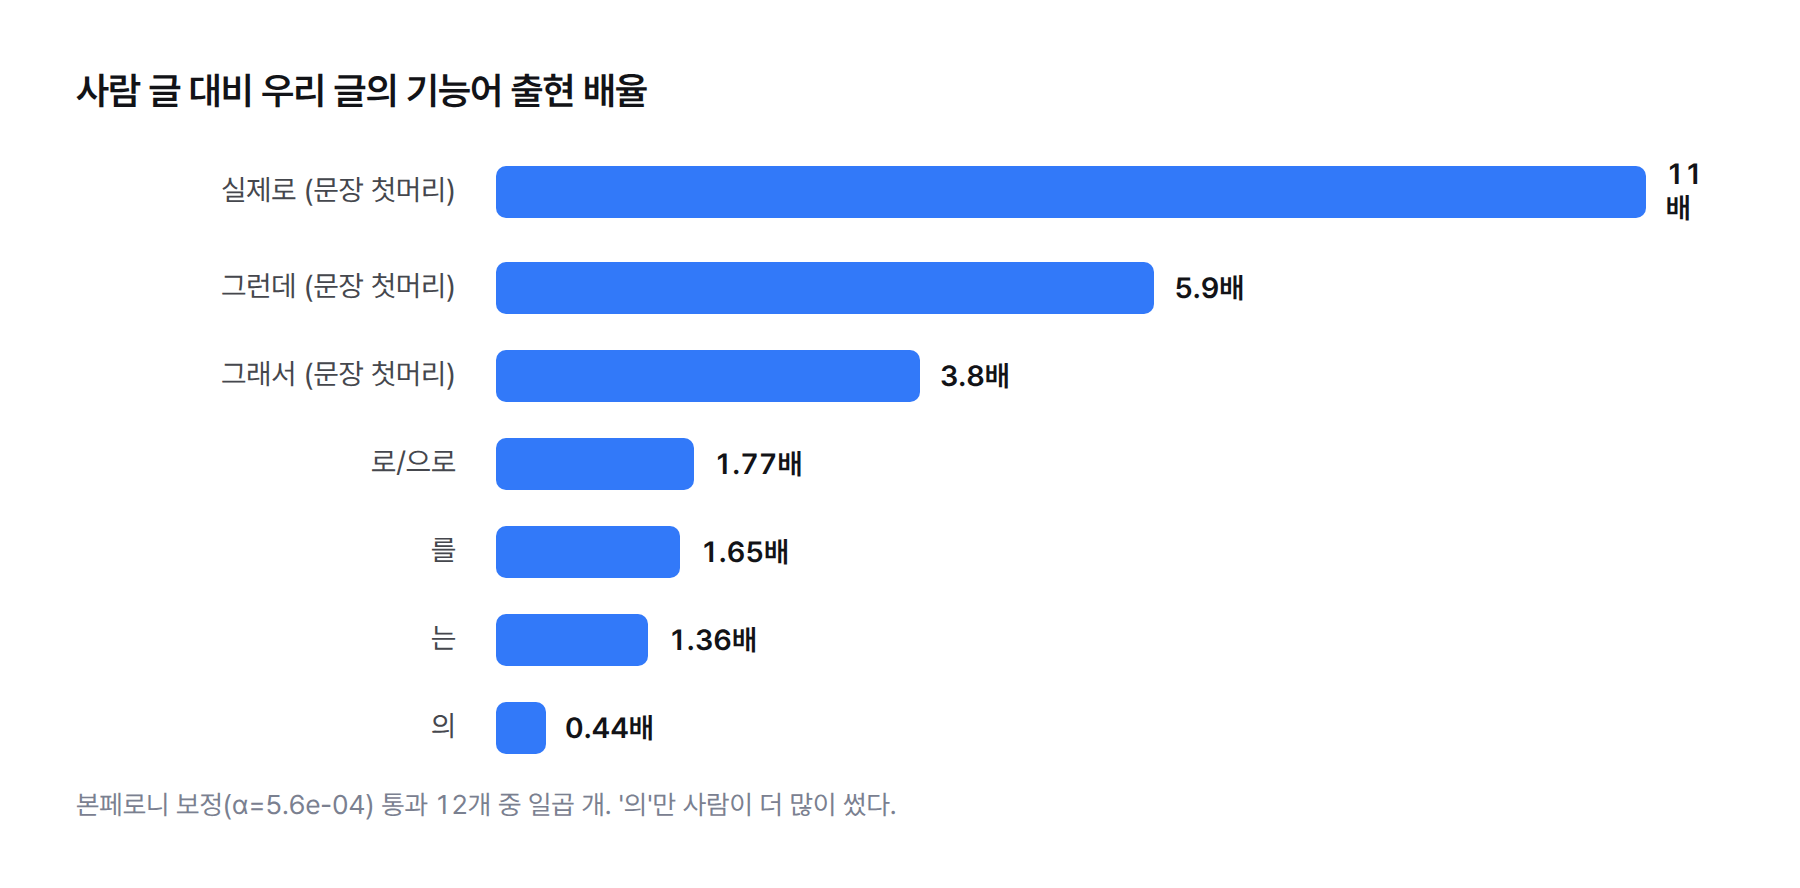
통계적으로 가장 강한 신호는 '로/으로'입니다. z값이 +12.8로 다른 항목보다 확연히 큽니다. 배율만 보면 문장 첫머리의 '실제로'가 11배로 가장 크지만, 사람 글에서 원래 드물게 나오는 말이라 z값은 +4.6에 머뭅니다. 배율과 z값을 같이 봐야 하는 이유가 여기 있습니다. 배율이 크다고 판별에 많이 기여하지는 않고, 흔한 말에서 생긴 작은 차이가 더 단단한 신호일 때가 많습니다.
이 그림은 해석이 어렵지 않습니다. 영어는 주어와 목적어를 반드시 쓰는데 한국어 구어는 조사를 자주 생략합니다. AI가 영어식 골격으로 문장을 짜면 '을/를'과 '은/는'이 생략되지 않고 그대로 남습니다. '로/으로'는 영어의 with, by, as가 들어갈 자리에 붙고, 문장 첫머리의 '실제로', '그런데', '그래서'는 In fact, However, So를 옮긴 모양입니다.
번역체 신호라던 '의'는 왜 거꾸로 나왔나?
표의 마지막 줄은 예상과 반대였습니다. '의'는 우리 글이 사람 글의 0.44배밖에 쓰지 않았습니다. 'A의 B의 C' 같은 겹친 '의'는 번역체의 대표 증상으로 자주 꼽히는데, 적어도 우리 짧은 글에서는 사람 쪽이 '의'를 더 많이 썼습니다.
이 결과가 중요한 이유는 규칙을 만드는 방식에 있습니다. 번역체 통념을 그대로 검사 규칙으로 옮겼다면 '의'를 많이 쓴 글을 걸러 냈을 테고, 그 규칙은 사람 글을 더 많이 걸렀을 겁니다. 널리 알려진 증상 목록이 우리 데이터에서도 같은 방향인지는 재 보기 전까지 모릅니다. 처음에는 '의'도 당연히 우리 글에서 많이 나올 거라 예상했고, 그 가설은 이 측정에서 틀렸습니다.
한 가지 덧붙이면, '의'가 적게 나온 원인은 이번 측정만으로 가리지 못했습니다. 짧은 SNS 글이라 명사를 겹쳐 쓸 자리가 원래 적을 수도 있고, 앞서 붙여 둔 문체 지시가 영향을 줬을 수도 있습니다. 원인을 모르는 채로 규칙을 만들지 않고, 결과만 기록해 뒀습니다.
문장 첫머리 접속부사: 31% 대 9%
세 접속부사가 모두 문장 첫머리에서 크게 나와, 이 축만 따로 떼어 쟀습니다. 글 조각 가운데 접속부사로 시작하는 문장이 하나라도 있는 비율을 세면 우리 조각은 31%, 사람 글은 9%였습니다. 오즈비는 4.55, 카이제곱 검정 χ²=226, p=4.4e-51로 우연이라 보기 어려운 차이입니다.
문장 첫머리만 센 데에는 이유가 있습니다. 문장 가운데 들어간 '특히'나 '결국'은 한국어에서 아주 정상적인 부사입니다. 위치를 가리지 않고 세면 이런 정상 용법까지 잡혀 오탐이 늘고, 차단 검사에서는 오탐 한 번이 그 검사 전체의 신뢰를 무너뜨립니다. 사람이 '이 검사는 엉뚱한 걸 막는다'고 한 번 느끼면 그 뒤로는 경고를 읽지 않습니다.
사람이 접속부사로 문장을 열지 않는다는 말은 아닙니다. 사람 글에도 9%는 있습니다. 문제는 빈도이고, AI 글은 문장과 문장 사이의 논리 연결을 말로 드러내는 습관이 사람보다 훨씬 강했습니다.
판별은 되는데 왜 차단 규칙은 넣지 않았나?
판별력이 확인되면 다음 순서는 보통 차단입니다. 접속부사 비율이 기준을 넘으면 발행 전에 돌려보내는 검사를 붙이는 식입니다. 임계 후보를 모두 재 봤고, 판단 기준은 미리 정해 둔 상한이었습니다. 과거 발행 글을 30% 넘게 돌려보내는 임계는 쓰지 않는다는 선입니다. 너무 많이 막으면 쓸 글이 남지 않기 때문입니다.
| 임계 후보 | 접속부사 검사 단독 반려율 | 쉼표 검사와 합친 반려율 |
|---|---|---|
| 조각 중 비율 0.20 초과 | 60% | 해당 없음 |
| 조각 3개 초과 | 9% | 32% |
| 조각 4개 초과 | 2% | 29% |
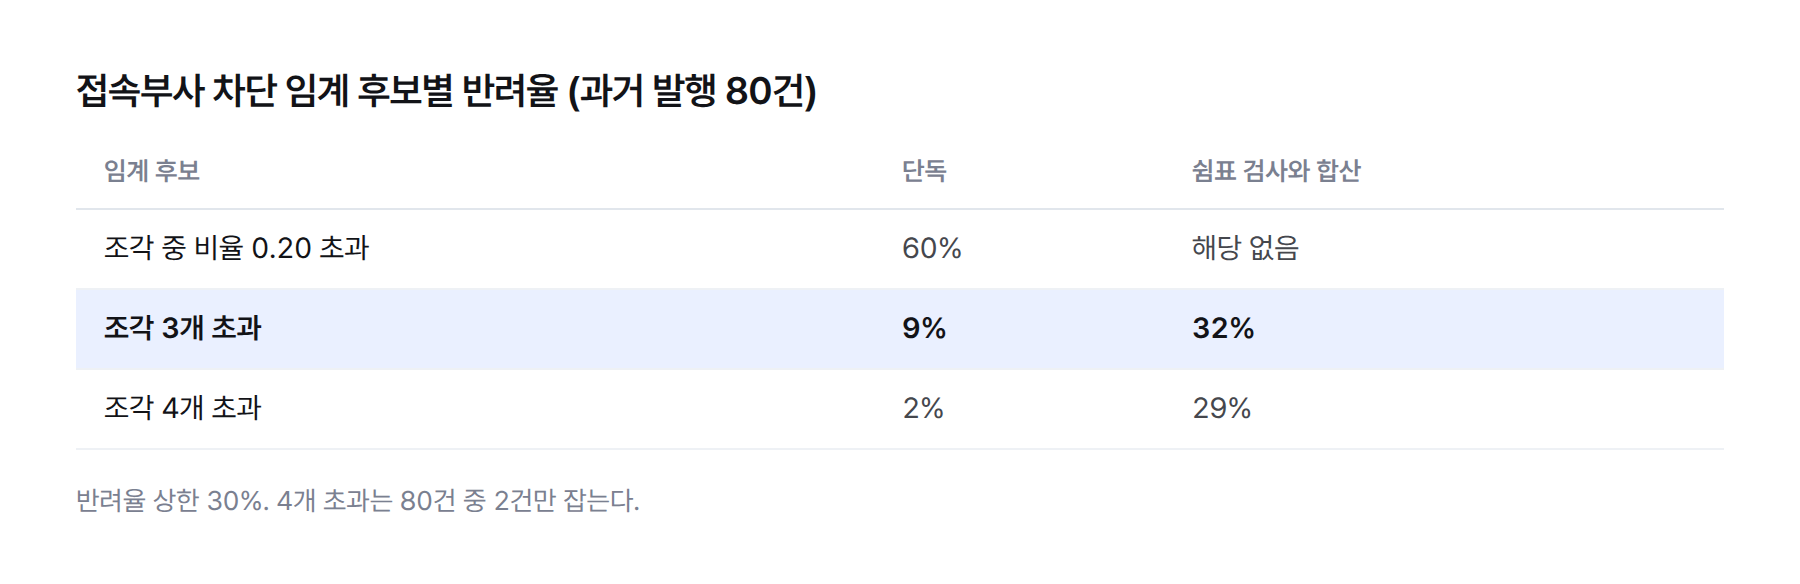
비율 기준은 60%를 반려해 처음부터 탈락입니다. 조각 4개 초과는 합산해도 29%라 선은 지키지만, 과거 발행 80건 가운데 2건만 잡아 사실상 아무것도 막지 않습니다. 조각 3개 초과는 단독으로 9%라 적당해 보이는데, 이미 걸려 있는 쉼표 검사와 합치면 32%로 선을 넘습니다. 30% 선과 실효성을 함께 지키는 임계가 하나도 없었습니다.
더 큰 이유는 따로 있었습니다. 직전에 넣은 쉼표 검사 두 개의 실제 통과율이 아직 나오지 않았습니다. 그 판정 날짜는 2026년 9월 21일입니다. 그 전에 검사를 하나 더 얹으면 글이 덜 걸리거나 더 걸렸을 때 어느 검사가 무엇을 했는지 가를 수 없습니다. 예전에 차단 검사를 3층으로 쌓아 놓고 정작 어느 층이 몇 건을 반려했는지 세지 못한 적이 있어, 같은 실수를 반복하지 않기로 했습니다.
차단 대신 무엇을 남겼나: 발행 기록의 문체 숫자 5개
차단은 미뤘지만 측정은 멈추지 않았습니다. 글을 발행할 때마다 발행 기록에 문체 숫자 다섯 개를 함께 남기도록 했습니다. 쉼표 밀도(comma_density), 연결어미 뒤 쉼표 비율(ending_comma_rate), 접속부사로 시작하는 조각 수(conn_head_parts), 그 비율(conn_head_share), 과다 조사 비율(josa_overused_rate)입니다. 2026년 9월 21일에 쉼표 검사를 판정할 때 이 숫자들을 함께 놓고 봅니다.
과거 발행 80건에도 같은 계산을 소급해 기준점을 만들었습니다. 중앙값은 쉼표 밀도 0.043, 연결어미 쉼표 0.222, 접속부사 조각 0.286, 과다 조사 0.220입니다. 앞으로 쌓일 숫자를 이 기준점과 비교하면, 쉼표 검사가 들어간 뒤 다른 문체 지표가 같이 움직였는지도 볼 수 있습니다.
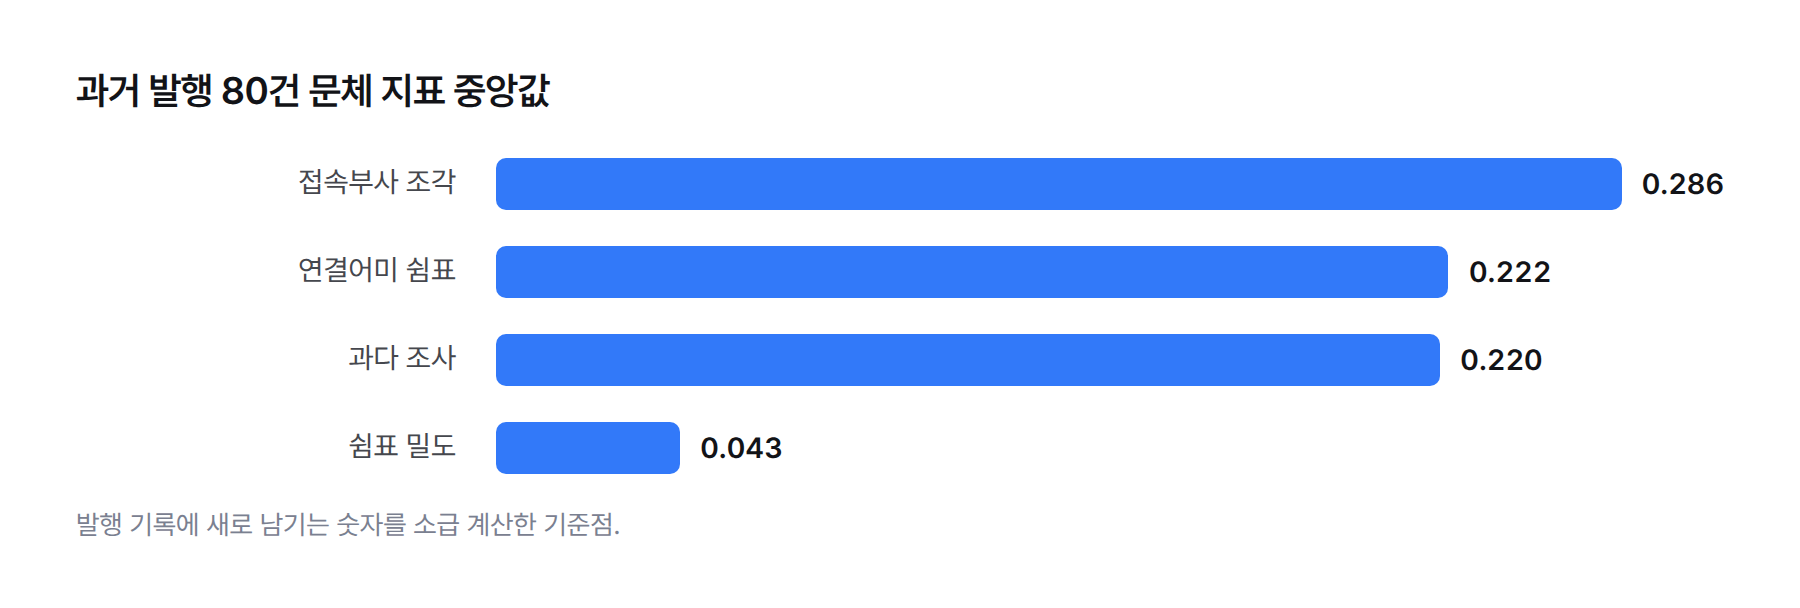
연결어미 쉼표 0.222는 앞선 측정과도 이어집니다. 같은 지표를 사람 글 400건과 비교했을 때 사람 쪽 중앙값은 0.000이었고, 그 차이로 연결어미 뒤 쉼표율 상한 0.40을 첫 차단 검사로 넣었습니다. 그 상한은 사람 글 1,200건의 상위 10% 경계에서 잡았고 과거 발행 80건 기준 반려율은 19%였습니다. 이 검사가 실제로 무엇을 바꿨는지 확인하기 전까지 새 검사는 숫자만 쌓습니다.
같은 지표가 다른 종류의 글에서는 반대로 나온다
이 측정은 회사 안의 다른 규칙과 정면으로 부딪혔습니다. AI가 쓰는 모든 한국어 글에 적용하는 전역 글쓰기 규칙에는 문장 첫머리 접속부사를 '버린 지표, 사람 원고가 AI보다 더 많이 썼다'고 적어 둔 항목이 있었습니다. 같은 지표를 두고 한쪽은 사람이 더 많이 쓴다고, 다른 쪽은 AI가 3배 이상 많이 쓴다고 말하는 상황이었습니다.
둘 다 맞았습니다. 앞의 판정은 업무 문서와 고객에게 보내는 글을 놓고 낸 결과였고, 이번 측정은 60~260자 짧은 SNS 글을 놓고 낸 결과입니다. 긴 문서에서는 사람이 문단을 잇느라 접속부사를 많이 쓰고, 짧은 글에서는 AI만 습관처럼 접속부사로 문장을 엽니다. 지표 자체가 틀린 게 아니라, 판정마다 적용 범위가 있었습니다.
그래서 전역 규칙 쪽에 적용 범위 주석을 달았습니다. '이 판정은 문서와 발송물 기준이고, 짧은 SNS 글에서는 방향이 반대'라는 한 줄입니다. 이 주석이 없으면 나중에 이 시스템을 고치는 AI나 사람이 '이미 버린 지표'라는 문장을 근거로 이번 계측을 지울 수 있습니다. 어떤 지표를 버린 이유를 기록할 때는 그 이유가 어느 범위에서 성립했는지도 함께 적어야 합니다.
직접 재 보려면 무엇을 조심해야 하나?
이 측정을 다른 회사의 AI 글에 그대로 옮겨 쓰려는 분께 저희가 실제로 부딪힌 함정 네 가지를 정리합니다. 숫자는 우리 데이터의 것이니 그대로 가져가지 말고, 방법만 가져가시길 권합니다.
- 길이를 먼저 묶는다. 어휘 다양성은 우리 글 중앙 901자 대 사람 글 177자라는 길이 차이만으로 크게 벌어졌다. 이번 측정은 두 묶음을 60~260자로 맞춘 뒤에 쟀다.
- 여러 지표를 한꺼번에 검정하면 보정한다. 기능어 90개를 각각 검정하면서 본페로니 보정으로 유의 수준을 5.6e-04까지 낮췄고, 남은 항목은 12개였다.
- 위치를 좁혀 센다. 접속부사는 문장 첫머리만 셌다. 문장 가운데의 '특히'와 '결국'까지 세면 정상 용법이 오탐으로 잡힌다.
- 임계는 사람 분포의 꼬리에서 잡는다. 연결어미 쉼표는 사람 글의 75% 지점이 0.000이라 그 값을 쓰면 초안 80%가 걸린다. 그래서 사람 글 1,200건의 90% 지점인 0.40을 상한으로 썼다.
마지막 항목은 차단 검사를 설계할 때 반복해서 만난 문제입니다. 검사를 엄격하게 할수록 통과하는 글이 줄고, 끝내 발행할 글이 남지 않습니다. 다른 검사에서는 차단율이 96%까지 올라가 보류한 적도 있습니다. 판별력이 높은 지표를 찾는 일과 그 지표로 무엇을 몇 건 막을지 정하는 일은 별개의 작업이라는 점이 이번 측정의 가장 쓸모 있는 교훈이었습니다.
남은 일: 판별기를 갖게 된 뒤에 할 것
'의'가 거꾸로 나온 현상과 조사 과다는 차단 검사로 다룰 축이 아니라고 판단했습니다. 쉼표는 지워도 뜻이 바뀌지 않지만, 조사가 많은 문장은 문장 자체를 다시 써야 고쳐집니다. 이건 글을 막는 검사가 아니라 다 쓴 글을 한 번 더 다듬는 단계의 일입니다. 번역체 연구에서도 생성 뒤 별도로 다듬는 단계를 넣었을 때 번역체 비율이 43%에서 25%로 줄었습니다. 그 다듬기 단계를 앞서 어떻게 들였는지는 AI 번역체 자동 검사, 고치라고 시켰더니 더 심해졌다에 적었습니다.
다듬기 단계는 새로 만들지 않고 이미 공개된 도구를 들였습니다. MIT 라이선스의 한국어 윤문 도구로, 10개 범주 70개 하위 패턴을 S1~S3 심각도로 나눠 결정론으로 찾고, LLM이 문장을 다듬은 뒤, 다시 결정론으로 검증하는 3단 구조입니다. 원문 대비 변경률이 30%를 넘으면 경고하고 50%를 넘으면 멈춥니다. 설치 전에 네트워크 호출과 비밀 키 접근이 없는지 먼저 확인했습니다. 조사 과다처럼 문장을 다시 써야 하는 문제는 이 단계가 맡습니다.
한국어 AI 글 탐지 논문들은 공통으로 한국어 코퍼스가 부족하다는 한계를 적습니다. 저희는 비교용 사람 글 223,533건을 모아 두었고, 이번에 AUROC 0.816짜리 판별기까지 갖게 됐습니다. 다음 판단은 2026년 9월 21일 쉼표 검사 판정과 함께 내립니다. 그때 접속부사 검사를 얹을지, 다듬기 단계로 넘길지를 이번에 남긴 다섯 숫자로 정합니다.
정리하면 이렇습니다. 기능어만으로 AI 글은 상당히 갈립니다. 하지만 갈린다는 사실이 곧 막아야 한다는 뜻은 아니고, 이미 넣은 검사의 효과를 세기 전에는 새 검사를 얹지 않았습니다. 자동으로 쓰는 글이 사람 손을 탄 것처럼 읽히게 만드는 작업이 필요하다면 상담으로 연락 주세요.