증상 — 재개발 글에 광고 계측 경험이 달렸다
LLM 자동 답글 봇이 상대 글과 아무 관계 없는 우리 경험을 끌어다 붙인 사고는, 모델이 엉뚱해서가 아니라 프롬프트에 경험 목록을 통째로 싣던 설계 때문이었습니다. 이 글은 그 원인에 닿기까지 틀린 곳을 먼저 짚었다가 되돌아온 과정을 순서대로 적은 기록입니다. 자동 답글이나 자동 댓글, 고객 응대 챗봇처럼 'LLM에게 참고 자료를 쥐여 주고 글을 쓰게 하는' 시스템을 만드는 분이라면 같은 자리에서 걸릴 가능성이 높습니다.
시작은 운영자의 눈이었습니다. 방금 나간 답글을 피드에서 직접 보다가 이상한 조합을 발견했습니다. 한 사용자가 재개발과 집값 이야기를 쓴 글에, 우리 봇이 "광고 전환 이벤트가 코드에 빠져 있어 '0'이 아니라 '못 세는 상태'였다"는 답글을 달아 놓았습니다. 원글에는 광고도, 계측도, 코드도 없었습니다. 운영자의 첫마디는 이랬습니다.
피드 내용이랑 답글이랑 전혀 상관 없는 내용을 억지로 연관 시켜서 이상한 글을 달아버리면 어쩌자는거지.
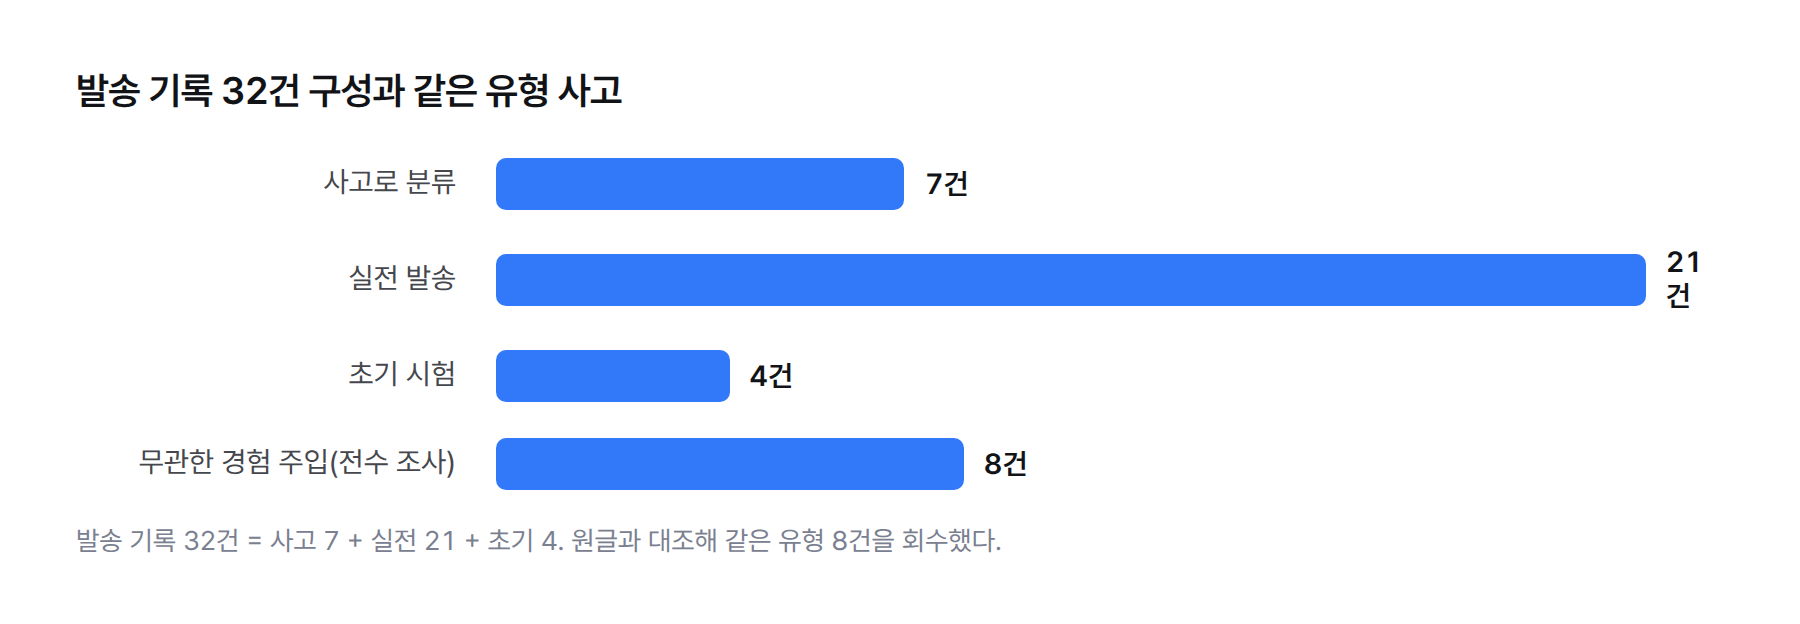
한 건이면 우연일 수 있습니다. 그래서 발송 기록 전체를 다시 열었습니다. 기록은 32건이었고, 사고로 분류해 둔 7건, 실제 운영 중 나간 21건, 초기 시험 4건으로 나뉘었습니다. 32건을 원글과 하나씩 대조하니 같은 유형, 곧 원글과 무관한 경험을 이어 붙인 답글이 8건 나왔습니다. 공개 답글은 상대 피드에 남습니다. 먼저 발송을 멈추는 플래그 파일을 만들어 추가 발송을 막고, 원인을 찾기 시작했습니다.
처음 의심한 것 — 선별 함수에 관련성 하한이 없다
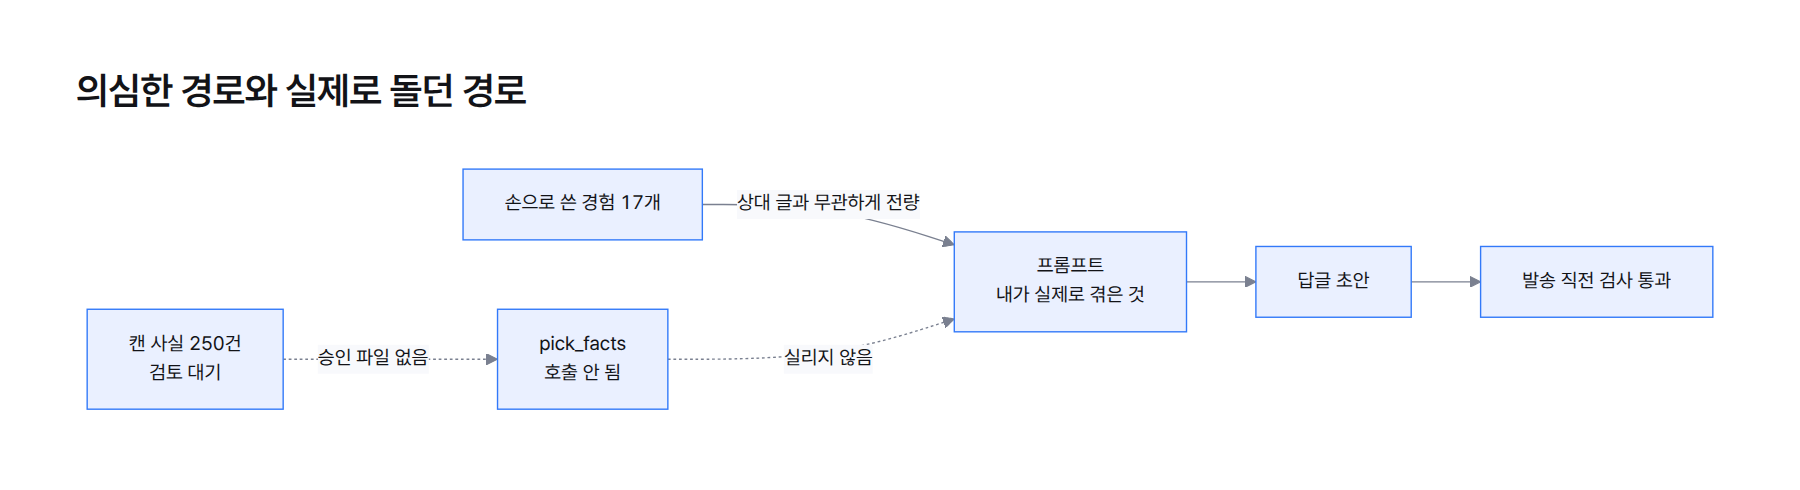
답글 봇이 쓰는 경험에는 두 갈래가 있었습니다. 하나는 사람이 손으로 쓴 경험 목록 17개입니다. 다른 하나는 그보다 앞서 만든 확장 경로로, 과거 작업 기록에서 1인칭 경험을 자동으로 캐낸 '캔 사실'입니다. 캔 사실은 250건까지 쌓였고, 이걸 전부 넣으면 너무 길어서 `pick_facts`라는 함수가 상대 글과 낱말이 겹치는 항목 상위 25건만 골라 싣도록 만들어 두었습니다.
사고 답글을 보자마자 이 함수를 의심했습니다. 낱말이 한 개만 겹쳐도 후보에 오를 수 있고, 겹침이 적어도 '상위 25건' 안에만 들면 실립니다. 관련성의 바닥, 곧 하한이 없는 셈입니다. 재개발 글과 광고 경험 사이에 우연히 낱말 하나가 겹쳤고, 그 하나로 광고 경험이 끌려왔다는 그림이 그럴듯해 보였습니다.
이 가설이 맞다면 고치는 법도 간단합니다. 겹침 개수에 하한을 걸면 끝입니다. 여기서 바로 코드를 고쳤다면 이 글은 한 문단으로 끝났을 테고, 사고는 그대로 남았을 겁니다.
무엇으로 확인했나 — 실제 호출 경로와 프롬프트 원문
가설을 확인하는 수단은 세 가지였습니다. 첫째, 답글을 만드는 코드가 실제로 어떤 순서로 경험을 읽어 들이는지 호출 경로를 따라갔습니다. 둘째, `pick_facts`가 읽는 입력 파일이 지금 디스크에 있는지 확인했습니다. 셋째, 모델에게 실제로 넘어간 프롬프트에 어떤 경험이 몇 개 실렸는지 원문으로 봤습니다.
- 호출 경로 추적 — 경험 목록을 이어 붙여 프롬프트에 넣는 자리부터 거꾸로 따라가기
- 입력 파일 존재 확인 — 캔 사실을 승인한 결과물인 peer-facts-harvested.md가 있는가
- 프롬프트 원문 확인 — '내가 실제로 겪은 것' 헤더 아래 몇 개 항목이 실렸는가
- 발송 기록 대조 — 사고 8건의 원글과 답글을 나란히 놓고 어떤 경험이 쓰였는가
이 중 두 번째가 결정적이었습니다. 가설이 가리키는 함수가 정말 돌고 있는지부터 봐야, 그 함수의 결함을 논할 수 있기 때문입니다.
왜 선별 함수는 범인이 아니었나?
`pick_facts`의 입력 파일인 `peer-facts-harvested.md`가 존재하지 않았습니다. 파일이 없으니 함수는 호출조차 되지 않고 있었습니다. 관련성 하한이 없다는 결함은 코드에 분명히 있었지만, 이번 사고가 난 시점에는 그 코드가 한 번도 실행되지 않았습니다. 완벽한 알리바이였습니다.
파일이 없던 사정은 이렇습니다. 사고 직전, 캔 사실 250건을 사람이 검토하기 전에 발송 경로에 올려 버린 절차 실수를 발견해, 승인 결과물을 지우고 250건 전부를 검토 대기 상태로 되돌려 둔 참이었습니다. 캔 사실은 사람이 표본을 보고 배치 단위로 승인해야 발송 경로에 실리게 만든 구조였고, 그 승인이 아직 나지 않은 상태였습니다.
그러니 사고 답글에 쓰인 광고 경험은 캔 사실 쪽에서 온 것일 수 없었습니다. 남은 출처는 하나, 손으로 쓴 경험 목록 17개였습니다. 첫 가설은 반증됐지만, 결함 자체는 진짜였기 때문에 버리지 않고 수리 목록에 남겼습니다. 나중에 캔 사실이 승인되는 날 같은 사고가 그쪽에서 다시 날 수 있어서입니다.
진짜 원인 — 손으로 쓴 경험 17개가 매번 전량 실렸다
진짜 경로는 의심한 함수 바로 옆에 있었습니다. 손으로 쓴 경험 목록 17개는 상대 글이 무엇이든 매번 전량 프롬프트에 들어갔습니다. 코드에는 "정본이라 자르지 않는다"는 주석까지 달려 있었습니다. 사람이 직접 고르고 다듬은 목록이니 기계가 잘라 내면 안 된다는 판단이었고, 캔 사실에 선별 함수를 붙일 때도 이 17개는 일부러 선별 밖에 두었습니다. 그 판단이 원인이었습니다.
왜 그게 문제인지는 모델 입장에서 보면 분명합니다. 프롬프트에 '내가 실제로 겪은 것'이라는 헤더가 있고 그 아래 목록이 있으면, 모델은 그 목록이 지금 이 글과 관련 있다고 읽습니다. 목록이 거기 있다는 사실 자체가 '이걸 써라'는 신호로 작동합니다. 재개발 글이든 육아 글이든, 모델은 17개 중 하나를 골라 어떻게든 이어 붙이려 합니다.
정본이라는 지위는 사실이 참이라는 뜻이지, 아무 글에나 붙여도 된다는 뜻이 아니다.
사람이 쓴 사실이라 참인가, 그 사실이 이 글에 맞는가는 서로 다른 질문입니다. 우리는 첫 번째 질문에만 답해 두고 두 번째 질문은 모델에게 떠넘겼습니다. 모델은 두 번째 질문에 '관련 있다'로 답하도록 입력이 짜여 있었습니다.
같이 드러난 부수 결함 세 가지는 무엇이었나?
사고 8건을 원글과 나란히 놓고 보니, 무관한 경험 주입 외에도 결함이 세 가지 더 보였습니다. 셋 다 한 건만 봐서는 안 보이고, 여러 건을 겹쳐 봐야 드러나는 종류였습니다.
| 결함 | 실제 사례 | 왜 문제인가 |
|---|---|---|
| 상대 사정 날조 | 원글은 'Aside 유즈케이스 5편'인데 답글이 '네이버 검색광고에 계측 관련 이슈가 있으신 것 같아요'로 시작 | 원글에 검색광고는 한 글자도 없다. 없는 고민을 상대에게 씌웠다 |
| 같은 경험 재사용 | '전환 이벤트 누락' 3회, '내가 본 화면이 실제 작업 화면이 아니었다' 3회 | 한 사람에게 두 번이 아니라 같은 판의 여러 사람에게 돌려 봇으로 읽힌다 |
| 조사에 무너지는 겹침 점수 | '이벤트가'와 '이벤트에'가 다른 토큰 | 같은 일화 두 문장의 낱말 겹침이 1개로 나와 재사용을 못 잡는다 |
세 결함 모두 발송 직전 검사를 통과했다. 검사는 한 번에 한 건만 봤기 때문이다.
특히 두 번째가 무섭습니다. 같은 이야기를 한 사람에게 두 번 하면 실수로 읽히지만, 같은 주제 판에서 서로 다른 사람 셋에게 같은 이야기를 하면 그 판을 보는 모두가 '이거 봇이구나' 하고 읽습니다. 앞서 손으로 쓴 목록만 쓰던 시절에도 정상 답글 22건이 17개 중 8종만 인용했고, 2종은 각각 3회씩 반복된 적이 있었습니다. 목록 전량 주입이 이 쏠림을 부추긴 셈입니다.
세 번째는 한국어 특유의 함정입니다. 띄어쓰기로 낱말을 자르면 조사가 붙은 채로 토큰이 됩니다. '이벤트가'와 '이벤트에'는 같은 낱말인데 기계는 다른 낱말로 셉니다. 그래서 누가 봐도 같은 일화인 두 문장이 낱말 겹침 1개, 곧 '거의 다른 문장'으로 판정됐습니다.
고친 방법 — 네 겹으로 막았다
수리는 네 겹으로 나눴습니다. 원인 경로를 막고, 반증됐지만 진짜였던 결함도 막고, 발송 직전에 한 번 더 거르고, 이미 나간 답글을 거둡니다.
- 1층, 태그가 걸린 경험만 싣기 — `select_core_facts`를 새로 만들어 손으로 쓴 경험도 상대 글과 맞닿는 항목만 싣는다. 항목마다 사람이 '통하는자리' 태그를 달았고(14개), 원글에 태그가 걸릴 때만 채택한다. 태그 주석은 모델에게 넘기기 전에 지워 내부 표기가 답글로 새지 않게 했다
- 2층, 겹침 하한 — `pick_facts`에 `FACT_MIN_OVERLAP=2`와 불용어 33개를 걸었다. 지금은 호출되지 않지만, 캔 사실이 승인되는 날 같은 규율을 받게 해 두었다
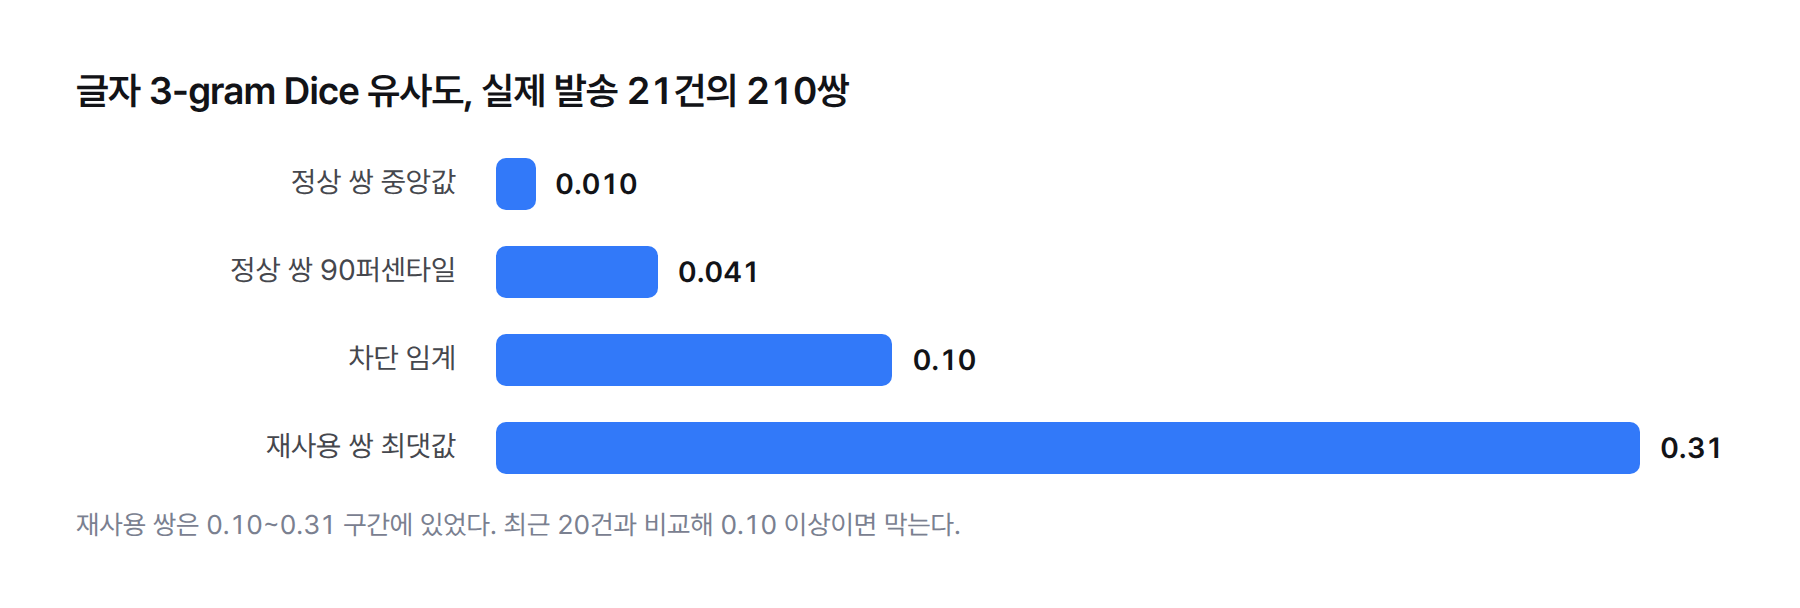
- 3층, 발송 직전 검사 확장 — '~이슈가 있으신' 류로 남의 사정을 단정하는 문장을 막고, 최근 20건과 글자 3-gram Dice 유사도가 0.10 이상이면 같은 경험 재사용으로 막는다
- 4층, 회수 — 회수 스크립트를 새로 만들어 URL이 아니라 본문 앞 24자로 답글 카드를 찾아 지우고, 새로고침해 사라진 것을 확인한 건만 발송 기록에 '회수됨'으로 적는다
3층의 재사용 검사는 낱말이 아니라 글자 단위로 쟀습니다. 글자 세 개씩 묶어(3-gram) 두 문장이 얼마나 겹치는지 보면 조사가 달라도 '이벤트' 같은 몸통이 그대로 겹칩니다. 앞서 말한 조사 함정을 피하는 방법입니다. 임계값 0.10은 감으로 정하지 않았습니다. 실제로 나간 답글 21건에서 나올 수 있는 모든 쌍, 210쌍의 유사도를 쟀습니다. 중앙값은 0.010, 90퍼센타일은 0.041이었고, 사람이 보기에 같은 경험을 돌려 쓴 쌍은 0.10에서 0.31 사이에 있었습니다. 정상 쌍의 90%가 0.041 아래에 있으니 0.10에 선을 그으면 정상 답글은 거의 건드리지 않고 재사용 쌍은 잡습니다.
4층에서 URL 대신 본문 앞 24자를 쓴 이유는 답글 카드에 고유 주소가 안정적으로 잡히지 않아서였습니다. 대신 '지웠다'가 아니라 '지운 뒤 새로고침해 사라진 것을 봤다'만 기록합니다. 지우기 버튼을 누른 일과 실제로 사라진 일은 다른 사실이기 때문입니다. 재개발 글에 달린 첫 사고 답글에는 이미 상대의 대댓글이 달려 있었습니다. "굳이 계측을 하자면 시장에서 기꺼이 내는 가격이 삶의 질의 상승분"이라는, 우리 답글을 받아 준 문장이었습니다.
하한만 걸면 어떻게 되나 — 사고는 막았지만 벽이었다
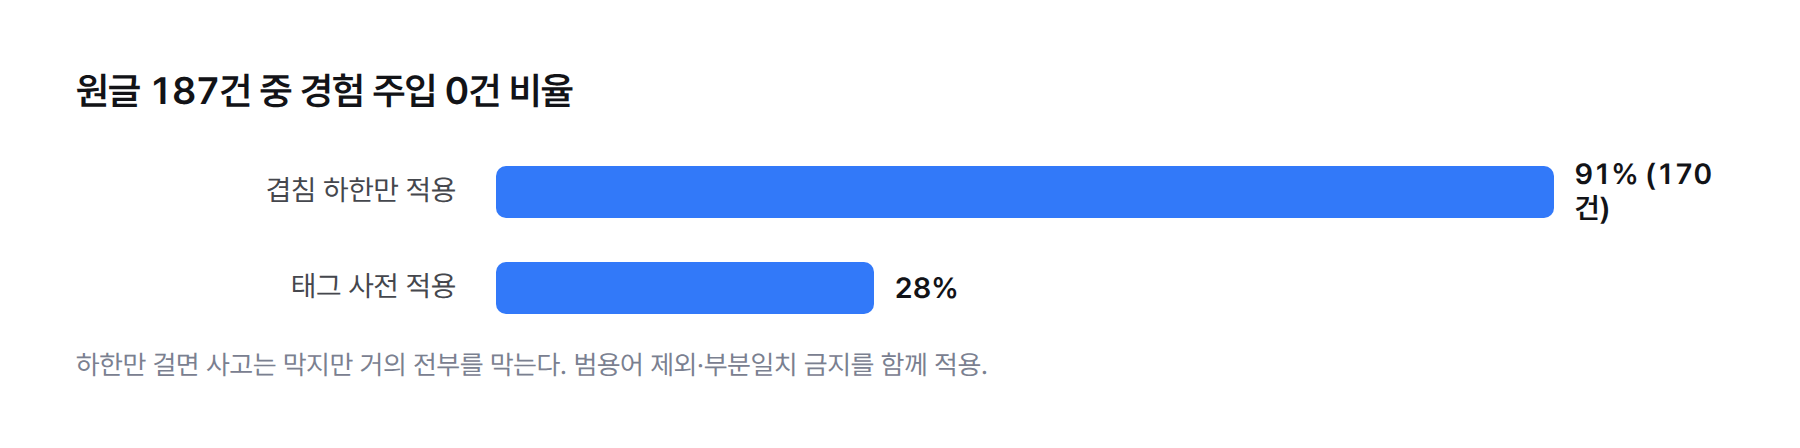
수리를 한쪽으로만 재면 과잉 교정을 모릅니다. 그래서 막아야 할 쪽과 살려야 할 쪽을 같이 쟀습니다. 먼저 겹침 하한만 걸어 봤습니다. 답글 후보로 모아 둔 원글 187건에 돌리니 170건, 91%가 경험 주입 0건이 됐습니다. 사고는 확실히 막았지만, 거의 모든 글에서 경험을 못 쓰게 막는 벽이었습니다.
태그 사전으로 바꾸자 주입 0건 비율은 28%까지 내려왔습니다. 그 과정에서 두 가지를 더 고쳤습니다. '가격·비용·개발·전달'처럼 어느 글에나 나오는 범용어를 태그에서 뺐고, 부분일치를 금지했습니다. 부분일치를 허용했더니 '재개발'의 '개발'이 광고 경험 3건을 끌어왔기 때문입니다. 이번 사고와 똑같은 모양이 수리 과정에서 한 번 더 재현된 셈입니다.
마지막으로 회귀 테스트 47건으로 양쪽을 고정했습니다. 사고를 낸 원글 5종에는 경험이 하나도 실리지 않아야 하고, 경험을 써야 맞는 원글 5종에는 전부 실려야 하며, 태그 주석은 한 글자도 새지 않아야 합니다. 47건이 전부 통과한 뒤에 회수를 실행했습니다.
같은 실수를 막는 장치는 무엇인가?
이번 사고는 감시기가 아니라 사람의 눈이 찾았습니다. 운영자가 마침 피드를 보지 않았다면 그 답글들은 계속 남아 있었을 겁니다. 발송 직전 검사는 그 한 건만, 그 순간에만 봅니다. 상대 글과 실제로 얼마나 겹치는지, 같은 일화를 며칠에 걸쳐 돌려 썼는지, 상대가 어떻게 반응했는지는 원리상 나간 뒤에야 알 수 있습니다. 그래서 같은 날 사후 검수를 붙였습니다.
- 발송 시점에 짝을 남긴다 — 발송 기록에 원글 본문·작성자·선정 이유·실제로 실린 경험을 함께 적는다. 사고 추적 때는 우리 답글만 있어서 원글을 따로 찾아 붙여야 했고, 21건 중 1건은 끝내 못 찾았다
- 매일 원글과 답글을 나란히 놓고 다시 본다 — 검수 스크립트가 짝마다 위험 신호를 붙여 위험순으로 정렬하고, 조치 후보가 있을 때만 개인 알림을 보낸다
- 완료 판정은 과거 사고로 잰다 — 합성 예시가 아니라 실제로 회수한 8건으로 검증했고, 8건 전원에 신호가 떴다(강한 신호 6, 약한 신호 2)
신호를 강약 두 등급으로 나눈 데도 이유가 있습니다. 처음엔 한 덩어리였는데, 실제 21건에 돌리니 16건에 신호가 떠서 '전부 보라'와 다를 바 없었습니다. 순서를 못 매기는 목록은 사람이 안 봅니다. 유지한 답글 13건 중에서는 무신호가 5건, 강한 신호가 2건이었습니다.
이 장치로 끝나지도 않았습니다. 한 달 뒤, 로블록스 게임 런칭 글의 여덟 문장 중 한 곳에 '광고비'가 스쳐 지나갔는데 태그 두 개가 걸려 광고 경험 3건이 실리고 검색광고 답글이 나갔습니다. 태그가 한 번만 나와도 채택하던 규칙의 빈틈이었습니다. 긴 글에서는 태그가 서로 다른 자리에서 두 번 이상 나와야 채택하도록 바꾸자, 경험이 실리는 원글은 152건에서 85건으로 줄었고 테스트 63건이 전부 통과했습니다. 관련성 판정은 한 번에 맞추는 문제가 아니라, 나간 것을 다시 보며 계속 좁혀 가는 문제임을 이때 다시 확인했습니다. 발송 직전 검사를 사실 확인 쪽으로 설계한 사례는 카카오 챗봇 답변 사실 검사에 따로 적었습니다.
LLM 자동 답글을 만든다면 무엇부터 확인해야 하나?
돌아보면 이번 디버깅에서 첫 가설이 너무 그럴듯했다는 점이 가장 비쌌습니다. 결함이 실제로 있는 함수였기에 거기서 멈추기 쉬웠습니다. 그 함수가 지금 돌고 있는지부터 확인한 한 단계가 진짜 원인으로 가는 길을 열었습니다.
- 의심한 코드가 사고 시점에 실제로 실행됐는지부터 본다 — 결함이 있는 코드와 사고를 낸 코드는 다르다
- 프롬프트에 무엇이 실렸는지 원문으로 본다 — 실린 자료는 모델에게 '관련 있다'는 신호다
- 사람이 고른 자료도 글마다 고른다 — 참인가와 이 글에 맞는가는 다른 질문이다
- 막는 쪽과 살리는 쪽을 같이 잰다 — 하한만 걸면 91%를 막는 벽이 생긴다
- 나간 것을 다시 보는 장치를 둔다 — 발송 직전 검사는 한 건씩만 본다
참고 자료를 쥐여 주는 LLM 시스템은 자료가 많을수록 똑똑해질 것 같지만, 실제로는 무엇을 빼느냐가 품질을 가릅니다. 사내 문서로 답하는 챗봇이나 고객 문의 자동 응대처럼 비슷한 구조를 도입하려는데 어디서부터 점검할지 막막하다면 상담으로 현재 구조를 알려 주세요.