무엇이 문제였나: '관련 있음'이 쌓일수록 판단이 흐려졌다
LLM 분류 프롬프트에 '주제가 맞는가'만 물으면, 주제는 맞지만 저희 고객 이야기가 아닌 글을 그대로 통과시킵니다. 저희는 이 사실을 첫 수집 결과 71건을 전부 버리고 나서야 알았습니다.
배경부터 적겠습니다. 저희는 다음에 공략할 시장을 고르려고 작은 수집 엔진을 만들었습니다. 정해진 시각마다 온라인 커뮤니티 글을 가져오고, 글 한 건마다 LLM에게 '이 글이 우리 후보 시장과 관련 있는가'를 묻고, 관련 있다고 나온 글을 신호로 쌓습니다. 신호가 많이 쌓이는 시장일수록 점수가 올라가고, 그 점수로 어느 시장에 먼저 들어갈지 정하는 구조였습니다.
후보 시장은 세 곳이었습니다. 노무사·세무사·공인중개사 같은 전문직 소상공인, 영업 자동화가 필요한 B2B 영업 조직, 스마트스토어·쿠팡에서 파는 이커머스 셀러입니다. 셋 다 한국 시장이 전제였습니다. 해외에 같은 업종이 있어도 저희가 팔 수 있는 상대는 한국 사업자뿐이기 때문입니다.
첫 수집처는 해외 개발자 커뮤니티인 해커뉴스(Hacker News)였습니다. 공개 검색이 쉽고 B2B 도구 이야기가 많아서 출발점으로 골랐습니다. 하루치를 모아 보니 '관련 있음' 신호가 넉넉히 쌓였고, 화면만 보면 엔진이 잘 돌아가는 것처럼 보였습니다.
문제는 이 신호를 믿고 시장 점수를 계산한다는 점이었습니다. 신호가 잘못 들어오면 점수가 틀리고, 점수가 틀리면 들어갈 시장을 잘못 고릅니다. LLM 호출은 글마다 비용이 들기 때문에, 엉뚱한 글을 판정하는 데 쓴 돈도 그대로 낭비였습니다. 비용, 판단 품질, 시간 세 가지가 모두 이 판정 한 줄에 걸려 있었습니다.
처음 잰 숫자는 무엇이었나
첫 측정은 판정 결과를 두 묶음으로 나눠 세는 방식이었습니다. LLM이 '관련 있음'으로 판정한 글과 '관련 없음'으로 판정한 글을 따로 세고, 눈에 띄게 이상한 쪽을 열어 봤습니다.
하루 수집분은 82건이었습니다. 그중 '관련 있음'이 71건, '관련 없음'이 11건이었습니다. '관련 없음' 11건 가운데 7건은 전문직 소상공인 시장으로 들어온 글이었습니다. 이 시장에 넣어 둔 영어 검색어 'real estate agent CRM'이 미국·인도 부동산 콘텐츠를 끌고 왔고, 글 내용과 상관없이 URL 주소 문자열이 검색어와 우연히 겹친 글도 3건 있었습니다. 터미널 도구 tmux 관련 글이 그렇게 걸려 들어왔습니다.
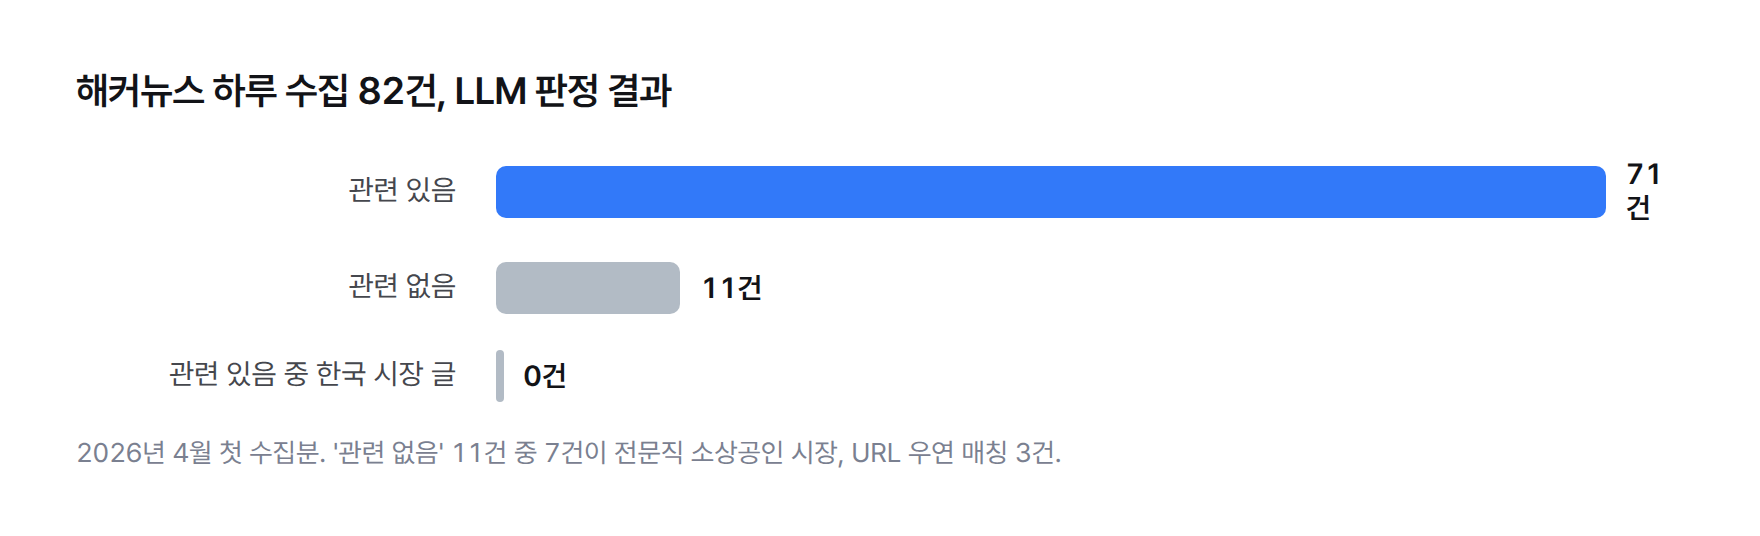
이 시점의 판단은 단순했습니다. 눈에 보이는 잡음은 '관련 없음' 11건 쪽에 있었고, LLM은 그 잡음을 제대로 걸러 냈다고 봤습니다. 그래서 저희가 할 일은 애초에 잡음이 덜 들어오게 수집 단계를 고치는 것이라고 생각했습니다. 당시 기록에 적은 오탐률 추정치는 13%였고, 목표는 5% 미만이었습니다.
돌아보면 이 단계에서 빠진 일이 하나 있었습니다. '관련 있음' 71건은 한 건도 열어 보지 않았습니다. LLM이 통과시킨 쪽은 맞았다고 가정했고, 측정은 LLM이 거절한 쪽에만 했습니다.
세운 가설: 영어 검색 키워드가 잡음을 끌고 온다
첫 가설은 검색 키워드였습니다. 'real estate agent CRM', 'shopify seller automation', 'cold email automation' 같은 영어 일반 키워드는 전 세계 글을 다 잡습니다. 이 키워드를 빼고 한국어 키워드와 'Korean B2B sales automation'처럼 한국으로 범위를 좁힌 영어 키워드만 남기면, 들어오는 글 자체가 한국 쪽으로 기울 거라고 봤습니다.
이 가설에는 근거가 있었습니다. 실제로 '관련 없음' 11건 가운데 7건이 영어 일반 키워드 하나에서 나왔고, URL 우연 매칭 3건도 키워드 탓이었습니다. 수집 단계에서 막으면 LLM 호출 자체가 줄어서, 프롬프트를 고치는 쪽보다 비용도 적게 든다고 계산했습니다.
그래서 키워드를 좁혔습니다. 수집 경로 두 곳(서버에서 도는 수집 경로와 로컬 테스트용 수집 스크립트)의 키워드 목록을 같이 바꿨고, 기대 효과로 오탐률 13%에서 5% 미만을 적었습니다. 한국 사업을 영어로 다루는 글, 예를 들어 해외에 사는 한국인 창업자의 글은 여전히 잡을 수 있게 한국 한정 영어 키워드는 남겼습니다.
가설은 어디서 틀렸나
키워드를 좁힌 뒤 두 번째 수집을 돌리자 들어온 신호가 1건뿐이었습니다. 숫자가 이렇게 줄자 오히려 의심이 들었습니다. 키워드를 바꿨다고 신호가 1건만 남는다면, 처음 71건은 무엇이었는가 하는 질문입니다.
그래서 처음으로 '관련 있음' 쪽을 열었습니다. 새로 들어온 1건과 전날 '관련 있음' 71건 가운데 20건을 표본으로 골라 한 건씩 읽었습니다. 판정 기준은 하나였습니다. 이 글이 한국 시장, 한국 사업자, 한국 구매자 이야기인가.
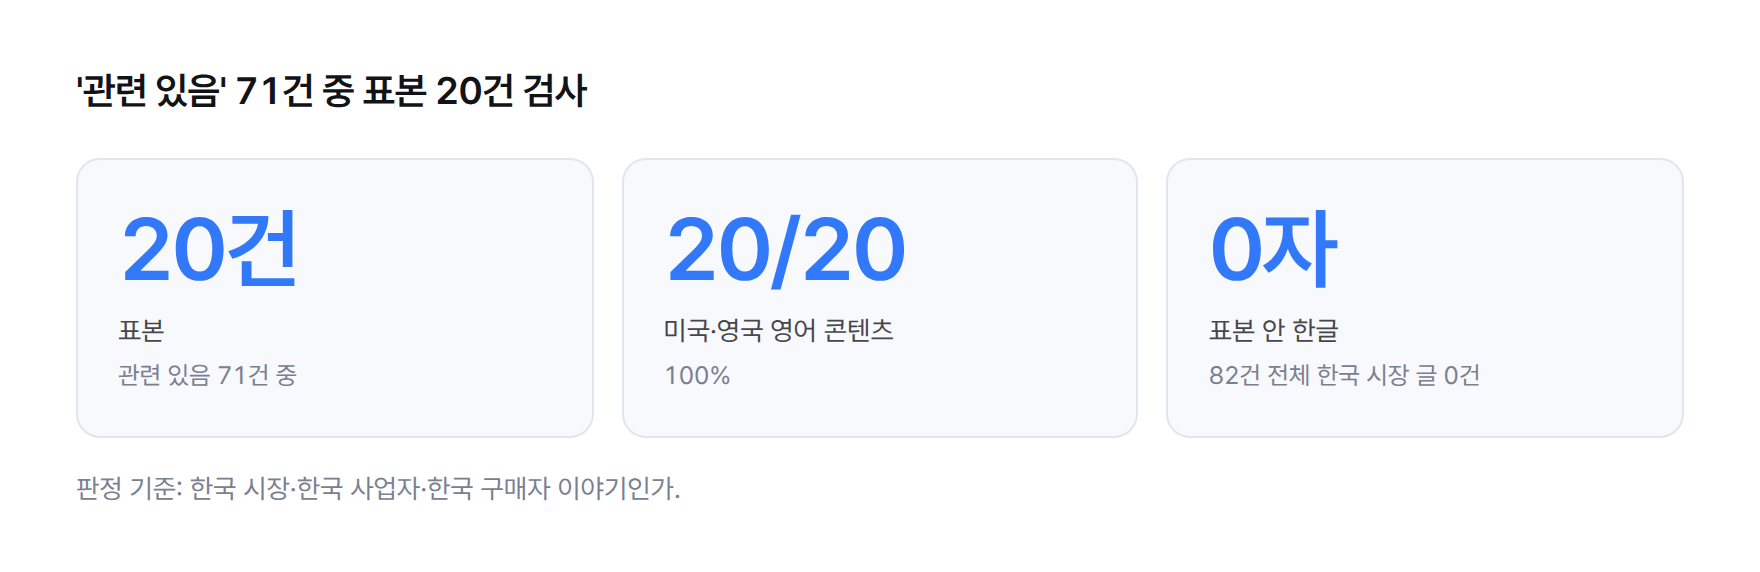
결과는 20건 중 20건, 100%가 미국·영국의 영어 콘텐츠였습니다. 표본 안에 한글은 한 글자도 없었습니다. 이후 82건 전체를 다시 확인했을 때도 한국 이상적 고객군에 해당하는 글은 0건이었습니다. 71건은 일부가 틀린 게 아니라 전부 오탐이었습니다.
가설이 틀린 지점은 측정 대상이었습니다. 저희는 잡음이 '관련 없음' 쪽에 있다고 보고 그쪽 비율로 오탐률 13%를 냈는데, 진짜 오탐은 LLM이 통과시킨 쪽에 있었습니다. 키워드를 좁히면 들어오는 양은 줄지만, 들어온 글을 잘못 판정하는 문제는 그대로 남습니다. 키워드 가설은 증상 일부를 설명했을 뿐 원인을 짚지 못했습니다.
진짜 원인은 무엇이었나: 주제는 맞고 고객은 틀렸다
원인은 판정 프롬프트의 정의에 있었습니다. 시스템 프롬프트에는 '주제에서 벗어나면(off-topic) 관련 없음'이라는 정의만 있었고, '우리 고객이 아니면(off-ICP) 관련 없음'이라는 정의가 없었습니다.
이 정의 아래에서 LLM의 판정은 오히려 정확했습니다. 미국 시장의 B2B 영업 자동화 글은 주제로 보면 B2B 영업 자동화가 맞습니다. 그러니 LLM은 이 글을 '관련 있음'으로 판정했습니다. 저희가 물은 질문에 맞게 답한 셈이고, 틀린 쪽은 질문이었습니다.
LLM은 'B2B sales automation about US market'을 관련 있음으로 판단했다. 프롬프트에는 off-topic 정의만 있었고 off-ICP 정의가 없었다.
수집처도 원인의 절반이었습니다. 해커뉴스는 영어권 전 세계 개발자가 모이는 곳이라, 한국의 노무사나 스마트스토어 셀러가 쓴 글이 거의 없습니다. 프롬프트가 고객 조건을 몰랐고, 수집처에는 애초에 저희 고객이 없었습니다. 두 문제가 겹치자 '관련 있음' 신호가 넉넉하게 쌓이는 겉모습이 만들어졌습니다.
한 가지 더 드러났습니다. 같은 글이 같은 후보 시장에서 판정될 때 '관련 있음'과 '관련 없음'이 엇갈린 경우가 4번 있었습니다. LLM 출력의 무작위성에, 시스템 프롬프트가 세 후보 시장의 정의를 한꺼번에 보여 주는 구조가 겹쳐 판정 관점이 섞일 수 있었습니다. 기준이 흔들리는 분류기는 오탐을 줄여도 결과를 믿기 어렵습니다.
조치: 프롬프트에 '누구의 이야기인가'를 넣었다
첫 조치는 시스템 프롬프트를 고객 기준으로 다시 쓰는 일이었습니다. 바꾼 내용은 네 가지입니다.
- 이상적 고객군 설명 섹션을 새로 넣고, 세 후보 시장이 각각 한국의 어떤 사업자인지 정의했습니다.
- '관련 있음' 조건을 한국 시장(Korean market), 한국 사업자(Korean operators), 한국 구매자(Korean buyers) 이야기로 한정했습니다.
- 고객이 아닌 예시로 미국·영국 콘텐츠를 프롬프트에 직접 적었습니다.
- 판정 이유 칸이 반드시 'ICP=yes' 또는 'ICP=no (<이유>)'로 시작하게 했습니다. 판정마다 고객 조건을 먼저 따지게 만드는 장치입니다.
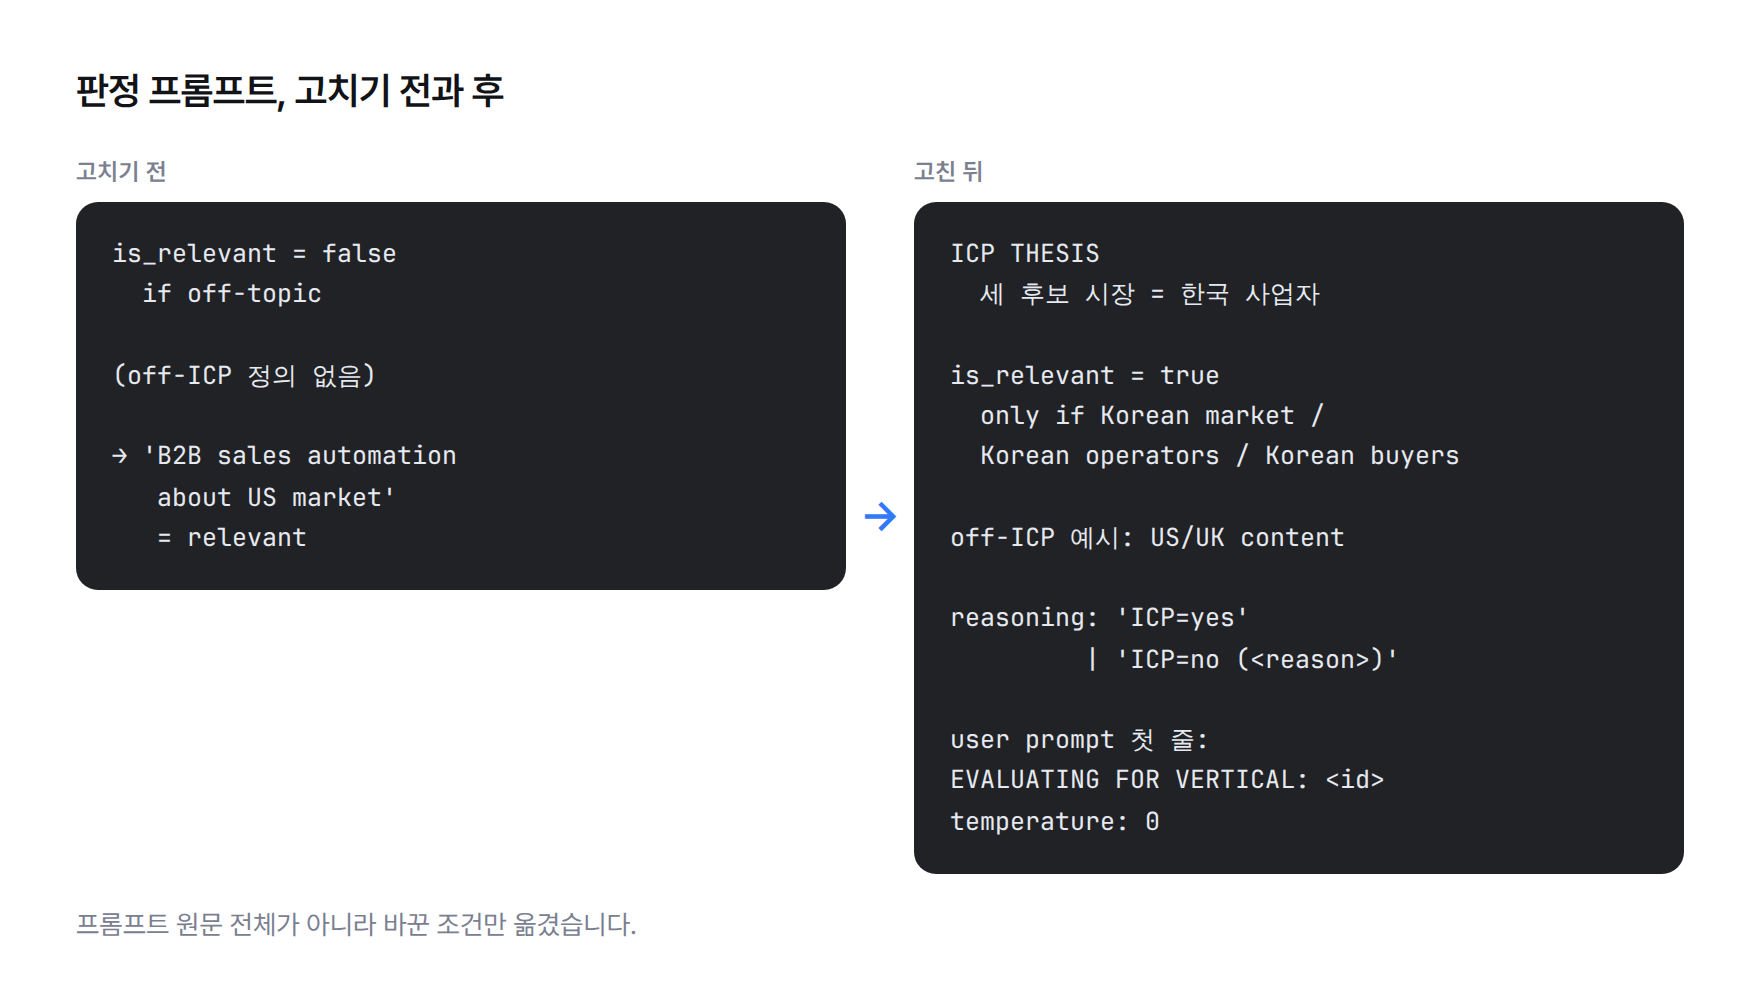
판정이 엇갈리던 문제는 두 가지로 막았습니다. Anthropic SDK의 client.messages.create() 호출에 temperature를 0으로 명시해 같은 입력에 같은 출력이 나오게 했습니다. 그리고 판정 함수에 대상 시장 값을 넘겨, 사용자 프롬프트 첫 줄에 'EVALUATING FOR VERTICAL: <id> (use ONLY this vertical's ICP definition; ignore others)'를 붙였습니다. 세 시장 정의가 다 보이더라도 이번 호출은 한 시장의 관점으로만 판정하라는 지시입니다.
기각한 대안도 남깁니다. 첫째, 글에 한글이 들어 있는지를 코드로 검사하는 하드 필터입니다. 가장 싸고 확실해 보였지만, 한국 시장을 영어로 분석한 글이나 해외에 사는 한국인이 영어로 쓴 글까지 버립니다. 둘째, 대시보드에서 사람이 고객 여부를 직접 거르는 방식입니다. 양이 늘면 감당할 수 없어서 뺐습니다. temperature도 0.3처럼 낮추는 정도에서 멈추지 않고 0으로 고정했습니다.
수집처도 바꿨습니다. 해커뉴스만 보는 구조로는 한국 고객 신호를 얻을 수 없다는 사실이 숫자로 드러났기 때문에, 수집처 다양화를 다음 기능 목록에서 가장 급한 일로 올렸습니다. 국내 메이커 커뮤니티 디스콰이엇과 국내 IT 커뮤니티 클리앙의 창업 게시판을 차례로 붙였습니다.
새 수집처에서도 LLM 비용을 먼저 따졌습니다. 디스콰이엇은 서버 쪽 주제 필터가 동작하지 않아서, 4개의 서로 다른 주제로 요청해도 똑같은 최신 글 3건이 돌아왔습니다. 그래서 수집할 때마다 글 200건을 요청 4번 정도에 나눠 가져오고, 같은 결과를 5분 동안 캐시에 두고, 키워드 정규식을 통과한 글만 LLM에 넘기게 했습니다. 넓게 가져오는 단계는 비용이 들지 않고, 돈이 드는 판정은 걸러진 글에만 씁니다. 클리앙은 글 본문까지 가져오면 글마다 요청이 하나씩 더 붙어서, 목록의 제목과 분류만으로 판정하는 쪽을 택했습니다.
마지막으로 이미 쌓인 데이터를 정정했습니다. 고객 조건이 들어가기 전인 2026년 4월 29일에 '관련 있음'으로 들어간 해커뉴스 글 72건의 판정 값을 SQL로 '관련 없음'으로 바꿨습니다. LLM 판정을 사람이 뒤집은 게 아니라, 잘못된 기준으로 쌓인 시스템 오류를 바로잡는 정정으로 기록했습니다.
재측정 결과는 어땠나
재측정은 같은 방식으로 했습니다. 수집처별로 들어온 글 수와 '관련 있음' 판정 수를 세고, '관련 있음' 쪽을 직접 열어 실제로 누구의 글인지 확인했습니다. 처음에 빠뜨렸던 바로 그 단계입니다.
고객 기준 프롬프트를 넣은 뒤 첫 해커뉴스 수집에서 들어온 신호는 1건이었습니다. 하루 71건과 비교하면 거의 사라진 셈인데, 이건 프롬프트가 망가져서가 아니라 해커뉴스에 한국 고객 글이 원래 없다는 사실이 정직하게 드러난 결과였습니다.
국내 수집처에서는 처음으로 진짜 신호가 잡혔습니다. 디스콰이엇은 게시판 쪽 필터가 동작하지 않아서 최신 글을 50건 단위로 200건까지 넓게 가져온 뒤, 시장별 키워드 정규식으로 먼저 거르고 남은 글만 LLM에 넘겼습니다. 첫날 16건이 들어와 5건이 '관련 있음'이었습니다. 클리앙 창업 게시판은 본문 없이 제목과 분류만 가져왔고, 5건 중 3건이 '관련 있음'이었습니다. 누적 '관련 있음'은 9건이 됐습니다.
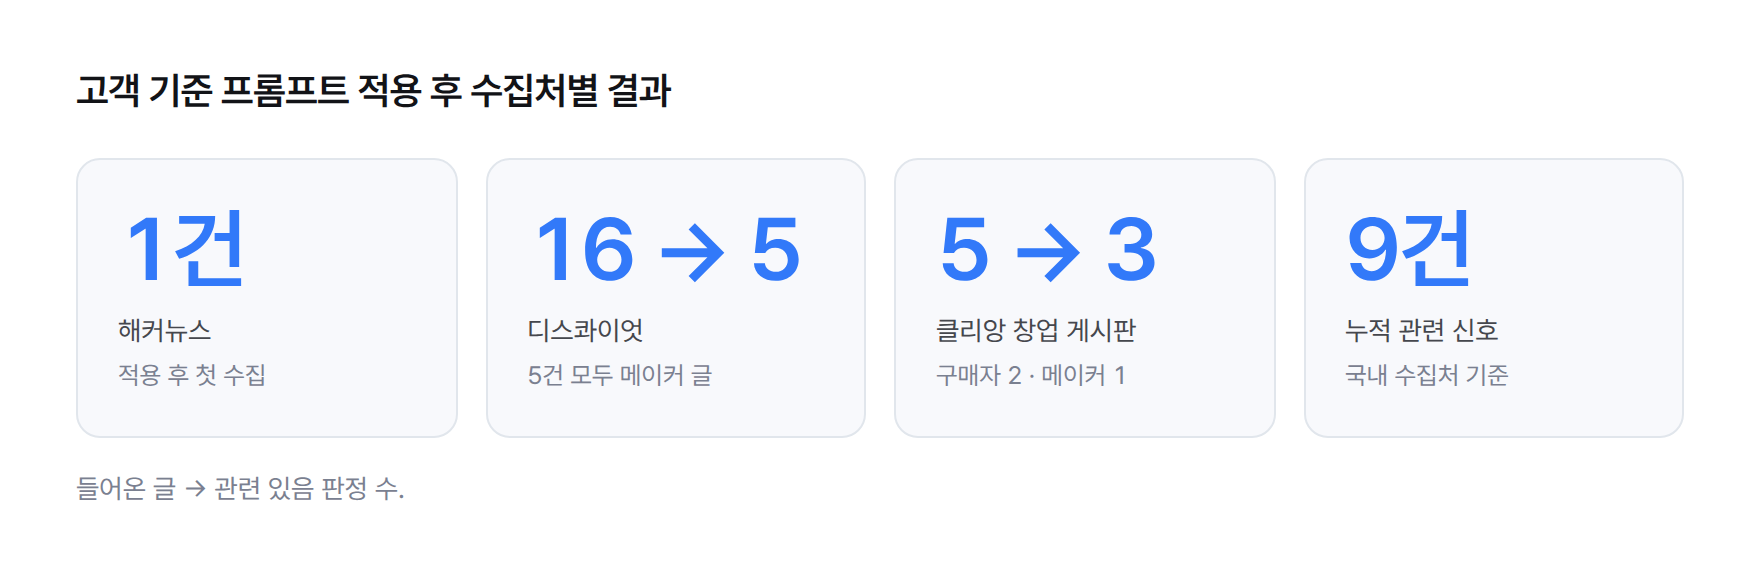
이번에는 '관련 있음' 쪽을 열어 봤습니다. 디스콰이엇의 5건은 5건 모두 자기 제품을 만드는 메이커가 쓴 글이었고, 제품을 사는 쪽의 글은 0건이었습니다. 한국 고객 조건은 통과했지만, 구매자의 고민을 확인하는 데는 맞지 않는 신호였습니다. 그래서 디스콰이엇은 경쟁·트렌드를 보는 수집처로 따로 분류했습니다. 클리앙의 3건은 구매자 시각 2건과 메이커 시각 1건이었고, 구매자 고민이 처음으로 보이기 시작했습니다.
오탐을 지우자 시장 순위는 어떻게 바뀌었나
오탐이 미친 영향은 판정 화면보다 시장 점수에서 더 크게 드러났습니다. 데이터를 정정하기 전, 3일치 누적 데이터로 계산한 10점 만점 점수는 이커머스 셀러 4.7, 전문직 소상공인 4.6, B2B 영업 4.1 순이었습니다. B2B 영업 시장에는 실제 한국 영업 자동화 서비스처럼 질 좋은 신호가 9건 있었는데도 가장 낮았습니다.
원인은 셋이었습니다. 고객 조건이 없던 시기의 오탐 71건이 평균을 끌어내렸고, 점수 산식이 신호 개수를 반영하지 않아 강도 4짜리 신호 1건과 평균 3짜리 신호 9건이 같은 점수를 받았고, 기간 제한이 없어 오래된 신호가 계속 점수에 남았습니다.
그래서 산식도 함께 고쳤습니다. 신호 개수로 가중한 평균을 쓰고, 신호 수가 늘수록 완만하게 올라가는 항을 곱하고, 신호 유형이 다양할수록 0.5에서 1.0 사이로 올라가는 항을 더했습니다. 계산 대상은 최근 14일 신호로 제한했습니다. 강도 3짜리 신호 30건이 유형 4가지에 걸쳐 있으면 약 5.7점이 나오도록 눈금을 맞췄고, 시장을 계속 볼지 접을지 가르는 기준선 6점은 일부러 보수적으로 남겼습니다.
| 후보 시장 | 정정 전 | 정정 후 | 순위 변화 |
|---|---|---|---|
| B2B 영업 조직 | 4.1 | 2.4 | 3위 → 1위 |
| 전문직 소상공인 | 4.6 | 1.7 | 2위 → 2위 |
| 이커머스 셀러 | 4.7 | 0.9 | 1위 → 3위 |
정정 = 2026년 4월 29일 오탐 72건 판정 값 수정 + 신호 수 가중·다양성·14일 기간 산식 적용
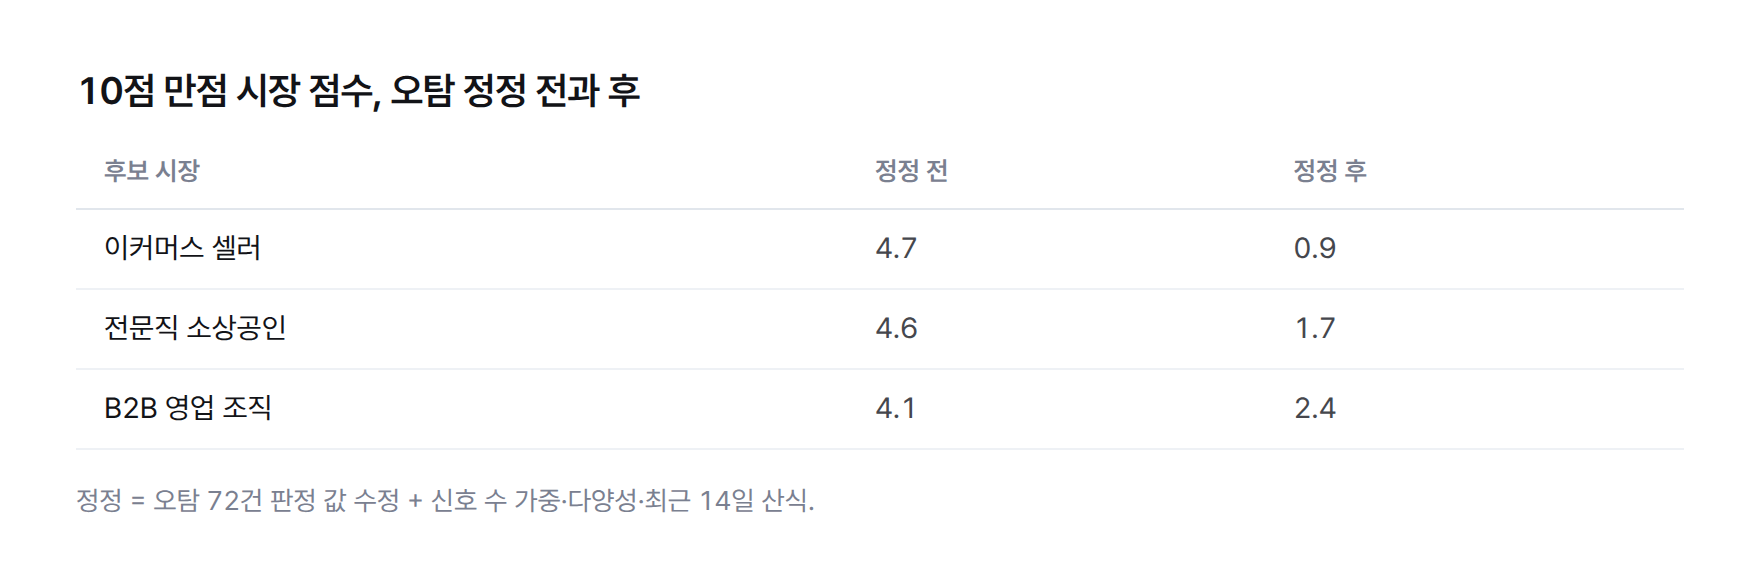
정정 후 순위는 B2B 영업 2.4, 전문직 소상공인 1.7, 이커머스 셀러 0.9로 뒤집혔습니다. 질 좋은 신호가 가장 많던 시장이 1위로 올라와 직관과 맞았습니다. 절대 점수는 모두 낮아졌는데, 3일치 데이터가 부족하다는 사실을 그대로 보여 주는 숫자라서 일부러 손대지 않았습니다. 오탐 71건이 쌓인 채로 결정했다면, 저희는 점수가 가장 높던 이커머스 셀러 시장부터 들어갔을 겁니다.
남는 한계
이 개선기에는 아직 닫지 못한 구멍이 셋 있습니다.
첫째, 프롬프트를 고칠 때 적은 기대치 '71건에서 0~2건'은 예측이었고, 같은 해커뉴스 하루 분량을 새 프롬프트로 다시 판정해 0~2건이 나오는지 따로 세지는 않았습니다. 그다음 수집에서 신호가 1건 들어왔다는 기록이 있을 뿐입니다. 같은 입력을 옛 프롬프트와 새 프롬프트로 나란히 돌리는 비교를 했다면 개선 폭을 더 깔끔하게 말할 수 있었습니다.
둘째, 숫자 하나가 맞지 않습니다. 처음 기록에는 '관련 있음'이 71건으로 적혀 있는데, 나중에 판정 값을 고친 SQL 정정은 72건이었습니다. 이 1건 차이가 어디서 왔는지는 기록에 설명이 없습니다. 이런 차이를 그대로 두면 다음 사람이 어느 숫자를 믿어야 할지 모릅니다.
셋째, 고객 조건을 통과한 신호가 곧 구매자 신호는 아니었습니다. 디스콰이엇 5건이 전부 메이커 글이었던 것처럼, 수집처가 누구의 목소리를 모으는지는 프롬프트로 고칠 수 없습니다. 클리앙 창업 게시판은 창업자이면서 구매자인 사람이 섞인 곳이고, 본문 없이 제목만 판정한다는 한계도 있습니다. temperature 0과 시장별 관점 지시도 판정 흔들림을 줄이려는 조치였을 뿐, 같은 글의 시장 간 일관성은 이후 수집에서 재기로 하고 남겨 뒀습니다.
LLM 판정 결과를 점수로 쓰다 보면, 점수의 흔들림 자체를 따로 재야 하는 순간이 옵니다. 이 문제는 LLM 채점 점수의 흔들림을 결정적 지표로 다시 잰 기록에서 이어서 다뤘습니다.
LLM 분류 프롬프트를 쓸 때 먼저 확인할 것은 무엇인가
이 일에서 얻은 교훈은 세 줄로 줄일 수 있습니다. 하나, 분류기가 통과시킨 쪽을 먼저 열어 봅니다. 거절한 쪽만 보면 오탐률을 거꾸로 측정합니다. 저희는 '관련 없음' 11건으로 13%를 계산했지만, 진짜 오탐은 '관련 있음' 71건에 있었습니다.
둘, 프롬프트에 주제 조건과 대상 조건을 따로 적습니다. '무엇에 관한 글인가'와 '누구의 이야기인가'는 다른 질문이고, LLM은 묻지 않은 조건을 스스로 적용하지 않습니다. 판정 이유 칸이 대상 조건부터 답하게 만들면, 나중에 표본을 검사할 때도 어디서 틀렸는지 바로 보입니다.
셋, 표본 20건이면 충분히 드러납니다. 저희는 71건 중 20건을 읽는 데서 원인을 찾았습니다. 대단한 평가 체계보다 '관련 있음' 표본을 사람이 직접 읽는 일이 먼저였습니다. 자사 데이터로 LLM 분류나 자동화 흐름을 설계하다 막힌 지점이 있다면 상담에서 상황을 들려주셔도 좋습니다.