무엇이 문제였나: 후보 14건 중 13건이 엉뚱한 질문
네이버 지식iN 검색 API로 질문을 모으는데 고를 질문이 하루 0건이 된 원인은 정렬 파라미터 하나였습니다. 선정이 0건으로 떨어진 날의 전날, 저희 스크립트는 하루 후보 14건을 가져왔고 그중 13건이 저희가 다루는 주제와 무관한 질문이었습니다. 키워드는 “영업 관리 프로그램”, “홈페이지 제작 비용”처럼 저희 판매 서비스와 바로 이어지는 말인데, 돌아온 질문은 그 말과 거리가 멀었습니다.
이 파이프라인의 순서를 짧게 설명하겠습니다. 스크립트가 키워드마다 검색 API를 불러 질문 목록을 받고, 이미 본 질문을 빼고, 질문 페이지를 열어 작성일과 답변 상태를 확인한 뒤, AI가 관련성을 점수로 매겨 그날 답할 질문을 고릅니다. 고른 질문마다 AI가 답변 초안을 쓰고, 초안은 사람이 검토하는 대기 질문 목록에 쌓입니다. 앞단에서 엉뚱한 질문이 들어오면 뒤의 모든 단계가 헛돕니다.
비용으로 보면 세 군데가 샜습니다. 첫째, AI 점수 매기기는 호출마다 돈이 드는데 관련 없는 질문에 그 돈을 썼습니다. 둘째, 선정이 0건이면 그날 답변 초안도 0건이고, 검색 노출을 노리는 이 채널 전체가 하루를 쉽니다. 셋째, 대기 질문 목록이 3건까지 줄어 검토할 거리조차 바닥났습니다.
이 일을 처음 짚은 건 회사 대표의 질문이었습니다. “스카우트 후보를 더 많이 뽑아 놔야 하는 거 아니야?” 질문 자체는 자연스러웠습니다. 후보가 안 나오면 후보를 더 모으자는 생각이 먼저 듭니다. 그런데 이 질문에 바로 답하기 전에, 지금 모으는 후보가 왜 쓸모없는지부터 재야 했습니다.
처음 잰 숫자: 10건 중 3건, 그리고 방치된 1,414건
측정은 단순하게 했습니다. 같은 키워드를 두 가지 정렬로 불러 상위 10건씩 받고, 그 10건이 키워드와 실제로 관련 있는 질문인지 하나씩 셌습니다. 네이버 검색 API에는 결과 정렬을 정하는 sort 파라미터가 있고, 값은 date(최신순)와 sim(관련도순) 두 가지입니다. 저희 스크립트는 지금까지 date만 쓰고 있었습니다.
| 키워드 | sort=date 관련 질문 | sort=sim 관련 질문 |
|---|---|---|
| 영업 관리 프로그램 | 3/10 | 10/10 |
| 홈페이지 제작 비용 | 3/10 | 10/10 |
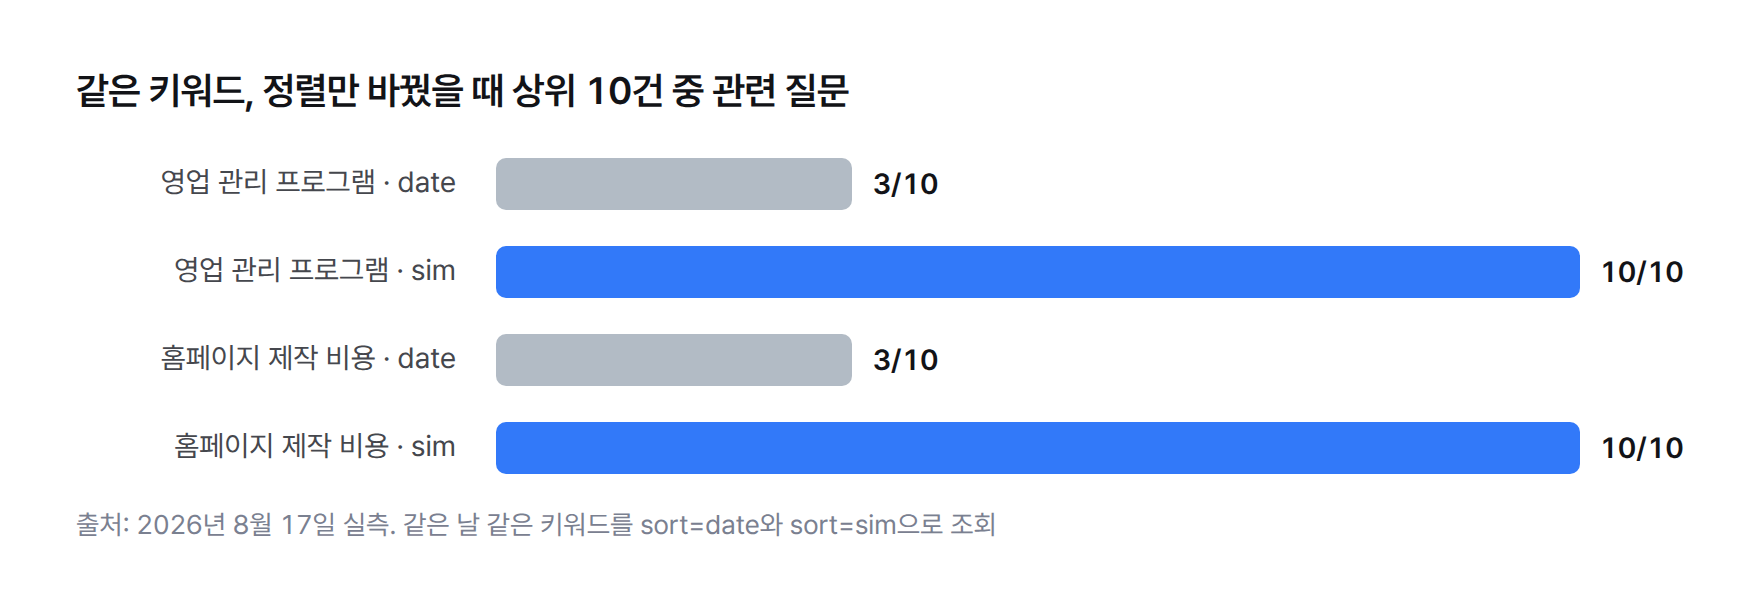
결과는 한쪽으로 쏠렸습니다. 두 키워드 모두 date는 10건 중 3건, sim은 10건 중 10건이 관련 질문이었습니다. 같은 API, 같은 키워드, 같은 날인데 정렬값 하나로 관련도가 뒤집혔습니다.
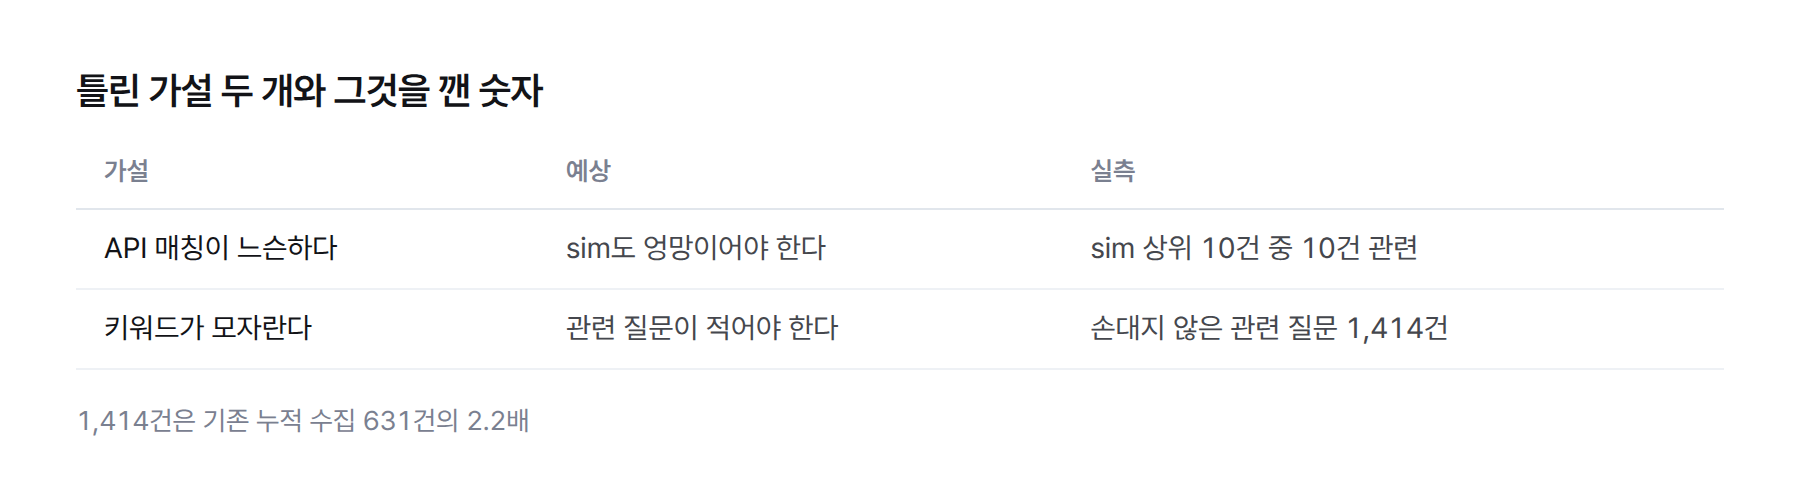
두 번째로 잰 것은 sim 쪽에 쌓여 있는 양입니다. sim 정렬로 조회해 보니 아직 손대지 않은 관련 질문이 1,414건 나왔습니다. 그때까지 date 정렬로 누적 수집한 질문이 631건이었으니, 그 2.2배가 한 번도 후보에 오르지 못한 채 놓여 있었습니다.
2026년 8월 17일 실측. 1,414건은 631건의 2.2배입니다.
처음 세운 가설은 무엇이었나?
이 숫자를 재기 전, 전날 작업에서 내린 결론은 이랬습니다. “네이버 검색 API가 키워드와 느슨하게 매칭하는 구조적 문제다.” 14건 중 13건이 무관하다는 관찰은 맞았습니다. 그런데 거기서 멈추고 원인을 API 쪽 구조로 돌렸습니다. 구조적 문제라고 부르면 저희가 손댈 수 있는 게 없다는 뜻이 됩니다.
네이버 검색 API가 키워드와 느슨하게 매칭하는 구조적 문제다.
두 번째 가설은 대표의 질문에서 나왔습니다. “후보가 적으니 키워드를 늘리면 된다.” 실제로 이 스크립트는 그전에도 키워드 목록을 몇 번 손봤습니다. 2026년 7월 26일에는 하루 신규 질문 유입이 15건에서 2건으로 떨어진 원인을 찾다가, 고정 키워드 13개 중 2개가 이미 판매를 접은 서비스를 겨냥하고 있다는 걸 발견하고 키워드를 21개로 늘렸습니다. 그때 신규 후보가 2건에서 92건으로 46배 늘었습니다.
이 경험이 있으니 이번에도 키워드를 손보는 쪽으로 손이 갔습니다. 두 가설 모두 “입력이 문제다”라는 같은 방향을 보고 있었습니다. API가 엉뚱한 걸 주거나, 우리가 묻는 말이 모자라거나.
가설이 틀린 지점은 어디였나?
첫 번째 가설은 앞의 표 한 장으로 무너졌습니다. API의 매칭이 느슨한 게 원인이라면 sim 정렬로 불러도 결과가 엉망이어야 합니다. 그런데 sim은 10건 중 10건이 관련 질문이었습니다. 매칭은 멀쩡했고, 저희가 고른 정렬이 결과를 흐리고 있었습니다.
두 번째 가설도 같은 숫자에서 틀렸습니다. 후보가 모자라서 선정이 0건이라면, 관련 질문 자체가 적어야 합니다. 그런데 손대지 않은 관련 질문이 1,414건 있었습니다. 공급이 부족한 게 아니라, 이미 있는 공급을 못 보고 있었습니다. 이 상태에서 키워드만 늘리면 새 키워드도 date로 부르게 되고, 같은 정렬 오염이 그대로 따라옵니다.
2026년 8월 9일에도 비슷한 일이 있었습니다. 콘텐츠 발행이 느리다는 질문에 공급 후보를 하나씩 실측했는데, 키워드 씨앗을 13개에서 34개로 늘리자 원시 수확은 5,978개에서 7,935개로 늘었지만 실제로 쓸 수 있는 순증은 +1이었습니다. 입력을 늘리는 해법은 병목이 입력에 있을 때만 통합니다.
그날 실측에서 나온 진짜 병목은 키워드 목록 25개 중 1개(“블로그 대행 업체”)가 판매를 접은 서비스를 겨냥해, 누적 수확 46건이 전부 뒷단 필터에서 버려지던 문제였습니다. 그 한 자리를 살아 있는 서비스 키워드로 바꿨지만 얻은 순증은 작았습니다. 이때도 키워드를 손보는 것만으로는 공급이 크게 안 늘었고, 이번 정렬 문제는 그 다음 층에 숨어 있던 원인이었습니다.
돌아보면 두 가설은 측정을 건너뛴 자리에서 나왔습니다. “구조적 문제”라는 결론도, “키워드를 늘리자”는 해법도 같은 키워드를 정렬만 바꿔 한 번 불러 보는 실험 하나면 판가름 났습니다. 그 실험은 API 호출 몇 번이면 끝나는 일이었습니다.
진짜 원인: sort=date는 질문 최신순이 아니었다
원인은 date 정렬이 무엇을 기준으로 줄을 세우는지에 있었습니다. 이름만 보면 질문을 최근에 올라온 순서로 줄 세울 것 같지만, 실제로는 질문 작성일이 아니라 답변 최신순입니다. 그래서 질문 본문이 키워드와 무관해도, 최근에 달린 답변 본문 어딘가에 키워드 조각이 들어 있으면 결과에 걸립니다.
“영업 관리 프로그램”을 date로 부르면, 이 말과 상관없는 질문에 누군가 답변을 달면서 “프로그램”이나 “관리”를 썼다는 이유만으로 상위에 올라옵니다. 매일 새 답변이 붙는 질문은 많으니, date 상위 10건은 늘 그런 질문으로 채워집니다. 14건 중 13건이 무관했던 이유가 여기 있었습니다.
부끄러운 점은 이 성질을 저희가 이미 알고 있었다는 데 있습니다. 2026년 8월 3일 작업 기록에 “date 정렬은 답변 최신순”이라는 함정이 적혀 있었습니다. 알려진 함정이었는데, 선정 0건이라는 증상과 연결하지 못했습니다. 관찰(14건 중 13건 무관)과 원인(정렬 기준)을 이어 줄 측정을 하지 않고, “구조적 문제”라는 말로 덮었습니다.
이후 2026년 10월 15일에 키워드를 21개에서 40개로 늘릴 때도 같은 오염을 다시 봤습니다. “앱 유지보수”를 date로 부르면 건강보험의 “보수월액” 질문이 섞여 나왔습니다. 그래서 그때 추가한 19개 중 5개는 처음부터 sim 전용 키워드로 넣었습니다.
조치: 두 정렬을 합치고 필터 두 개를 고쳤다
고친 곳은 스크립트 한 파일이지만 바꾼 것은 세 가지입니다. 하나씩 이유와 함께 적겠습니다.
첫째, date와 sim의 합집합입니다. 키워드마다 date로 20건, sim으로 3페이지×30건을 받아 질문 고유번호(docId)로 중복을 지웠습니다. sim만 쓰지 않은 이유가 있습니다. sim은 순위가 안정적이라 매일 거의 같은 상위 질문을 줍니다. 그러면 새로 올라온 질문이 공급에서 끊깁니다. 관련도는 sim이, 신선함은 date가 맡는 구조입니다.
여기서 하나 더 신경 쓴 부분이 루프 구조입니다. 두 정렬을 한 리스트로 이어 붙여 돌리면, date 결과가 20건이 안 돼 일찍 끝나는 키워드에서 루프가 빠져나가면서 그 키워드의 sim 차례까지 통째로 건너뜁니다. 질문이 적은 키워드일수록 sim이 더 필요한데, 정확히 그 키워드에서 sim이 안 도는 셈입니다. 그래서 두 정렬을 키워드별로 따로 도는 루프로 나눴습니다.
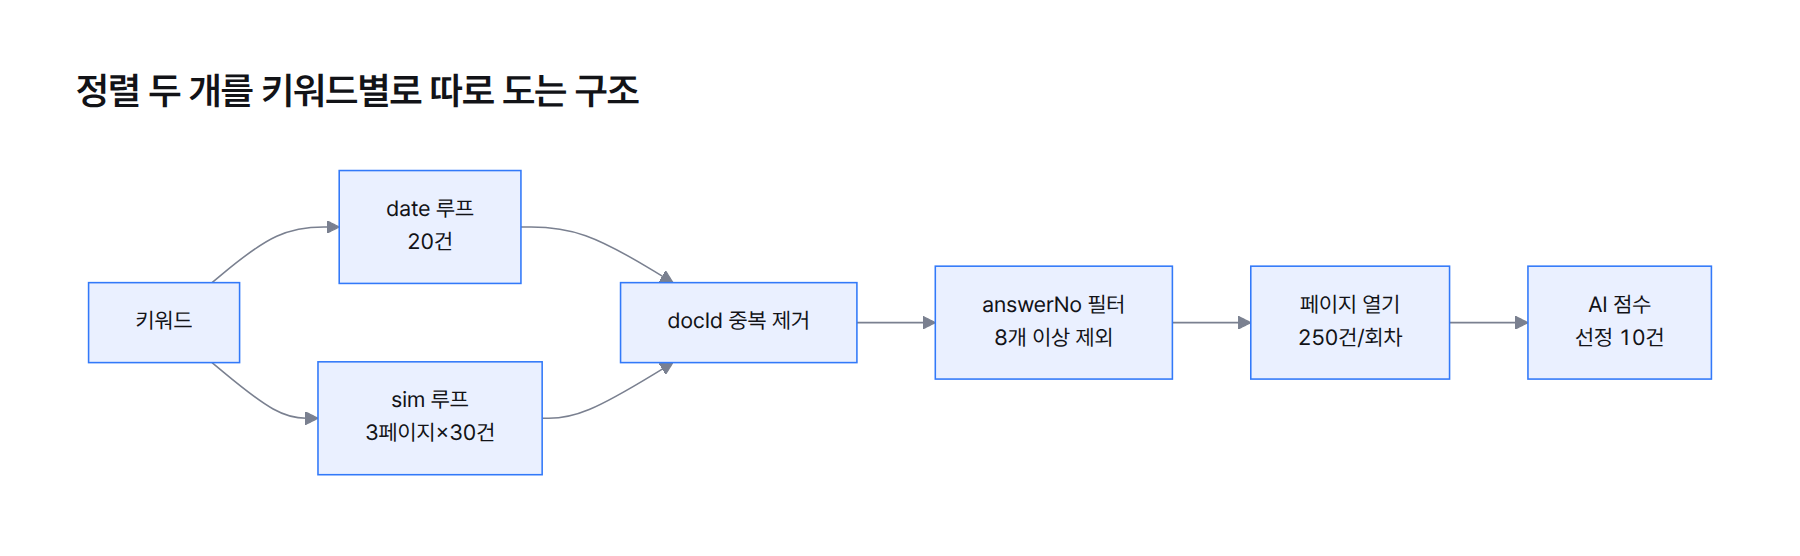
둘째, answerNo 필터입니다. 검색 결과의 링크에는 answerNo=N이라는 값이 붙어 있고, 이 값은 그 답변의 순번입니다. 그래서 페이지를 열지 않고도 “이 질문에는 답변이 최소 N개 있다”는 사실을 공짜로 압니다. 실제로 한 질문이 answerNo=3, 4, 5, 6, 7, 9, 10으로 7번 등장한 사례도 있었습니다. 답변이 8개 이상 달린 질문에는 네이버가 답변 입력창을 내주지 않으므로, 이런 질문은 페이지를 열기 전에 뺐습니다.
이 필터는 sim을 넣었기 때문에 특히 필요했습니다. sim은 관련도가 높은 대신 이미 답변이 많이 쌓인 질문으로 쏠립니다. sim으로 새로 들어온 1,313건 중 12%가 answerNo 8 이상이었습니다. 답변 수를 AI 점수 단계에서 판단하게 하는 방법도 있었지만 버렸습니다. AI 호출은 돈이 들고, answerNo는 이미 손에 쥔 검색 결과에서 정규식 한 줄로 나옵니다. 비용이 0인 필터를 비용이 드는 단계 뒤에 둘 이유가 없습니다.
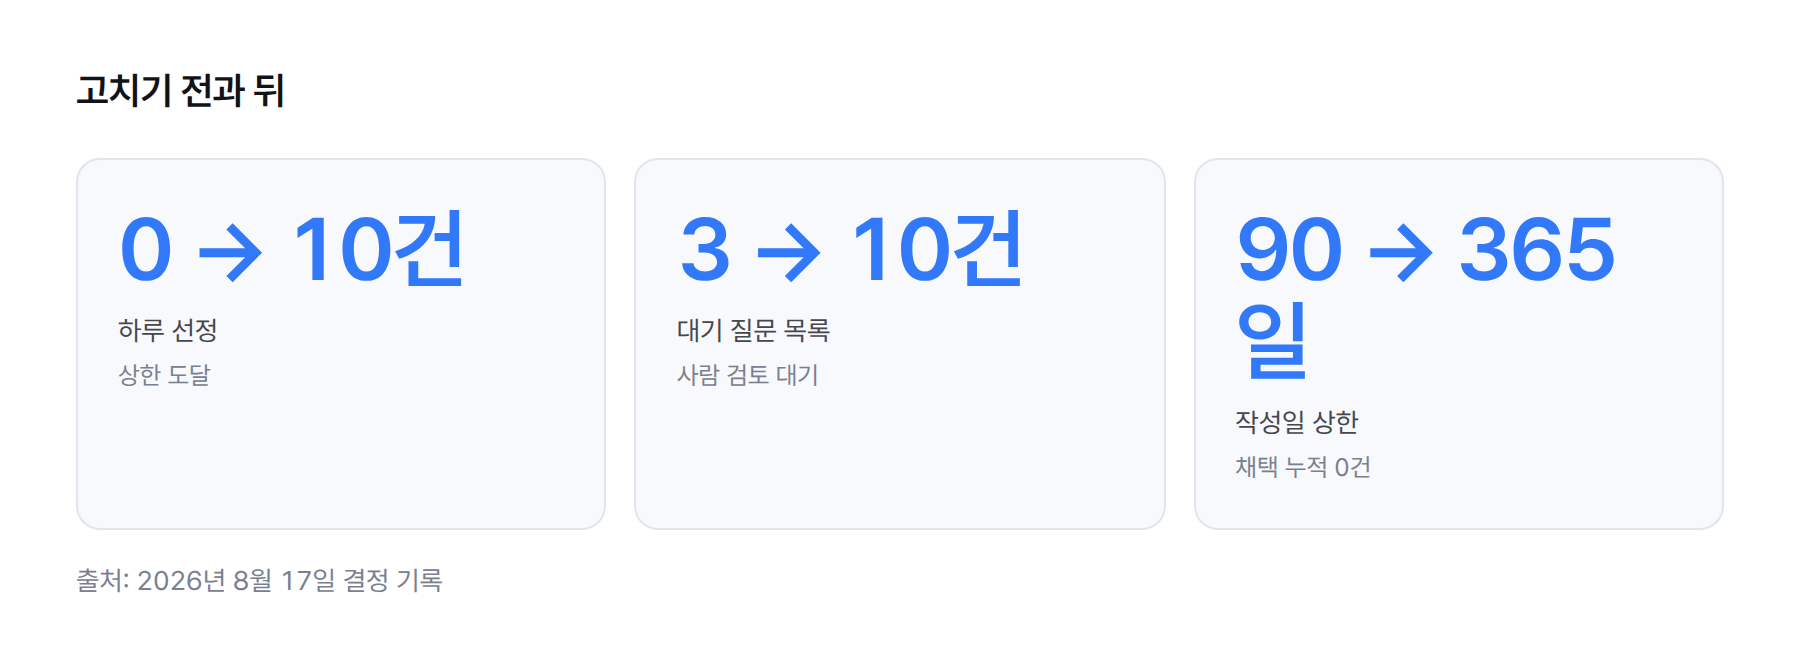
셋째, 질문 작성일 상한을 90일에서 365일로 늘렸습니다. 90일은 질문자가 답변을 채택해 답변자 등급이 오르는 가능성을 지키려고 정한 값이었습니다. 그런데 그때까지 채택은 누적 0건이었고 등급도 그대로였습니다. 이 파이프라인이 실제로 얻는 것은 검색 노출이고, 검색 노출에는 질문의 나이가 상관없습니다. 지키려던 이득이 없는 값을 지키느라 공급을 막고 있었습니다.
표본 60건을 실측해 sim 쪽 쌓인 질문 1,160건에 적용한 추정입니다.
이 세 가지를 고르기 전에 버린 대안도 적어 둡니다. 실패한 길을 지우면 다음에 같은 길로 다시 들어가기 때문입니다.
- 키워드 자체를 더 늘리기: 버렸습니다. 대표의 질문을 표면 그대로 받은 해법이지만, 재 보니 관련 질문 1,414건이 이미 방치돼 있었습니다. 병목이 공급량이 아니라 정렬인데 키워드만 늘리면 새 키워드도 같은 정렬 오염을 안고 들어옵니다.
- sim 하나로 갈아타기(date 폐기): 버렸습니다. sim은 순위가 안정적이라 매일 같은 상위 질문을 주고, 그러면 새로 올라온 질문이 공급에서 끊깁니다. 두 정렬의 합집합이 필요했습니다.
- 답변 수를 AI 점수 단계에서 판단하기: 버렸습니다. AI 호출은 비용이 들지만 answerNo는 이미 받은 검색 결과에서 정규식 한 줄로 나옵니다. 공짜 필터는 비싼 단계보다 앞에 둡니다.
부수 변경도 두 가지 있습니다. 질문 페이지를 여는 횟수에 회차당 250건이라는 예산을 걸고, 넘친 후보는 이미 본 질문 목록에 적지 않고 다음 회차로 넘겼습니다. 그리고 탈락이 확정된 후보(답변 과다·자주 묻는 질문 모음·작성일 초과)도 이미 본 질문 목록에 적었습니다. 전에는 통과한 질문만 적어서 매 회차 같은 탈락 후보의 페이지를 다시 열었습니다. date로 10건씩 받던 시절엔 드러나지 않았지만, sim을 넣어 신규 후보가 천 단위가 되면 이 반복이 실행 시간을 잡아먹습니다.
재측정 결과: 선정 0건에서 10건으로
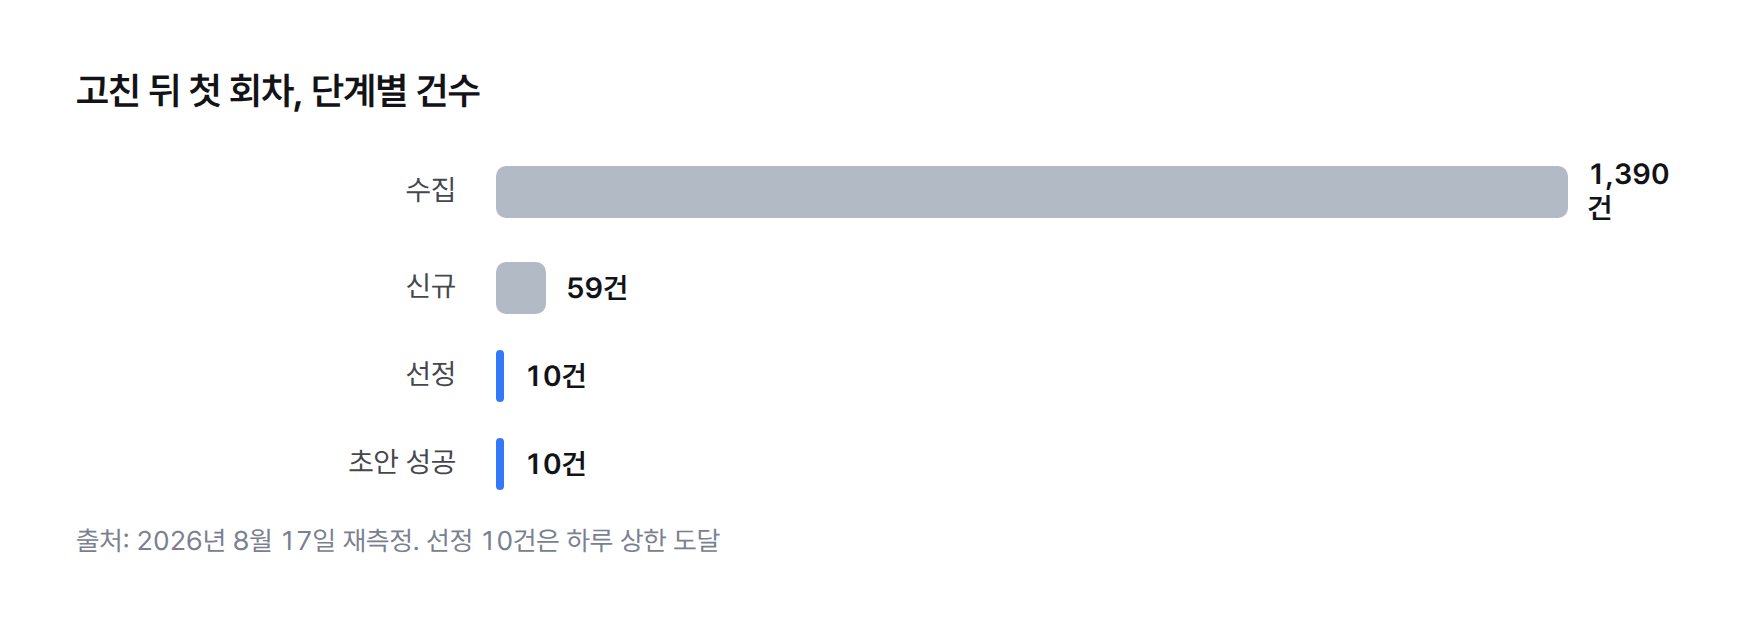
고친 스크립트를 한 회차 돌려 처음부터 끝까지 셌습니다. 수집 1,390건, 이미 본 질문을 뺀 신규 59건, 하루 선정 상한에 닿은 선정 10건, 답변 초안 10건 중 10건 성공입니다. 사람이 검토할 대기 질문 목록은 3건에서 10건으로 늘었고, 쌓인 질문 중 남은 967건은 회차마다 250건씩 소화하도록 넘겼습니다.
숫자를 단계별로 읽어 보겠습니다. 수집 1,390건에서 신규가 59건으로 줄어든 것은 이미 본 질문 목록이 제 역할을 했다는 뜻입니다. 탈락 확정분까지 목록에 적기 시작했기 때문에, 다음 회차부터는 같은 질문의 페이지를 다시 열지 않습니다. 선정이 10건에서 멈춘 것은 질문이 모자라서가 아니라 하루 선정 상한에 닿아서입니다. 상한이 공급보다 먼저 찼다는 것 자체가 이번 수리의 판정 기준이었습니다.
이 숫자가 바로 나온 건 아닙니다. 구현 도중 한 번 더 틀렸습니다. 첫 판은 페이지를 여는 순서를 answerNo가 작은 순으로 정렬했습니다. 답변이 적은 질문부터 보면 답할 자리가 많을 거라고 생각했습니다. 그런데 당시 예산 150건 중 111건이 작성일 상한을 넘겨 버려졌습니다.
이유는 정렬 축에 있었습니다. answerNo가 작은 질문은 sim 쪽 오래된 질문에 많았고, 오래된 질문부터 열면 나이 초과로 떨어질 확률이 높습니다. 신선한 date 축을 먼저 봐야 나이 초과가 적다는 걸 놓쳤습니다. 그래서 date 축 후보를 먼저 열도록 순서를 바꾸고 예산을 150건에서 250건으로 늘렸고, 그 뒤에 위의 숫자가 나왔습니다.
| 항목 | 고치기 전 | 고친 뒤 |
|---|---|---|
| 선정 | 0건 | 10건 (상한 도달) |
| 정렬 | date 단독 | date 20건 + sim 3페이지×30건 |
| 작성일 상한 | 90일 | 365일 |
| 페이지 열기 예산 | 없음 | 250건/회차 |
| 대기 질문 목록 | 3건 | 10건 |
| 회차 실행 시간 | 수 초 | 1분 42초 |
남는 한계는 무엇인가?
대가도 있습니다. 페이지 열기 예산 250건 탓에 회차 실행 시간이 수 초에서 1분 42초로 늘었습니다. sim 3페이지 조회로 API 호출은 회차당 최대 96회쯤 늘었는데, 하루 쿼터 25,000회와 견주면 여유가 큽니다. 시간은 크론이 새벽에 돌기 때문에 감당할 만했습니다.
더 큰 한계는 지속성입니다. 이번 선정 10건은 쌓인 질문 1,414건을 처음 퍼 올린 효과가 섞여 있습니다. 남은 967건을 다 소화한 뒤에도 선정이 유지되는지, 다시 0건으로 돌아가는지는 한 번의 측정으로 알 수 없습니다. 그래서 8월 19일에 다시 재기로 하고, 선정한 10건이 실제 발행까지 살아남는지와 함께 관찰 항목으로 남겼습니다.
발행까지의 거리도 아직 남아 있습니다. 선정 10건과 초안 10건 성공은 파이프라인 앞단의 성공일 뿐입니다. 사람 검토와 발행 단계에서 떨어지면, 이번 수리가 실제 검색 노출로 이어졌다고 말할 수 없습니다.
예산도 영구 해법은 아닙니다. 10월 15일 키워드를 40개로 늘린 뒤에는 수집 1,196건, 신규 78건에 예산 250건을 넘긴 866건이 다음 회차로 넘어갔습니다. 유실은 아니지만, 넘긴 질문 중 신선한 질문이 늦게 처리될 위험은 남습니다. 그날 수동 실행에서는 후보 46건 중 9건을 골랐습니다.
같은 종류의 검색 API로 후보를 모으는 분들이 바로 써 볼 수 있게, 이번에 효과가 있었던 점검 순서를 정리합니다. 전부 이 글에서 실제로 한 일입니다.
- 같은 키워드를 정렬값만 바꿔 상위 10건씩 받고, 관련 질문 수를 손으로 센다. 저희는 이 한 번으로 3/10과 10/10의 차이를 봤습니다.
- 정렬 이름이 아니라 정렬 기준을 확인한다. “최신순”이 질문 작성일인지, 답변 시각인지에 따라 결과의 뜻이 달라집니다.
- 후보가 모자란다는 결론 전에, 다른 정렬에 쌓인 양을 잰다. 저희는 1,414건이 놓여 있었습니다.
- 페이지를 열기 전에 검색 결과 안에서 공짜로 얻는 값(answerNo 같은)을 먼저 필터로 쓴다.
- 예산을 걸었다면 무엇부터 여는지 순서를 정한다. 오래된 축부터 열면 150건 중 111건이 나이 초과로 버려질 수 있습니다.
마지막으로 남기고 싶은 교훈은 정렬값이 데이터의 뜻을 바꾼다는 점입니다. “최신순”이라는 이름을 믿고 무엇의 최신순인지 확인하지 않으면, 매칭이 멀쩡한 API를 고장 난 API로 오해합니다. 비슷한 질문 공급 문제를 다룬 다음 단계 이야기는 지식인 자동 답변, 하루 상한보다 질문 공급원이 먼저였다에 정리했습니다. 검색 API로 후보를 모으는 자동화를 직접 만들다 막혔다면 상담으로 상황을 보내 주셔도 좋습니다.
글쓴이: SGK Studio 엔지니어링. 이 글의 숫자는 2026년 8월 17일 작업 기록과 이어진 결정 기록에서 옮겼습니다.