무엇이 문제였나: 공고는 쌓이는데 어느 일에 지원할지 기준이 없었다
RPA로 외주 공고 수집을 자동화해도 계약이 늘지 않은 이유는 공고 수가 아니라 납품할 시간이었습니다. 저희는 외주 중개 플랫폼의 공개 공고를 하루 2회 모으던 수집기를 2시간 간격으로 바꾸고, 채점 기준도 키워드에서 시간당 실수령액으로 갈아 끼웠습니다. 그런데 정작 바꾼 첫날 새 예약 실행은 한 번도 돌지 않았고, 채점식과 목록 파일 쓰기에서도 결함이 하나씩 나왔습니다.
출발점은 대표의 지시 한 줄이었습니다. 수주할 수 있는 건이 몇 개나 될지 가늠하고, 단가가 높고 실적이 쌓이는 일에 최대한 많이 지원하도록 자동화하라는 주문이었습니다. 당시 수집기는 공고를 모아 판매 중인 서비스와 맞는 키워드가 있으면 높은 등급을 주는 구조였습니다. 키워드만 맞으면 홈페이지류의 작은 공고도, 수백 시간이 드는 시스템 구축 공고도 같은 등급을 받았습니다.
비용은 사람의 시간에서 났습니다. 지원서는 한 번 내면 되돌릴 수 없고, 평점이 곧 상품인 채널이라 아무 공고에나 낼 수도 없습니다. 결국 대표가 카드마다 공고 원문을 다시 열어 읽고 판단해야 했습니다. 수집 주기가 하루 2회라 좋은 공고가 올라와도 반나절 가까이 늦게 보는 일도 있었습니다.
처음 잰 숫자: 적합 공고 월 36건, 기대 계약 월 0.9~2.8건
자동화를 손대기 전에 규모부터 쟀습니다. 측정 방법은 새 크롤링이 아니라, 앞서 두 차례 모아 둔 공고 실측 자료를 다시 계산하는 방식이었습니다. AI·자동화와 시스템 구축에 해당하는 적합 공고만 골라 세고, 공고 금액의 중앙값과 공고당 지원자 수를 함께 봤습니다.
결과는 적합 공고가 공개 외주 기준 월 36건, 금액 중앙값 800만 원, 공고당 지원자 39명이었습니다. 지원자 39명 중 무작위로 뽑힌다고 치면 기대 계약은 월 0.9건이고, 제안서가 평균보다 3배 잘 뽑힌다고 가정해도 월 2.8건이었습니다. 이 범위만 보면 공고를 더 촘촘히 모으고 더 많이 지원하는 쪽이 답처럼 보였습니다.
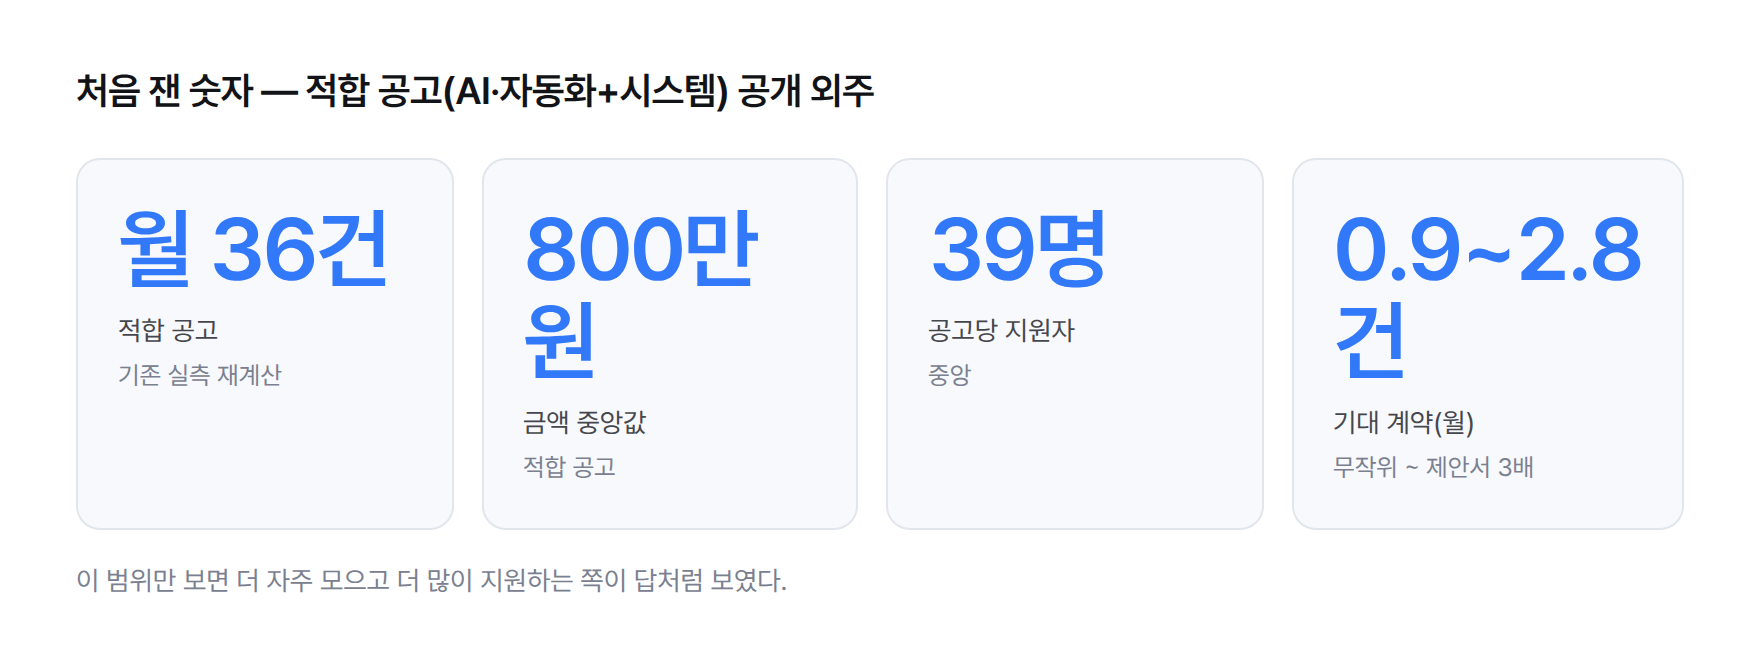
여기에 기준 공고 하나를 붙였습니다. 실제로 견적을 따져 본 공고(158456번)는 1,000만 원짜리 일에 441시간이 드는 건이었습니다. 시간당으로 나누면 발주액이 약 2.3만 원입니다. 이 숫자가 뒤에서 가설을 무너뜨립니다.
세운 가설: 더 자주 모으고, 맞는 공고마다 지원하면 계약이 는다
처음 세운 가설은 단순했습니다. 적합 공고가 월 36건이나 있으니 놓치는 공고를 줄이면 계약이 는다는 생각이었습니다. 그래서 수집 주기를 하루 2회에서 2시간 간격으로 바꾸기로 했습니다. 수집 창은 오전 8시 17분부터 밤 10시 17분까지(한국 시간)로 잡았고, 플랫폼 부담을 생각해 하루 페이지 상한 120은 그대로 뒀습니다.
정각이 아니라 17분에 맞춘 데는 이유가 있습니다. 수집기는 GitHub Actions의 예약 실행(cron)으로 돌았는데, 정각에는 전 세계 예약 작업이 몰려 실행이 밀리는 일이 잦습니다. 그래서 17분 오프셋을 뒀습니다. 두 번째 가설은 지원 건수였습니다. 키워드만 맞으면 전부 지원하는 쪽으로 넓히면 확률상 계약이 따라온다고 봤습니다.
RPA라는 말을 쓰는 이유도 여기 있습니다. 사람이 하던 반복 작업, 즉 공고 목록을 넘기고 상세를 열고 조건을 따지는 일을 프로그램이 대신 돌리는 구조라서입니다. 다만 이 글의 수집기는 화면을 클릭하는 전통적인 RPA 도구가 아니라 Python 스크립트와 예약 실행으로 만든 형태입니다.
가설이 틀린 지점은 어디였나? 막는 것은 수요가 아니라 납품 시간이었다
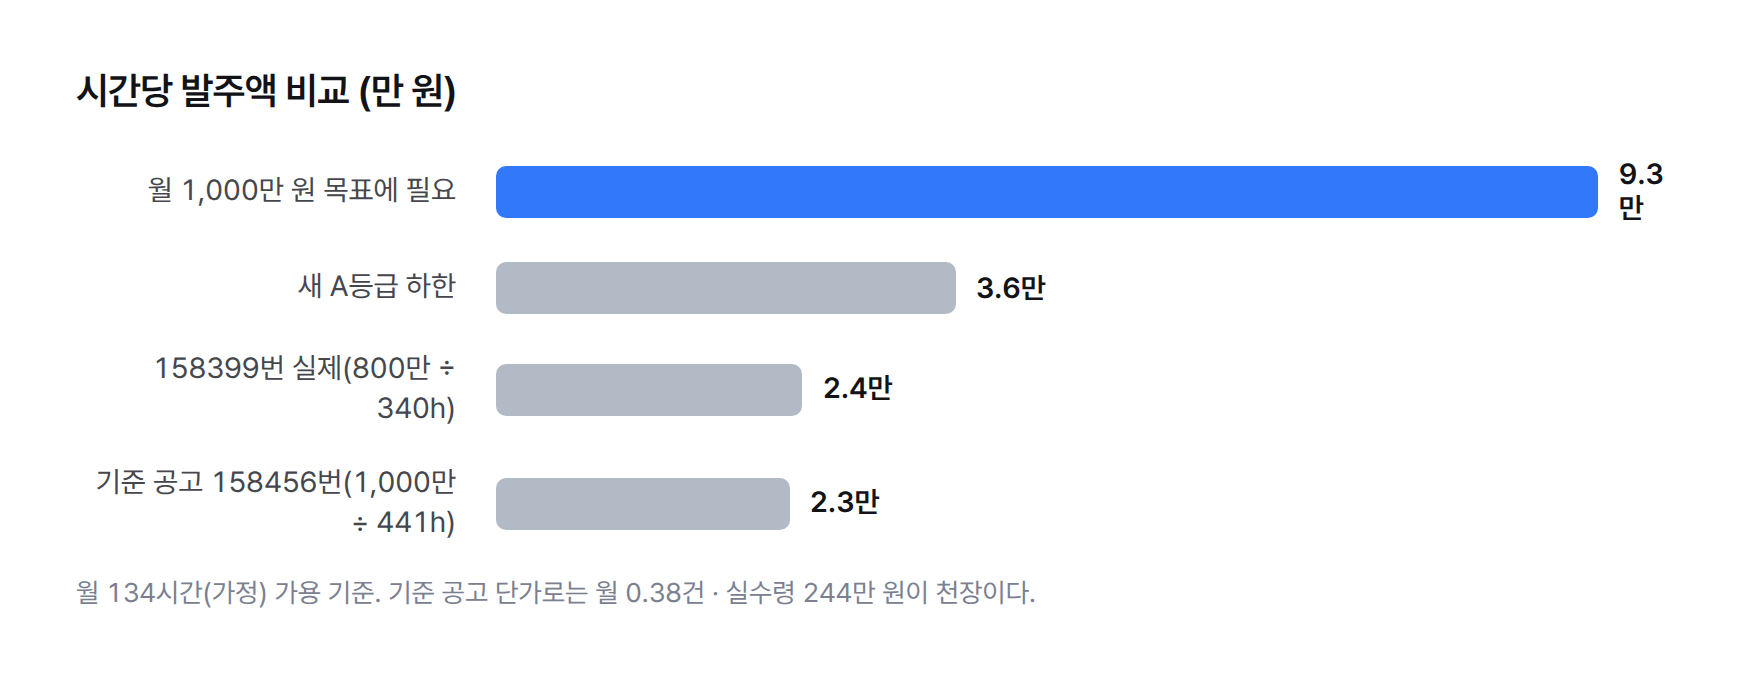
가설은 시간 계산 한 줄에서 무너졌습니다. 대표가 한 달에 납품에 쓸 수 있는 시간을 134시간으로 가정하고 기준 공고의 공수(1,000만 원에 441시간)를 대입하면, 한 달에 소화할 수 있는 일은 0.38건이고 실수령은 244만 원입니다. 공고가 월 36건보다 훨씬 많아져도 이 천장은 그대로입니다.
목표와의 거리도 시간당 단가로 보였습니다. 월 1,000만 원 매출을 134시간 안에 내려면 시간당 발주액 9.3만 원이 필요했는데, 기준 공고는 2.3만 원이었습니다. 더 많이 지원해서 더 많이 따낼수록 시간은 저단가 일에 묶이고, 전체 시간당 수입은 오히려 내려갑니다. 지원 건수를 무제한으로 넓히자는 두 번째 가설은 여기서 기각했습니다.
첫 번째 가설인 수집 주기도 다른 이유로 틀렸습니다. 2시간 간격 예약을 걸고 첫 슬롯이 실제로 도는지 확인하는 판정 시점에, GitHub API로 예약 실행 기록을 조회하니 total_count가 0이었습니다. 9월 15일 18시 30분을 겨냥한 표현식(`30 0,9`)과 9월 16일 8시 17분을 겨냥한 표현식(`17 23,1,3,5,7,9,11,13`), 서로 다른 두 개가 연속으로 한 번도 실행되지 않았습니다. 주기를 줄였다고 믿었지만 실제로는 0회였습니다.
| 가설 | 확인한 수단 | 판정 |
|---|---|---|
| 공고를 더 자주 모으면 계약이 는다 | 예약 실행 기록 조회: total_count 0 | 반증 (실행 자체가 없었다) |
| 키워드만 맞으면 전부 지원한다 | 월 134시간 × 시간당 2.3만 원 계산: 월 0.38건·244만 원 | 기각 |
| 공고 총액으로 등급을 매긴다 | 158399번 재계산: 1,700만 원 공고가 실제 2.4만 원/시간 | 반증 |
| 병목은 납품 시간이다 | 시간당 필요 9.3만 원 vs 기준 2.3만 원 | 확인 |
진짜 원인은 무엇이었나? 기준, 계산식, 예약 실행이 각각 따로 어긋나 있었다
원인은 하나가 아니었습니다. 첫째는 채점 기준입니다. 키워드 매칭은 공고가 우리 서비스와 맞는지는 알려 주지만, 그 일에 시간을 쓸 가치가 있는지는 알려 주지 않습니다. 시간이 유한한 1인 스튜디오에서 등급이 답해야 할 질문은 후자였습니다.
둘째는 시간당 실수령으로 바꾼 뒤에 드러난 계산식 결함입니다. 수집 창을 30건에서 120건으로 넓혀 후보를 채점하다가, 공고 총액이 1,700만 원인 158399번이 A등급으로 올라온 것을 봤습니다. 저희 홈페이지 표준가 상한은 1,000만 원이라 실제로 받을 금액은 800만 원이고, 공수 340시간으로 나누면 시간당 2.4만 원으로 A등급 기준인 3.6만 원에 못 미쳤습니다. 계산식이 받을 돈이 아니라 공고 총액으로 실수령을 셈해서, 상한을 넘는 큰 공고일수록 등급이 부풀었습니다.
같은 날 반대 방향 오류도 나왔습니다. 초안 생성기의 금액 계산이 하한을 강제로 적용해서, 예산 280만 원인 158327번 공고에 350만 원을 제안하고 있었습니다. 지원서 금액 규칙 문서에는 공고 총액을 그대로 쓰라고 적혀 있었는데, 초안 생성기만 다른 값을 쓰고 있던 셈입니다. 하나의 규칙이 두 곳에 따로 적혀 서로 어긋난 전형적인 사례였습니다.
등급이 부푼 공고는 1,700만 원짜리였고, 실제로 받을 수 있는 돈은 800만 원이었다. 계산식은 공고가 내건 돈과 우리가 받을 돈을 구분하지 않았다.
셋째는 예약 실행입니다. 워크플로 상태는 active, Actions 권한은 enabled, 기본 브랜치에 파일도 있었습니다. 설정 문제를 하나씩 배제하고 나니 남는 원인은 표현식이 아니라 GitHub의 예약 기능 자체였습니다. 표현식을 또 고치는 방법은 같은 이유로 다시 멈출 수 있어 택하지 않았습니다.
이 확인에 쓴 방법은 간단했습니다. 워크플로 실행 기록을 예약 실행(`event=schedule`)으로만 걸러 GitHub API로 조회했습니다. 로그를 들여다보거나 메신저 알림이 오기를 기다리는 대신 실행 횟수를 직접 셌기 때문에, 0회라는 사실을 판정 시점에 바로 알 수 있었습니다. 예약을 걸었다는 기록과 실행됐다는 기록은 서로 다른 곳에 남는다는 점을 이때 분명히 확인했습니다.
넷째는 고치는 도중에 터졌습니다. 채점과 초안 작업이 도는 사이 공고 목록 파일이 120건에서 60건으로 줄었습니다. 삭제 코드는 없었습니다. 초안 생성기가 목록 파일을 읽어 사본을 만든 뒤 AI 초안 3건을 쓰는 데 14분을 보냈고, 그 낡은 사본을 통째로 다시 쓰면서 그 사이 다른 수집 작업이 넣은 60건이 사라졌습니다. 흔히 lost update라고 부르는 경쟁 조건입니다.
조치: 시간당 실수령 채점, 로컬 크론 직접 기동, 제출은 사람의 한마디
채점은 시간당 실수령 기준으로 바꿨습니다. A등급은 총액 490만 원 이상이면서 판매 중인 서비스와 맞고, 시간당 실수령이 3.6만 원 이상인 공고입니다. 결제 연동이나 기존 시스템 이관처럼 품이 많이 드는 유형은 시간당 2.3만 원으로 낮게 잡았습니다. 이 단가들은 아직 가정값이라 코드에 상수로 두고, 나중에 실측으로 바꾸게 했습니다.
계산식은 “돈은 제안 금액, 공수는 공고 총액”으로 나눴습니다. 금액 규칙을 함수 하나로 모아 제안서 금액 문구와 등급 채점이 같은 함수를 쓰게 했고, 예산이 “협의”인 공고는 공수를 알 수 없어 등급을 올리지 않게 했습니다. 규칙을 바꿀 때 목록 전체를 다시 채점하는 명령도 만들었는데, 이미 내린 판단 기록과 알림 시각은 건드리지 않습니다.
예약 실행은 GitHub에 맡기지 않기로 했습니다. 로컬 PC의 크론(`47 8-22/2`)이 결과물을 받기 전에 수집 워크플로를 직접 띄우고, 15초 간격으로 최대 40회, 즉 10분까지 완료를 기다립니다. 실패하거나 시간이 넘으면 마지막 성공 결과로 돌아가고, 12시간 동안 수집이 멈추면 울리는 경보는 그대로 둡니다. 나중에 GitHub 예약이 살아나도 동시 실행 묶음과 하루 120페이지 상한이 중복을 막습니다.
목록 파일 쓰기는 “다시 읽고 합치기”로 바꿨습니다. 쓰기 직전에 파일을 새로 읽어 지정한 행의 지정한 필드만 덮는 함수를 만들고, 초안 생성기·알림 발송 후 상태 갱신·판단 기록 세 곳을 이 함수로 옮겼습니다. 파일 잠금으로 순서를 세우는 방법도 검토했지만, 문제는 동시 접근이 아니라 읽고-고치고-통째로 쓰는 구조였기 때문에 병합 쪽이 더 단순했습니다.
기각한 대안도 남겨 둡니다. 예약 실행 쪽에서는 cron 표현식을 다시 조정해 재시도하는 안이 있었지만, 원인이 표현식이 아니라 GitHub 예약 자체라 바꿔도 재발 가능성이 남아 기각했습니다. 반대로 Actions를 버리고 전부 로컬로 옮기는 안은, PC가 꺼져 있을 때도 최소한의 수집 시도가 남아야 해서 기각했습니다. 로컬 기동은 환경변수 하나로 끌 수 있게 두었습니다. 병합 함수는 호출할 때마다 디스크를 다시 읽어 느리지만, 이 함수를 쓰는 세 곳은 원래 AI 호출이나 메신저 발송이 있어 그 비용이 상대적으로 작습니다. 사이트맵 수집 병합은 실행 시간이 1초 미만이고 병합의 정식 작성자라 전체 재작성을 유지했습니다.
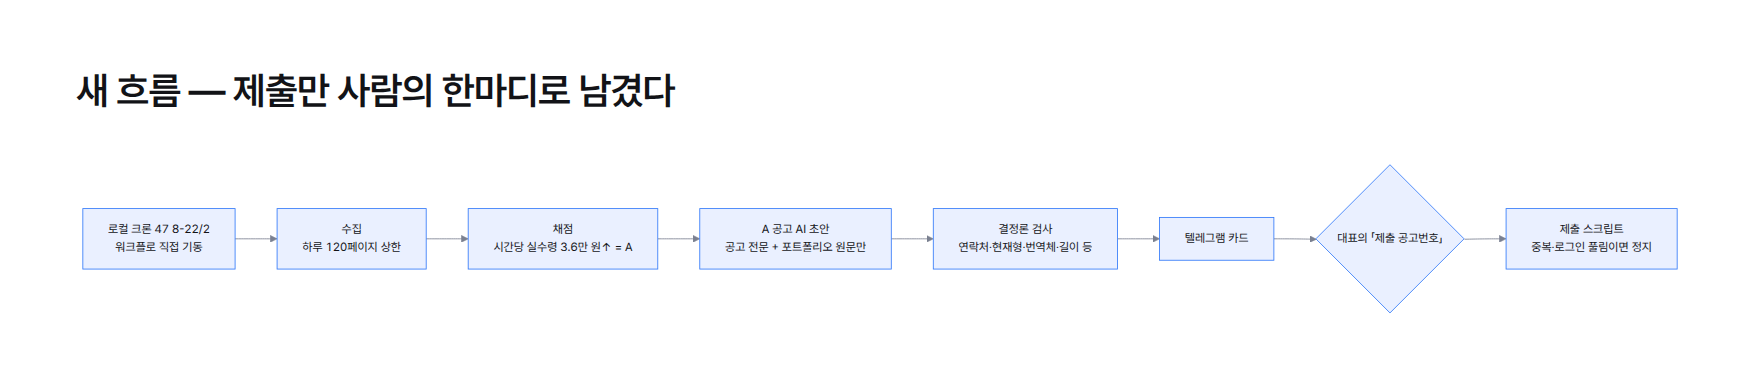
A등급 공고마다 지원서 초안도 자동으로 씁니다. AI는 공개 공고 전문과 포트폴리오 등록 원문만 근거로 초안을 쓰고, 그 뒤에 규칙 기반 검사가 붙습니다. 연락처 노출, 없는 실적을 고백하는 문장, 재직 중 겸업을 드러내는 표현, 직무를 현재형으로 쓴 문장, 공개선을 넘는 정보, 번역체, 길이를 같은 입력에 늘 같은 판정을 내는 방식으로 거릅니다. 통과한 초안만 메신저 카드로 갑니다.
제출만은 자동으로 하지 않았습니다. 대표가 메신저에 “제출 <공고번호>” 한마디를 보내야 제출 스크립트가 검사를 통과한 초안을 채워 넣고, 이미 지원한 공고이거나 로그인이 풀려 있으면 멈춥니다. 이 한마디는 AI를 거치지 않고 코드가 먼저 가로챕니다. 매크로프로그램으로 완전 자동 제출하는 안은 기각했습니다. 플랫폼 약관이 직거래와 크롤링을 금지하는 조항을 두고 있고, 제출은 한 번 하면 되돌릴 수 없어 잘못 쓴 초안이 그대로 나가며, 평점이 곧 상품인 채널에서는 사고 1건이 치명적이기 때문입니다.
재측정 결과: 예약 0회에서 실제 슬롯 성공으로, 등급 18건 재조정
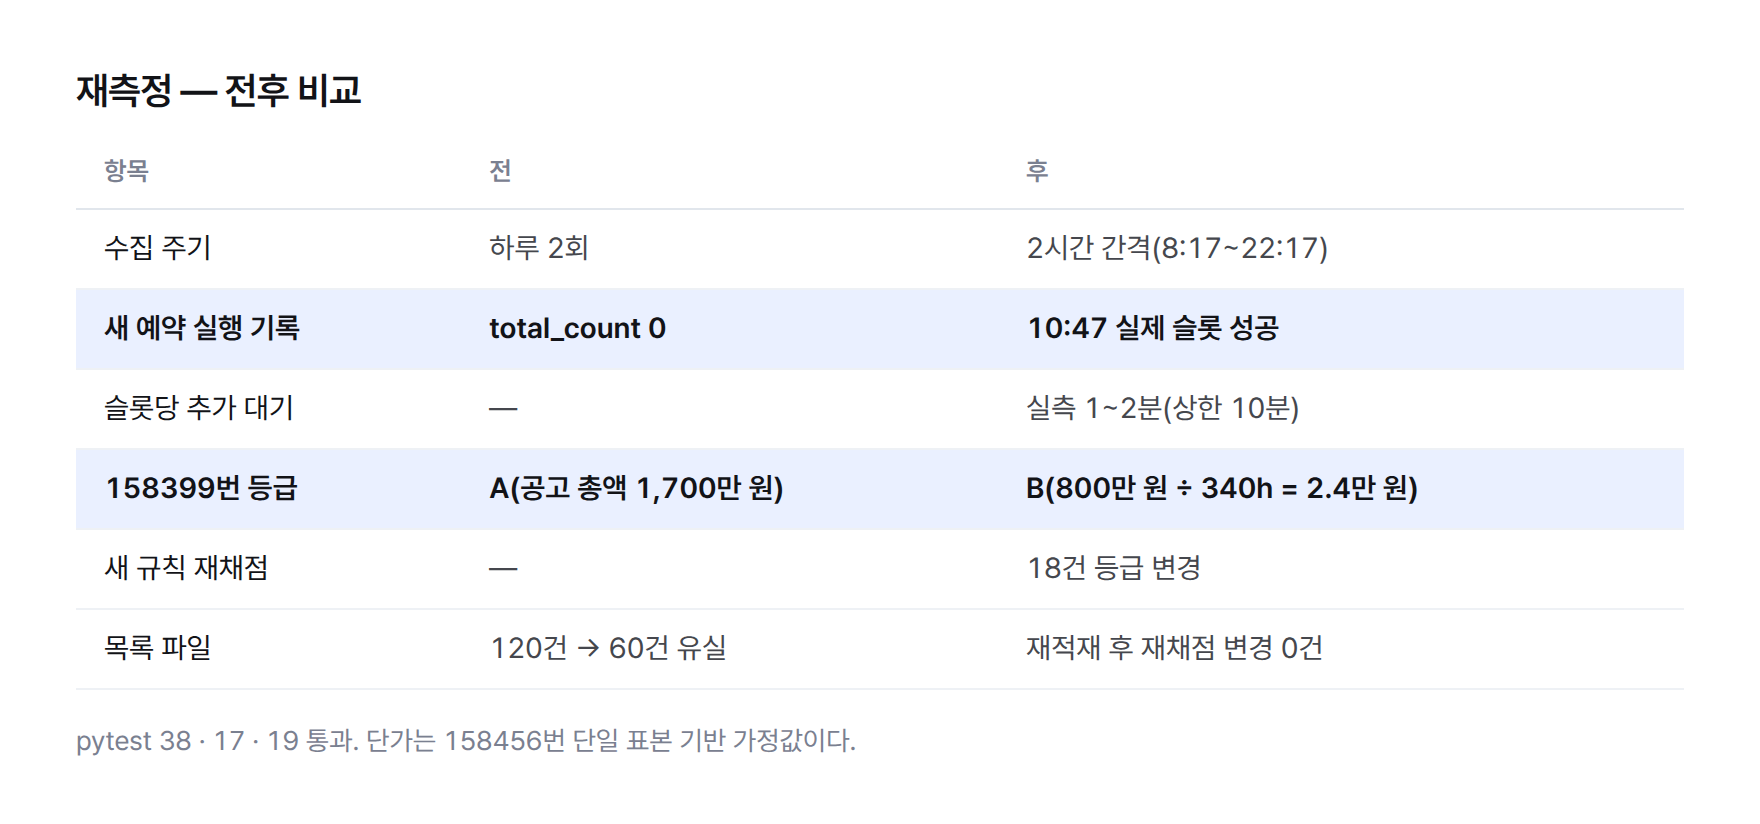
수집 주기는 실행 기록으로 다시 쟀습니다. 새로 넣은 기동 블록만 따로 돌린 실행이 completed로 끝났고, 고친 스크립트 전 구간을 9시 49분에 돌린 실행에서는 수집·알림·자동 초안 단계가 전부 정상 종료 코드(exit 0)를 냈습니다. 결정적인 확인은 사람이 손대지 않은 10시 47분 실제 크론 슬롯이었고, 이 슬롯도 같은 경로로 성공했습니다. 예약 실행 0회에서 2시간 간격 실제 실행으로 넘어간 셈입니다.
추가된 대기 시간도 쟀습니다. 슬롯마다 워크플로를 띄우고 최대 10분을 기다리는 구조라 걱정했지만, 실측 대기는 1~2분으로 짧았습니다. 정각 대신 47분에 로컬 크론을 두고, 워크플로 쪽은 17분 오프셋을 유지했습니다.
채점 쪽은 목록 전체를 새 규칙으로 다시 채점해 확인했습니다. 등급이 바뀐 공고는 18건이었고, 대표 사례가 앞에서 본 158399번(A에서 B로)입니다. 사라졌던 60건은 백필 수집 창에 남아 있던 120건을 다시 적재해 복구했고, 복구 직후 다시 채점했을 때 바뀐 등급은 0건이었습니다. 데이터가 원래대로 돌아왔다는 무결성 확인으로 썼습니다.
| 항목 | 전 | 후 |
|---|---|---|
| 수집 주기 | 하루 2회 | 2시간 간격 (8시 17분~22시 17분) |
| 새 예약 실행 기록 | total_count 0 | 10시 47분 실제 슬롯 성공 |
| 슬롯당 추가 대기 | - | 실측 1~2분 (상한 10분) |
| 158399번 등급 | A (공고 총액 1,700만 원 기준) | B (실수령 800만 원 ÷ 340시간 = 2.4만 원) |
| 새 규칙 재채점 | - | 18건 등급 변경 |
| 목록 파일 | 120건 → 60건 유실 | 재적재 후 재채점 변경 0건 |
테스트도 함께 늘렸습니다. 시간당 실수령 채점과 자동 초안을 넣은 첫 묶음은 pytest 38개가 통과했고, 금액 규칙 단일화는 신규 4개를 포함해 17개, 목록 파일 병합은 신규 2개를 포함해 19개가 통과했습니다. 기존 등급 테스트 하나가 “협의” 공고의 등급이 오르는 부작용을 잡아내 되돌린 일도 있었습니다.
자동 초안은 실제 공고 158456번으로 끝까지 돌려 봤습니다. 포트폴리오 원문을 근거로 넣기 전 1회차 초안에는 “직무로 운영하고 있습니다”처럼 끝난 일을 현재형으로 쓴 오류가 있었고, 이 유형을 잡는 검사를 추가했습니다. 제출 스크립트는 이미 지원한 공고에서 중복 제출을 막는 것까지 확인했습니다.
남는 한계: 시간당 단가는 아직 표본 1건 위의 가정이다
가장 큰 한계는 채점의 뿌리입니다. A등급을 가르는 시간당 단가는 기준 공고 158456번 한 건에서 나온 추정이라, 서비스 종류별 오차가 클 수밖에 없습니다. 첫 계약 2건의 실투입 시간과 실제 받은 돈을 재기 전까지는 등급 판정 전체가 추정값 위에 서 있습니다. 그래서 지원, 미팅, 계약, 실투입 시간을 단계별로 적는 목록 파일을 따로 두고, 실측이 쌓이면 가정 상수를 바꾸기로 했습니다.
월 134시간이라는 가용 시간도 가정입니다. 이 숫자가 맞는지, 납품 인력을 늘릴지는 대표가 판단할 몫으로 남겨 뒀습니다. 이 숫자가 바뀌면 월 0.38건이라는 천장도 같이 움직입니다.
운영상의 한계도 있습니다. 다시 채점하면 이미 대표에게 보낸 메신저 카드와 목록 파일의 등급이 어긋날 수 있는데, 카드를 다시 보내지 않고 다음 조회부터 새 등급을 보여 줍니다. 로컬 크론은 PC가 켜져 있어야 돌기 때문에 GitHub 쪽 워크플로를 아예 없애지는 않았습니다. 9월 15일 23:07 수동 수집은 8페이지째에서 오류 코드 없는 차단 신호로 멈췄고, 지금은 차단 상세를 기록만 하는 단계입니다. 이후 채점이 공고 발췌 600자 대신 상세 설명 전문을 읽도록 고친 것도 같은 맥락의 후속 작업이었습니다.
이 개선에서 무엇을 남겼나?
- 공고 수를 늘리기 전에 시간 천장부터 계산한다. 월 134시간 × 시간당 2.3만 원이면 공고가 아무리 많아도 월 0.38건이다
- 등급은 “맞는 일인가”가 아니라 “시간을 쓸 가치가 있는가”를 답해야 한다
- 공고가 내건 돈과 우리가 받을 돈을 분리한다. 1,700만 원 공고가 실제로는 800만 원이었다
- 예약을 걸었다는 사실과 실행됐다는 사실은 다르다. 실행 기록 total_count 0을 직접 조회해서야 알았다
- 읽고-고치고-통째로 쓰는 파일은 오래 걸리는 작업과 만나면 데이터를 잃는다. 14분 사이에 60건이 사라졌다
- 되돌릴 수 없는 제출은 사람의 한마디로 남기고, 그 앞단을 최대한 자동화한다
같은 원문에서 채점 기준 전환 자체를 더 자세히 다룬 글은 AI업무자동화 외주 공고 채점, 키워드 대신 시간당 수령액으로에 있습니다. 반복 업무를 RPA나 스크립트로 바꾸려는데 어디서 시간이 새는지부터 재고 싶다면 상담으로 문의해 주세요.