무엇이 문제였나 — 백그라운드 인덱서가 돌 때마다 작업 창이 멈칫거렸다
systemd CPUQuota는 이 문제의 답이 아니었습니다. 리눅스에서 백그라운드 작업이 사람이 쓰는 화면을 방해할 때 가장 먼저 떠오르는 수가 서비스에 CPU 상한을 거는 방법인데, 저희 경우에는 상한이 증상을 줄이지 못했고 오히려 작업 시간을 두 배로 늘렸습니다. 그 과정을 순서대로 적습니다.
문제의 서비스는 검색 인덱서였습니다. 대화 기록과 문서를 청크(짧은 조각) 단위로 잘라 임베딩하고, 결과를 로컬 데이터베이스에 넣습니다. 타이머가 이 작업을 주기적으로 깨우는데, 한 번 깨어날 때마다 CPU를 11~16분어치 썼고 순간 사용률은 505%까지 올라갔습니다. systemd 표기로 100%가 코어 하나이니, 코어 다섯 개 이상을 한꺼번에 채운 순간이 있었다는 뜻입니다. 이 서비스에는 자원 제한이 하나도 없었습니다.
대표는 이 시간대마다 작업 창이 버벅인다고 느꼈습니다. 인덱싱은 몇 분 늦어도 아무도 모르지만, 사람이 타이핑하는 창이 멈추면 그 자리에서 일이 끊깁니다. 판단 기준을 처음부터 이렇게 잡았습니다. 인덱싱은 느려도 되고, 작업 창이 멈추는 쪽이 훨씬 비쌉니다.
같은 아침에 두 번째 증상이 겹쳤습니다. 대화 기록을 인덱서 데이터베이스로 옮기는 동기화 작업이 08:27부터 09:19까지 `database is locked` 오류로 연달아 실패했습니다. 이 오류는 처음이 아니었습니다. 2026년 7월 3일에 잠금 대기 시간(busy_timeout)을 10초에서 60초로 늘려 한 차례 잠재운 적이 있었는데, 두 달 뒤 같은 오류가 다시 올라왔습니다.
- 증상 1 — 인덱서가 도는 동안 대표의 작업 창이 버벅임
- 증상 2 — 대화 기록 동기화가 08:27~09:19 사이 `database is locked`로 연속 실패
- 공통점 — 둘 다 같은 인덱서 서비스가 도는 시간에 몰려 있음
처음 잰 숫자 — 무엇을 어떤 도구로 쟀나
감으로 상한부터 걸지 않으려고 먼저 세 가지를 쟀습니다. 첫째, systemd가 서비스마다 쌓는 CPU 누적 시간으로 인덱서가 한 번 실행에 CPU를 얼마나 쓰는지 봤습니다. 둘째, 순간 CPU 사용률로 최고점을 잡았습니다. 셋째, 커널이 제공하는 PSI(Pressure Stall Information)를 봤습니다. PSI는 작업이 CPU·메모리·I/O를 기다리느라 멈춰 있던 시간의 비율이라, 실제로 무엇이 막혔는지를 직접 보여 줍니다.
버벅임이 포착된 순간의 PSI는 `io=15.8% / cpu=0%`였습니다. CPU를 기다린 시간은 없었고, 디스크 입출력을 기다린 시간이 15.8%였습니다. 인덱서는 10~13분마다 깨어나 CPU를 11~16분 썼으니, 한 번 실행이 다음 실행 간격과 거의 맞닿아 있었습니다.
같은 날 제한이 없는 서비스를 전부 훑는 감사도 함께 돌렸습니다. 제한이 없는 활성 서비스 5개는 46시간 동안 CPU를 0.4분 이하로 썼습니다. 제한이 없다는 사실만으로는 문제가 아니라는 신호였고, 이 결과는 뒤에서 다시 씁니다. 반대로 cron 서비스는 평균 CPU가 33.9%로 높았습니다.
사용률과 PSI는 서로 다른 질문에 답합니다. 사용률은 인덱서가 얼마나 쓰는지를, PSI는 그 때문에 누가 기다렸는지를 보여 줍니다. 505%라는 숫자만 보면 인덱서가 PC를 점령한 것처럼 보이지만, 그 시간에 다른 작업이 CPU를 기다리지 않았다면 인덱서는 남는 코어를 썼을 뿐입니다. 조치 전에 이 차이를 제대로 읽었다면 CPU 상한은 처음부터 후보에서 빠졌을 겁니다.
| 항목 | 값 | 측정 방법 |
|---|---|---|
| 인덱서 실행 간격 | 10~13분 | systemd 타이머 실행 기록 |
| 실행당 CPU 사용 | 11~16분 | 서비스별 CPU 누적 시간 |
| 순간 CPU 최고점 | 505% | 순간 사용률(100% = 코어 1개) |
| 버벅임 순간 PSI | io 15.8% · cpu 0% | 커널 압박 지표 |
| 제한 없는 활성 서비스 | 5개 · 46시간 CPU 0.4분 이하 | 전수 감사 |
| cron 서비스 평균 CPU | 33.9% | 전수 감사 |
PSI의 cpu 0%가 이미 답을 가리키고 있었지만, 이 시점에는 그 숫자를 끝까지 따르지 않았습니다.
어떤 가설을 세웠나? — 총량, 디스크, 우선순위
가설은 세 가지였고, 각각에 systemd 설정 하나씩을 대응시켰습니다. 설정은 서비스 파일을 직접 고치지 않고 덮어쓰기 파일(drop-in)로 붙였습니다. 되돌리기 쉽기 때문입니다.
- 가설 A — 인덱서가 CPU 총량을 독점해서 작업 창이 밀린다 → `CPUQuota=250%`로 코어 2.5개어치 상한
- 가설 B — 인덱서의 디스크 입출력이 작업 창의 입출력을 밀어낸다 → `IOSchedulingClass=idle`로 입출력 우선순위를 최하로
- 가설 C — 총량보다 순서가 문제다. 둘이 동시에 CPU를 원할 때 인덱서가 양보해야 한다 → `Nice=15`로 스케줄링 우선순위 하향
당시 기록에도 총량보다 우선순위가 본질이라고 적어 두었습니다. PSI가 cpu 0%였기 때문입니다. 그런데도 상한을 함께 걸었습니다. 셋 다 되돌리기 쉽고, 하나쯤 헛돌아도 손해가 없다고 봤습니다. 이 판단이 틀린 지점이었습니다. 헛도는 설정은 손해가 없는 게 아니라 부작용을 낳을 수 있었습니다.
잠금 오류에 대해서는 새 가설을 세우지 않았습니다. 7월에 대기 시간을 60초로 늘려 둔 상태였으니, 이번에도 경합이 길어졌을 뿐이라고 가볍게 넘겼습니다. 이 가설 역시 틀렸고, 원인은 조치 후 검증 과정에서 따로 드러났습니다.
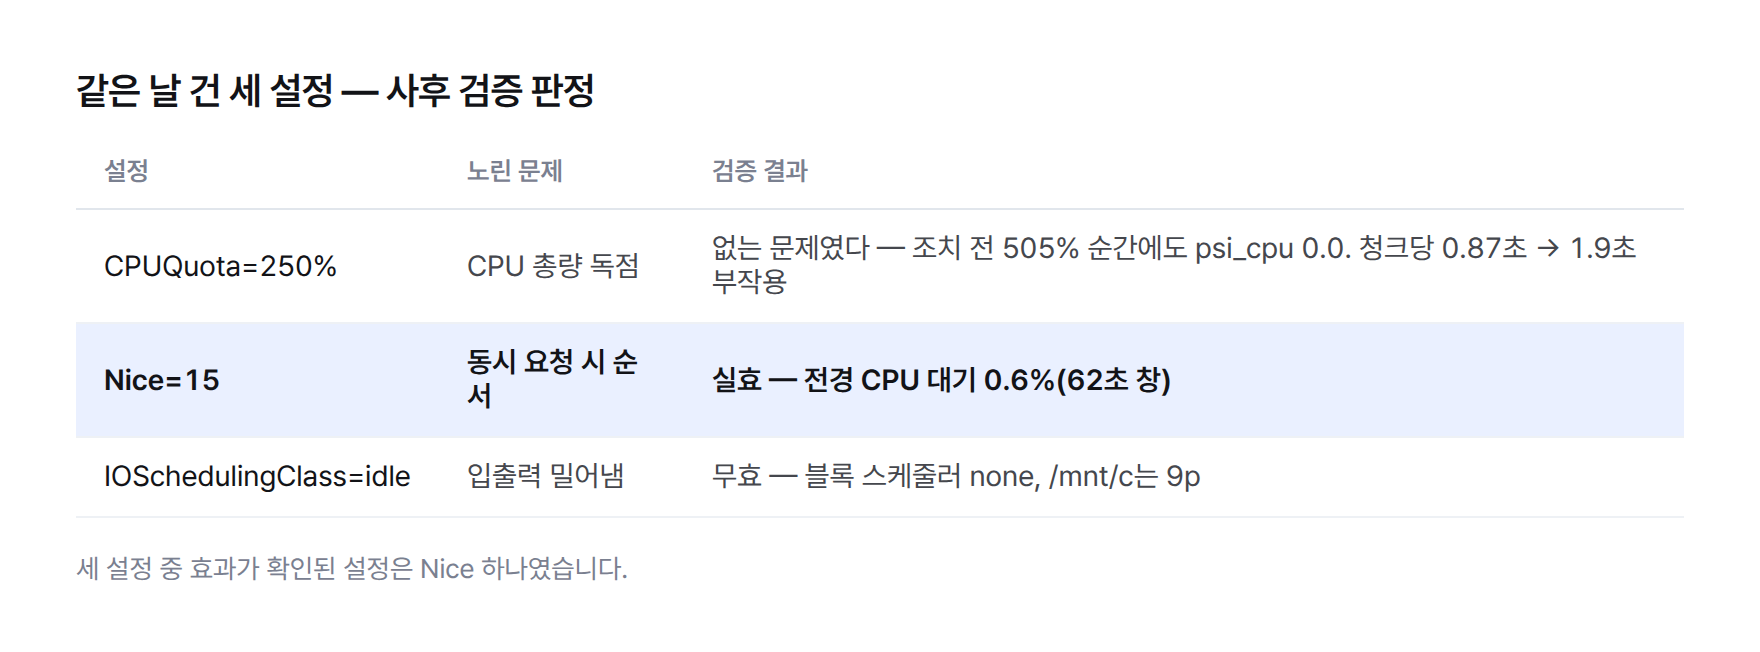
가설은 어디서 틀렸나? — 사후 검증에서 실효는 Nice 하나
조치 뒤 같은 방식으로 다시 쟀습니다. 인덱서가 임베딩을 도는 62초 구간을 잡아, 대표가 쓰는 전경 작업 쪽 cgroup의 PSI를 봤습니다. CPU 대기는 0.6%, I/O 대기는 3.6%였습니다. 작업 창 입장에서는 기다림이 거의 사라진 셈입니다. 문제는 이 개선을 세 설정 중 무엇이 만들었는가였습니다.
가설 A부터 무너졌습니다. 조치 전 인덱서가 CPU를 505%까지 쓰던 순간에도 CPU 압박 지표 psi_cpu는 0.0이었습니다. 다른 작업이 CPU를 기다린 적이 없었으니, CPUQuota는 애초에 존재하지 않는 문제를 잡은 설정이었습니다. 코어가 남아 있는 상황에서 인덱서가 여러 코어를 쓰는 일 자체는 누구도 방해하지 않았습니다.
가설 B는 더 단순하게 무효였습니다. `IOSchedulingClass=idle`은 블록 장치의 입출력 스케줄러가 우선순위를 읽어 줄 때만 작동합니다. 확인해 보니 이 WSL의 블록 스케줄러는 전부 `none`이었고, 인덱서가 읽는 `/mnt/c` 경로는 디스크가 아니라 윈도우 파일을 네트워크 프로토콜로 붙인 9p 파일 시스템이었습니다. 우선순위를 읽을 주체가 없으니 설정은 아무 일도 하지 않았습니다.
남은 설정이 가설 C의 Nice였습니다. Nice는 상한이 아닙니다. 경쟁자가 없으면 인덱서가 CPU를 그대로 다 쓰고, 작업 창이 CPU를 원하는 순간에만 순서를 양보합니다. 전경 CPU 대기 0.6%라는 결과는 이 성질과 맞아떨어집니다.
CPU 상한을 걸면 오히려 더 오래 버벅이지 않나.
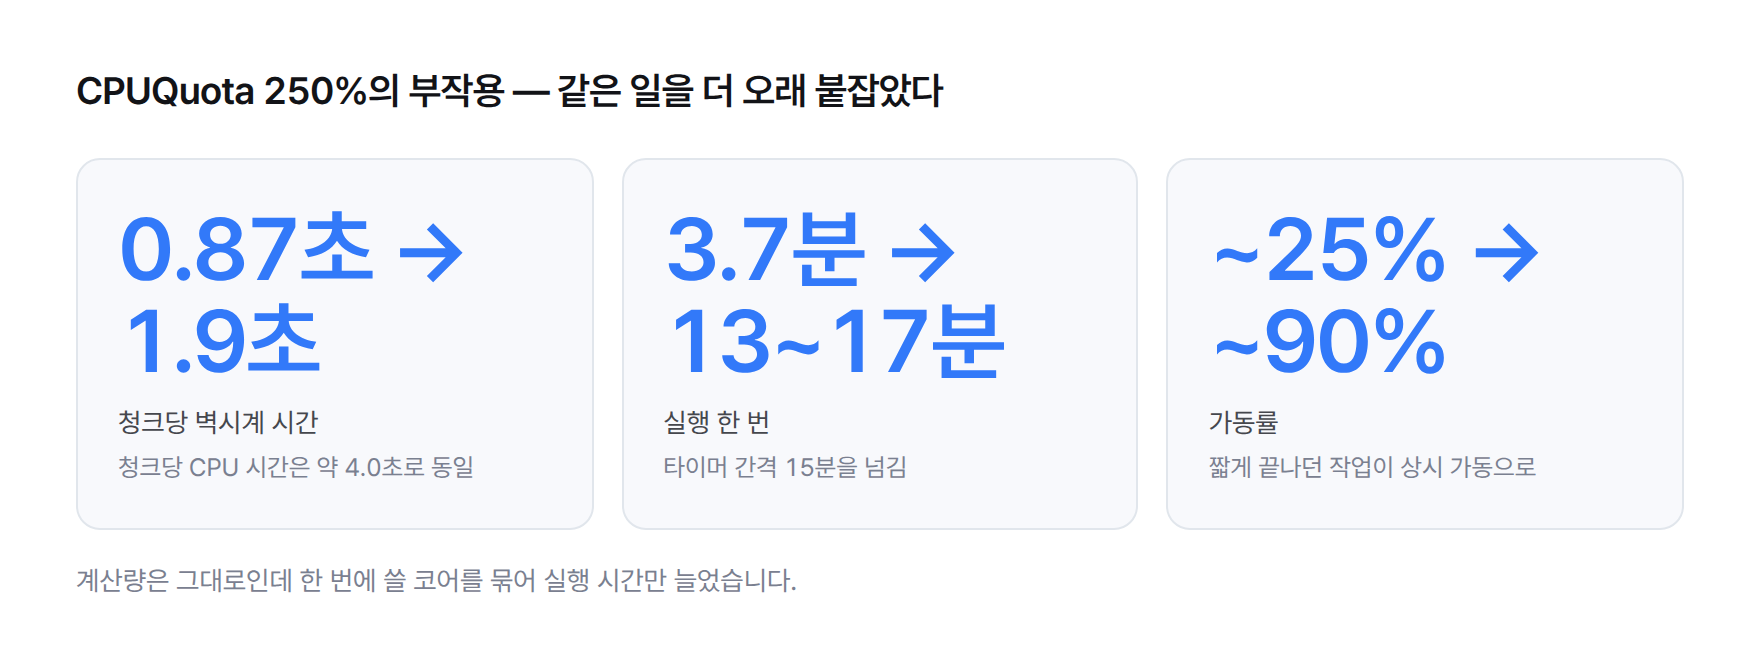
이 직감이 정확했습니다. 부작용을 실측으로 확인했습니다. 청크 하나를 처리하는 데 드는 CPU 시간은 조치 전후 모두 약 4.0초로 같았습니다. 그런데 벽시계 시간은 청크당 0.87초에서 1.9초로 2배가 됐습니다. 해야 할 계산량은 그대로인데 한 번에 쓸 수 있는 코어를 묶었으니, 같은 일을 더 오래 붙잡고 있게 된 셈입니다.
실행 한 번에 걸리는 시간은 3.7분에서 13~17분으로 늘었습니다. 인덱서를 깨우는 타이머 간격이 15분이라, 실행 시간이 간격을 넘기는 순간부터 인덱서는 쉬는 틈 없이 계속 돌았습니다. 가동률은 약 25%에서 약 90%로 올라갔습니다. 짧게 몰아서 끝나던 작업이 하루 종일 깔리는 작업으로 바뀐 셈입니다.
진짜 원인은 무엇이었나? — 우선순위와 트랜잭션 범위
버벅임의 원인은 CPU가 모자라서가 아니라 순서였습니다. 작업 창과 인덱서가 동시에 CPU를 원하는 짧은 순간에 인덱서가 먼저 자리를 차지하던 게 문제였고, Nice 하나로 그 순서를 바꾸자 전경 대기가 사라졌습니다. 총량 상한은 이 순서 문제를 건드리지 못하고 실행 시간만 늘렸습니다.
잠금 오류의 원인은 전혀 다른 곳에 있었습니다. 인덱서의 적재 함수 `ingest.py`의 `ingest_path`는 쓰기 트랜잭션을 연 뒤 대상 파일 전부를 임베딩하는 동안 그 트랜잭션을 쥐고 있었습니다. 임베딩이 끝나야 커밋하는 구조라, 인덱서가 도는 내내 데이터베이스 쓰기 잠금이 풀리지 않았습니다. 그사이 동기화 작업이 쓰려고 하면 대기 시간을 다 쓰고 `database is locked`로 끝납니다.
이 구조에서는 7월의 대기 시간 연장이 증상 치료였을 뿐입니다. 10초를 60초로 늘리면 잠금이 60초 안에 풀리는 경우만 구제되고, 임베딩이 몇 분씩 걸리면 여전히 실패합니다. 그리고 CPU 상한이 임베딩을 청크당 2배 느리게 만들면, 잠금을 쥐는 시간도 같은 비율로 늘어나는 구조였습니다. 두 증상이 같은 시간대에 몰렸던 이유가 여기 있었습니다.
시간 순서로 놓으면 사슬이 보입니다. 인덱서가 깨어나 쓰기 트랜잭션을 엽니다. 상한 때문에 임베딩이 느려지고, 실행이 13~17분으로 늘어납니다. 그 내내 잠금이 풀리지 않습니다. 실행이 타이머 간격 15분을 넘기면 인덱서는 거의 쉬지 않고 돌고, 동기화 작업이 끼어들 빈틈이 사라집니다. 버벅임을 줄이려고 건 상한이 잠금 오류를 키우는 쪽으로 작동한 셈입니다.
| 증상 | 첫 가설 | 실제 원인 |
|---|---|---|
| 작업 창 버벅임 | 인덱서가 CPU 총량을 독점 | 동시 요청 순간의 스케줄링 순서 |
| 작업 창 버벅임 | 인덱서 디스크 입출력이 밀어냄 | 9p 경로·스케줄러 none이라 설정 무효 |
| database is locked | 경합이 길어져 대기 시간 부족 | 전 파일 임베딩 내내 쥐는 쓰기 트랜잭션 |
세 가설 중 살아남은 건 우선순위 가설 하나였습니다.
어떻게 고쳤나 — 상한 제거, 조건부 GPU, 문서 단위 커밋
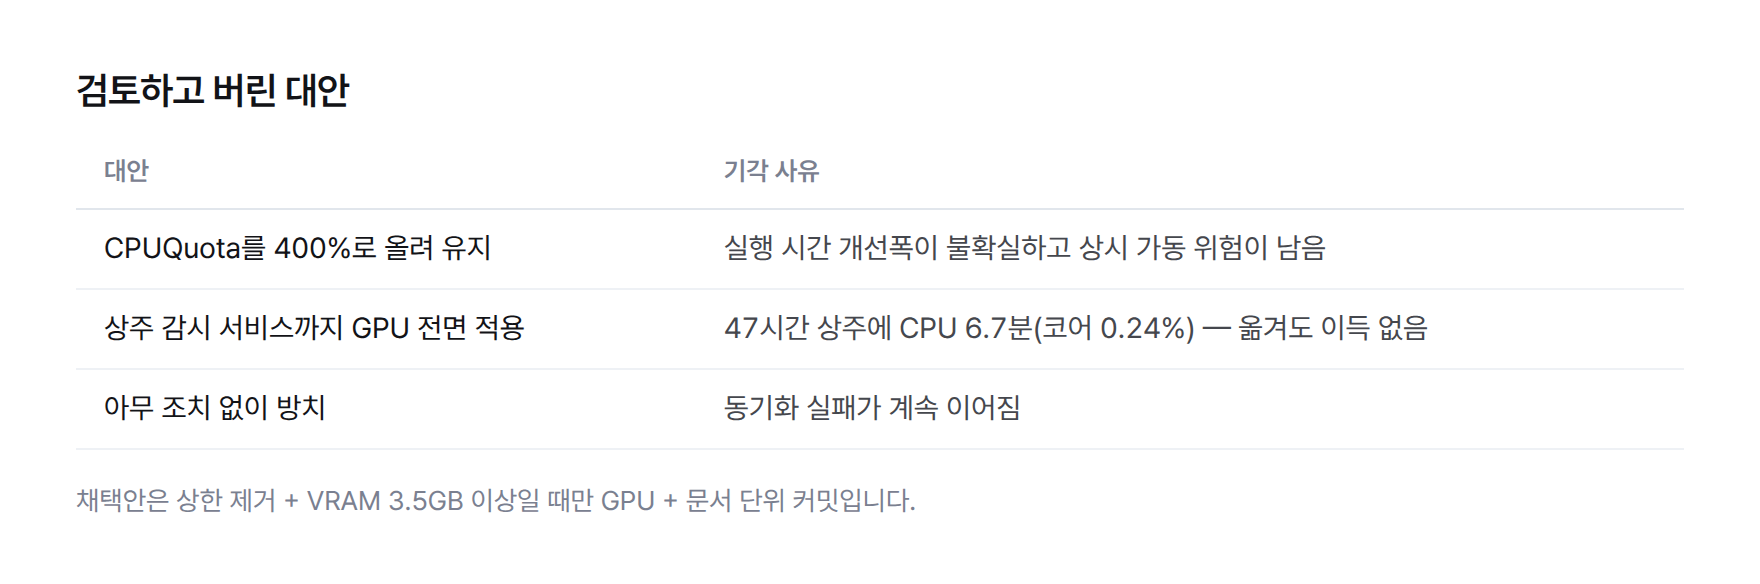
조치를 정하기 전에 대안 세 가지를 따져 봤습니다. 첫째는 상한을 400% 정도로 올려 유지하는 방안이었는데, 실행 시간이 얼마나 줄지 불확실하고 타이머 간격을 넘겨 상시 가동할 위험이 그대로 남아 기각했습니다. 둘째는 파일 변화를 감시하는 상주 서비스까지 전부 GPU로 옮기는 방안이었습니다. 그 서비스는 47시간 상주하는 동안 CPU를 6.7분, 코어 기준 0.24%만 써서 GPU로 옮겨도 얻을 게 없었습니다. 셋째는 아무것도 하지 않는 방안이었는데, 동기화 실패가 계속 이어지므로 기각했습니다.
- systemd 덮어쓰기 파일 2개에서 `CPUQuota`를 지웠습니다. 기록에 남은 제거 대상은 이 설정 하나입니다
- 대화 기록 동기화 작업에 `flock`을 붙여, 이전 실행이 끝나기 전에 다음 실행이 겹쳐 뜨지 않게 했습니다
- 임베딩 장치 선택 함수 `embed._pick_device()`를 추가해, 여유 VRAM이 3.5GB 이상일 때만 GPU를 쓰고 아니면 CPU로 돌게 했습니다
- `ingest.py`가 문서 하나를 끝낼 때마다 커밋하도록 바꿔, 쓰기 잠금을 쥐는 시간을 문서 하나 분량으로 줄였습니다
- 테스트는 pytest 전체를 돌려 exit 0을 확인했습니다
GPU 전환을 조건부로 만든 이유는 같은 PC에서 대표가 이미지 생성 작업도 GPU로 돌리기 때문입니다. VRAM이 넉넉할 때만 인덱서가 GPU를 빌리고, 모자라면 조용히 CPU로 내려옵니다. 되돌리는 방법도 한 줄로 남겼습니다. 서비스 환경 변수에 `KIMKY_MEMORY_DEVICE=cpu`를 넣으면 GPU를 아예 쓰지 않습니다.
문서 단위 커밋이 이번 조치의 핵심이었습니다. 대기 시간을 더 늘리는 방식은 잠금이 길어질수록 계속 쫓아가야 하지만, 잠금을 짧게 쥐도록 구조를 바꾸면 임베딩 속도와 무관하게 동기화가 끼어들 틈이 생깁니다. GPU 전환은 속도를, 문서 단위 커밋은 잠금 시간을 각각 맡았습니다.
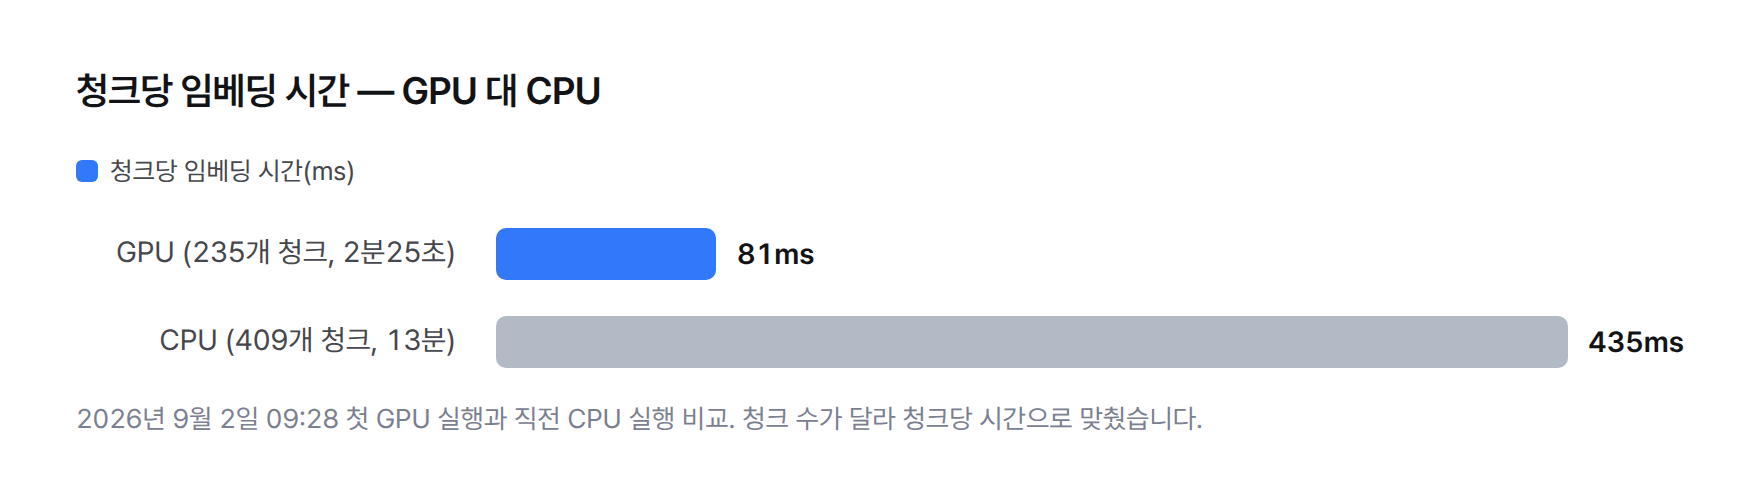
다시 재 보니 — 청크당 81ms 대 435ms
조치 뒤 첫 GPU 실행이 09:28에 돌았습니다. 청크 235개를 2분25초에 끝냈습니다. 바로 앞의 CPU 실행은 청크 409개에 13분이 걸렸습니다. 두 실행은 처리한 청크 수가 달라 총 시간을 그대로 비교할 수 없어서, 청크당 임베딩 시간으로 맞춰 봤습니다. GPU는 청크당 81ms, CPU는 청크당 435ms였습니다.
잠금 오류도 같은 아침에 멈췄습니다. 대화 기록 동기화는 09:35부터 성공으로 돌아섰고, 인덱서 서비스 유닛의 실패 횟수는 0이었습니다. 08:27부터 이어지던 연속 실패가 조치 직후에 끊긴 셈입니다.
| 지표 | 조치 전(상한 적용 중) | 조치 후 |
|---|---|---|
| 청크당 처리 | 벽시계 1.9초 | GPU 81ms |
| 실행 한 번 | 13~17분(CPU 409개 청크 13분) | 2분25초(235개 청크) |
| 동기화 작업 | 08:27~09:19 연속 실패 | 09:35부터 성공 |
| 인덱서 유닛 실패 | 연속 발생 | 0회 |
청크 수가 다른 두 실행이라 총 시간보다 청크당 시간을 기준으로 봅니다.
여기서 숫자 하나를 정직하게 짚어 둡니다. 상한이 걸린 동안 잰 청크당 1.9초는 벽시계 시간이고, 재측정에서 쓴 435ms와 81ms는 청크당 임베딩 시간입니다. 측정 기준이 달라 두 숫자를 한 줄로 이어 개선율을 계산하지 않았습니다. 같은 기준으로 비교할 수 있는 쌍은 GPU 81ms 대 CPU 435ms, 그리고 상한 전후 벽시계 0.87초 대 1.9초 두 쌍뿐입니다.
남는 한계 — GPU 경합과 한 번뿐인 측정
첫째, GPU를 쓰는 동안의 자원 경합이 남았습니다. 동기화 작업은 GPU 실행 중 VRAM 2.5GB를 수십 초 동안 쥡니다. 전체 시간으로 치면 약 5%이지만, 그 순간 대표가 이미지 생성을 돌리고 있으면 두 작업이 VRAM을 두고 부딪힐 수 있습니다. 3.5GB 조건은 이 충돌을 줄이려는 장치일 뿐 없애지는 못합니다. 그래서 다음 날인 2026년 9월 3일을 기한으로 관찰 항목에 올려 두었습니다.
둘째, GPU 재측정은 이 기록 안에서 한 번뿐입니다. 09:28 실행 한 번의 청크당 81ms가 여러 날 평균으로도 유지되는지는 이 글의 근거 자료로는 확인할 수 없습니다. 개선기에서 한 번 재고 끝내는 것은 피해야 할 방식이라, 이 부분은 미확인으로 남겨 둡니다.
셋째, 입출력 우선순위를 조절할 수단은 여전히 없습니다. 블록 스케줄러가 `none`이고 원본 파일이 9p 경로에 있는 한, `IOSchedulingClass` 계열 설정은 이 환경에서 쓸 수 없습니다. 입출력이 다시 병목이 되면 다른 방법을 찾아야 합니다.
넷째, 파일 변화를 감시하는 상주 서비스는 계속 CPU로 돕니다. 지금 사용량(47시간에 6.7분)이면 문제가 없지만, 감시 대상이 크게 늘면 이 판단은 다시 해야 합니다.
자원 제한은 언제 걸어야 하나? — 제한 없음 × 실측 부하
이번 일로 자원 제한을 거는 기준을 하나 정했습니다. 제한이 없다는 사실만으로는 경보가 아닙니다. 같은 날 감사에서 제한 없는 서비스 5개가 46시간 동안 CPU를 0.4분 이하로 썼습니다. 이런 서비스에 제한을 걸면 관리할 설정만 늘고, 무해한 경고가 매번 뜨면 아무도 경고를 보지 않게 됩니다.
그래서 판정은 두 조건의 곱으로 합니다. 제한이 없고, 동시에 실측 평균 CPU가 20% 이상인 서비스만 조치 대상입니다. 이 기준으로 걸린 서비스는 평균 33.9%를 쓰던 cron 하나였고, 여기에도 상한 대신 Nice를 0에서 5로 낮추는 조치만 했습니다. Nice는 여유가 있으면 CPU를 그대로 다 쓰게 두므로, 시간에 민감한 작업을 크게 밀어낼 걱정이 적습니다.
- 먼저 PSI로 무엇을 기다리는지 잰다 — cpu가 0이면 CPU 상한은 답이 아니다
- 총량 상한(CPUQuota)은 같은 계산을 더 오래 끌게 만든다. 타이머 간격을 넘기면 상시 가동으로 바뀐다
- 순서 문제는 Nice로 푼다. 경쟁이 없을 때는 아무것도 빼앗지 않는다
- 입출력 우선순위 설정은 스케줄러와 파일 시스템이 받아 줄 때만 작동한다
- 잠금 오류에 대기 시간을 늘리기 전에 트랜잭션을 얼마나 오래 쥐는지부터 본다
WSL에서 메모리가 쌓이는 문제를 커널 회수로 다룬 과정은 WSL 메모리 회수를 cgroup으로 바꾼 기록에 따로 정리했습니다. 사내 PC나 서버에서 도는 자동화 작업이 사람 쪽 작업을 방해하는 문제로 고민 중이라면 상담으로 상황을 알려 주세요.
이 글은 SGK 스튜디오가 자체 자동화 환경을 운영하면서 남긴 결정 기록과 측정값을 바탕으로 썼습니다.