크론 실행 확인을 왜 crontab -l 로 하면 안 되나?
크론 실행 확인을 crontab -l 로 끝내면, 실제로 한 번도 돌지 않은 작업까지 자동화 실적에 들어간다. crontab -l 은 "이 시각에 이 명령을 실행하라"는 예약 목록만 보여 준다. 예약이 있다는 사실은 실행이 일어났다는 증거가 아니다. 스크립트 경로가 바뀌었거나, 실행 환경 변수가 빠졌거나, 앞단 작업이 실패해 조용히 끝났어도 목록의 줄은 그대로 남는다.
SGK 스튜디오는 2026년 10월 1일 기준으로 크론 168개를 등록해 두고 있었다. 이 숫자를 그대로 "168개를 자동화했다"고 쓰면 숫자가 부풀고, 고객이 한 번만 되물어도 무너진다. 그래서 이 회사의 자동화 계측기는 crontab -l 을 세지 않고, 로그와 기록 파일에 남은 실행 흔적을 센다. 이 글은 그 방식으로 세어 본 결과, 그리고 흔적을 세는 방식 자체에도 구멍이 셋 있었다는 이야기다.
코딩 얘기만은 아니다. 외주로 자동화를 맡겼거나 사내에 예약 작업을 여러 개 걸어 둔 회사라면 "설정해 뒀다"와 "돌고 있다"가 다른 말이라는 점은 똑같이 적용된다.
168개를 어디까지 좁혀야 셀 자격이 생기나?
처음 가설은 단순했다. 등록 목록이 곧 자동화 목록이니, 168개 전부를 대상으로 실행 횟수를 세면 된다고 봤다. 이 가설은 세기 전에 먼저 무너졌다. 168개는 성격이 서로 다른 넷이 섞인 숫자였기 때문이다.
- 업무대체 70개 — 사람이 하던 일을 대신한다. 사람 시간과 비교하는 기준선을 붙일 수 있는 유일한 성격
- 감시 45개 — 사람이 원래 하지 않던 일. 기준선이 맞지 않아 사고를 일찍 발견한 건수로 따로 센다
- 보고 35개 — 손이 아니라 판단을 앞당긴다. 기준선이 애매해 분류만 했다
- 위생 17개 — 인프라 자체를 유지하는 작업. 업무가 아니라서 제외했다
- 미분류 1개 — 아직 판정하지 않았다
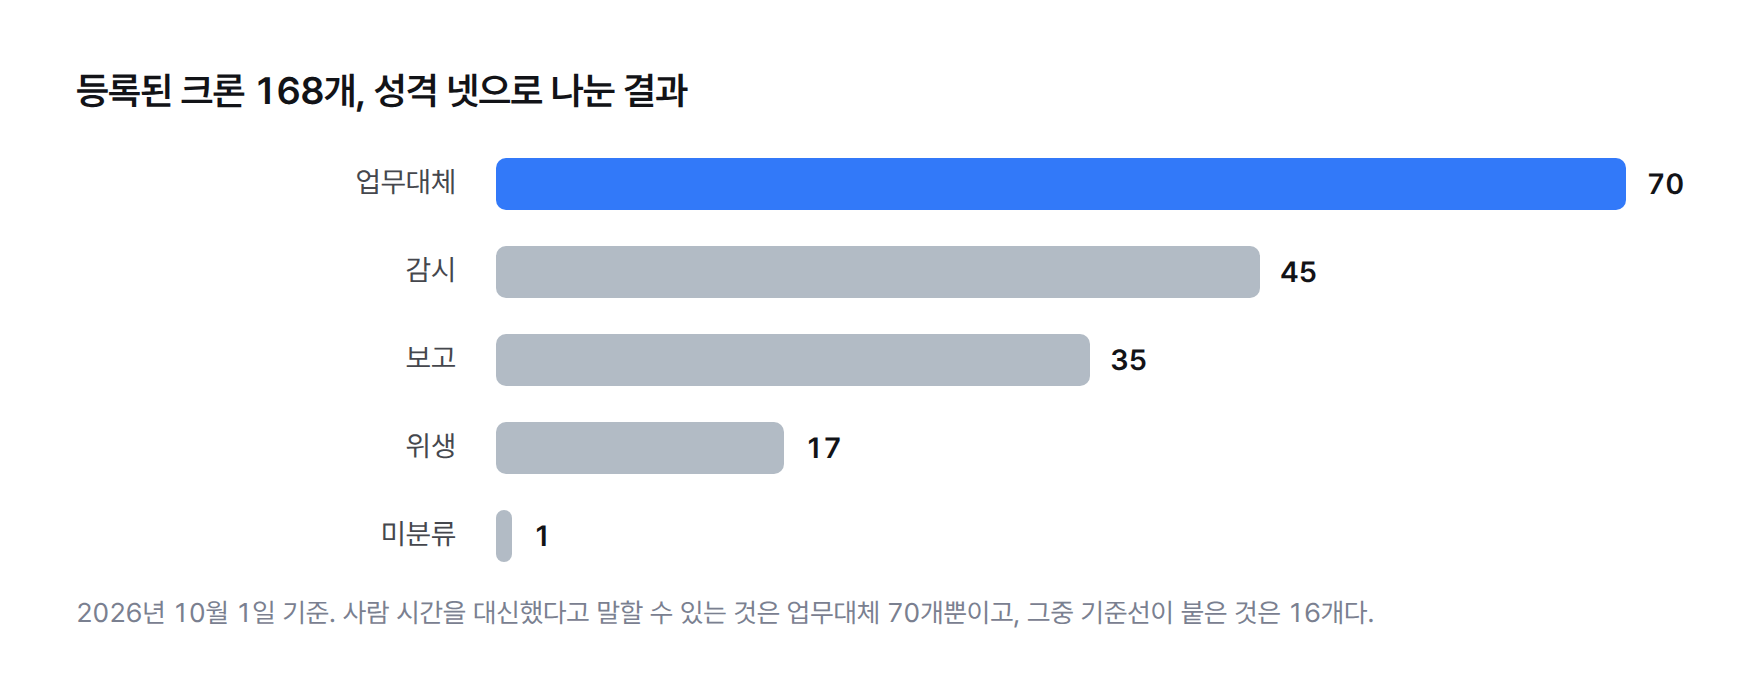
감시 작업이 한 달에 몇 번 돌았는지는 사람 시간을 아낀 증거가 아니다. 사람이 애초에 하지 않던 일이기 때문이다. 그래서 업무 대체 시간을 말할 자격은 70개에만 있었고, 그중에서도 사람이 하면 몇 분 걸리는지 기준선까지 붙은 작업은 16개였다. 실행 흔적 집계는 이 70개를 대상으로 돌렸다.
70개의 실행 흔적을 세어 보니 무엇이 나왔나?
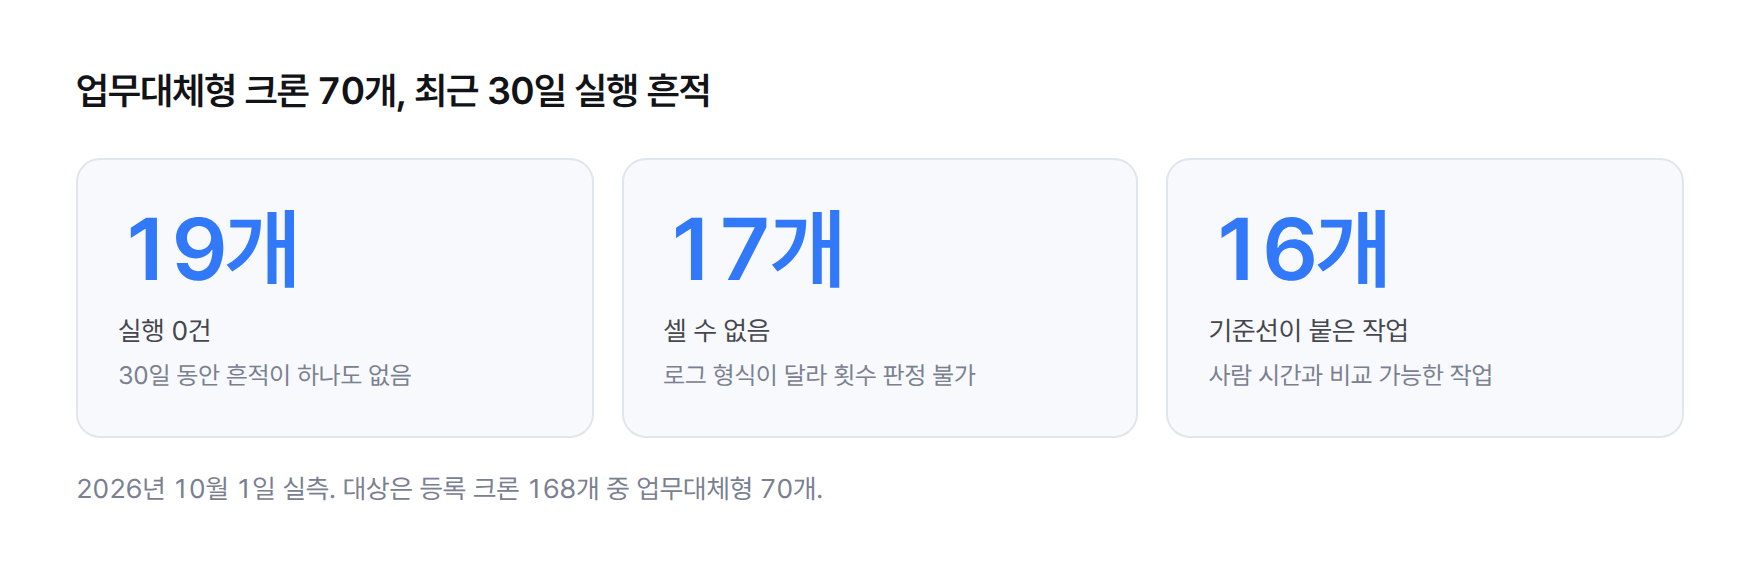
2026년 10월 1일, 업무대체형 70개의 최근 30일 기록을 셌다. 결과는 두 덩어리로 갈렸다. 실행 0회가 19개였고, 로그 형식이 서로 달라 횟수를 셀 수 없는 작업이 17개였다. 매일 또는 매주 돌도록 예약해 둔 작업 중 상당수가 30일 동안 흔적을 하나도 남기지 않았거나, 남겼어도 기계가 읽을 수 없는 모양이었다.
실행 0건으로 잡힌 작업 가운데 이름이 기록에 남은 10개를 기록 방식과 함께 옮기면 아래와 같다. 여기서 이미 하나가 눈에 띈다. 0건이라는 같은 숫자라도 전용 로그가 있는 작업과 로그가 아예 없는 작업은 뜻이 다르다.
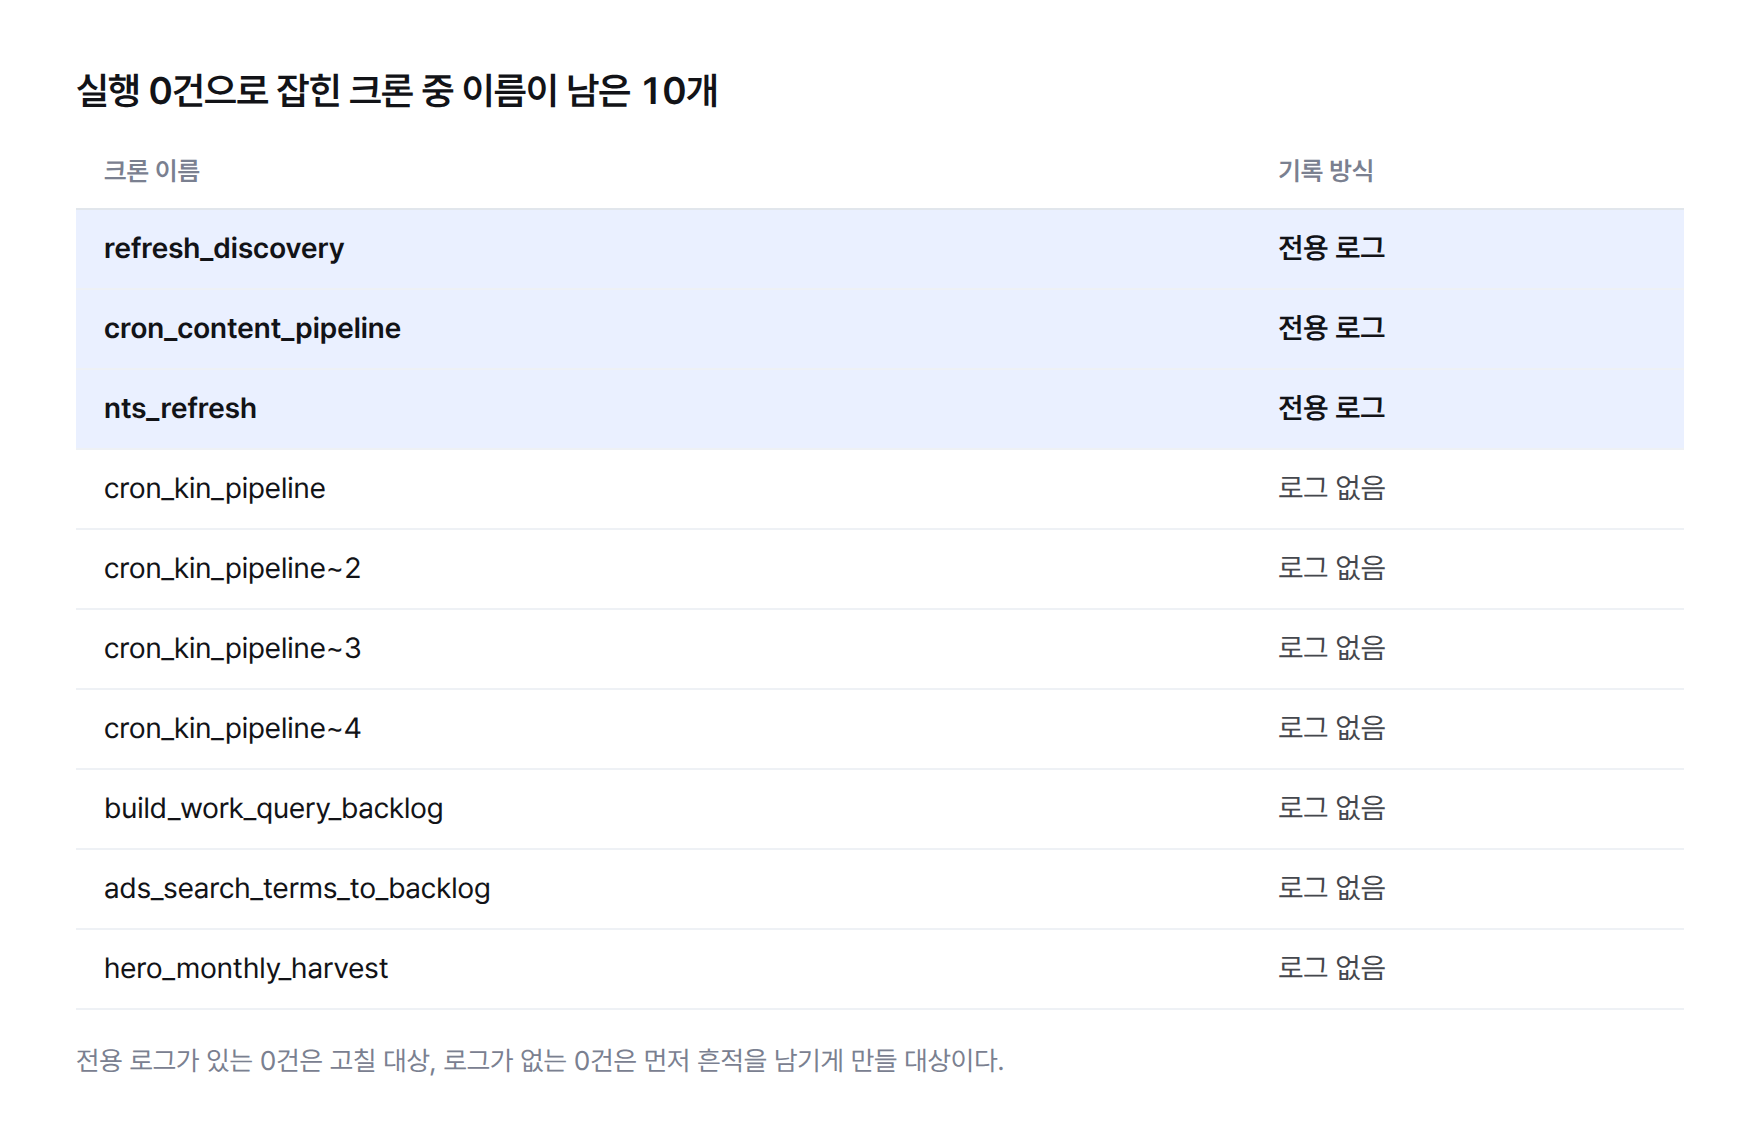
목록에서 cron_kin_pipeline 은 이름 뒤에 ~2, ~3, ~4 가 붙어 네 번 나온다. 같은 스크립트를 하루 중 여러 시각에 나눠 걸어 둔 예약이다. 크론 설정에서는 네 줄이지만 기록 쪽에서는 넷 다 로그가 없어서, 네 번 중 몇 번이 돌았는지 구분할 방법이 없다.
실행 0건과 로그 없음은 같은 신호인가?
두 번째 가설은 "0건이면 고장"이었다. 0건을 받은 19개를 전부 고장 목록에 올리고 하나씩 고치면 끝난다고 봤다. 이 가설은 반만 맞았다.
전용 로그가 있는 3개(refresh_discovery, cron_content_pipeline, nts_refresh)는 판정이 비교적 분명하다. 그 작업만 쓰는 로그 파일이 있는데 최근 30일 동안 실행 흔적이 없다면, 작업이 돌지 않았거나 로그를 다른 곳에 쓰기 시작했거나 둘 중 하나다. 어느 쪽이든 고쳐야 할 대상이다.
로그가 없는 7개는 사정이 다르다. 로그가 없다는 말은 "안 돌았다"와 "돌았는데 흔적을 남기지 않았다"를 구분할 수 없다는 뜻이다. 이 7개의 0건은 실행 횟수가 아니라 측정 장치가 없다는 표시에 가깝다. 고장 목록에 올리기 전에 먼저 실행 흔적을 남기게 만들어야 판정 자체가 가능해진다.
등록됐다고 도는 게 아니다. 그래서 이 계측기는 crontab -l 이 아니라 로그·기록 파일의 실행 흔적을 센다.
셀 수 없는 17개도 같은 축에 있다. 로그는 있지만 형식이 제각각이라, 한 줄이 한 번의 실행인지 한 번의 실행 안에서 찍힌 여러 메시지인지 기계가 가려내지 못했다. 0건 19개와 셀 수 없음 17개를 합치면 70개 중 절반이 넘는 작업의 실행 횟수를 믿을 수 없는 상태였다.
이 상태에서 대체 시간 합계를 내면 두 방향으로 동시에 틀린다. 실제로 돌았지만 흔적이 없는 작업은 0으로 빠져 합계를 깎고, 아래에서 볼 과대 집계 작업은 합계를 부풀린다. 둘이 서로 상쇄돼 그럴듯한 숫자가 나오더라도, 그 숫자는 어느 작업이 일을 했는지 말해 주지 못한다.
실행 흔적은 어떤 방식으로 세고 있었나?
실행 흔적이 남는 작업도 세는 방식이 하나가 아니었다. 계측 기록에는 작업마다 셈법이 붙어 있는데, 세 가지가 섞여 있었다.
- 전용 로그 — 그 작업만 쓰는 로그 파일에서 실행 기록을 센다. 리드 이메일 수집(night_email_scrape)이 이 방식이다
- 공용 로그 grep — 여러 작업이 함께 쓰는 로그에서 작업 이름으로 줄을 걸러 센다. 채용 공고 수집 2종(jobpost-scan, jobpost-wanted-scan)이 이 방식이다
- 산출 마커 — 작업이 만들어 낸 결과물에 남긴 표시를 센다. 기술블로그 발행(techblog-daily)과 리포트 발행(report_autopublish)이 이 방식이다
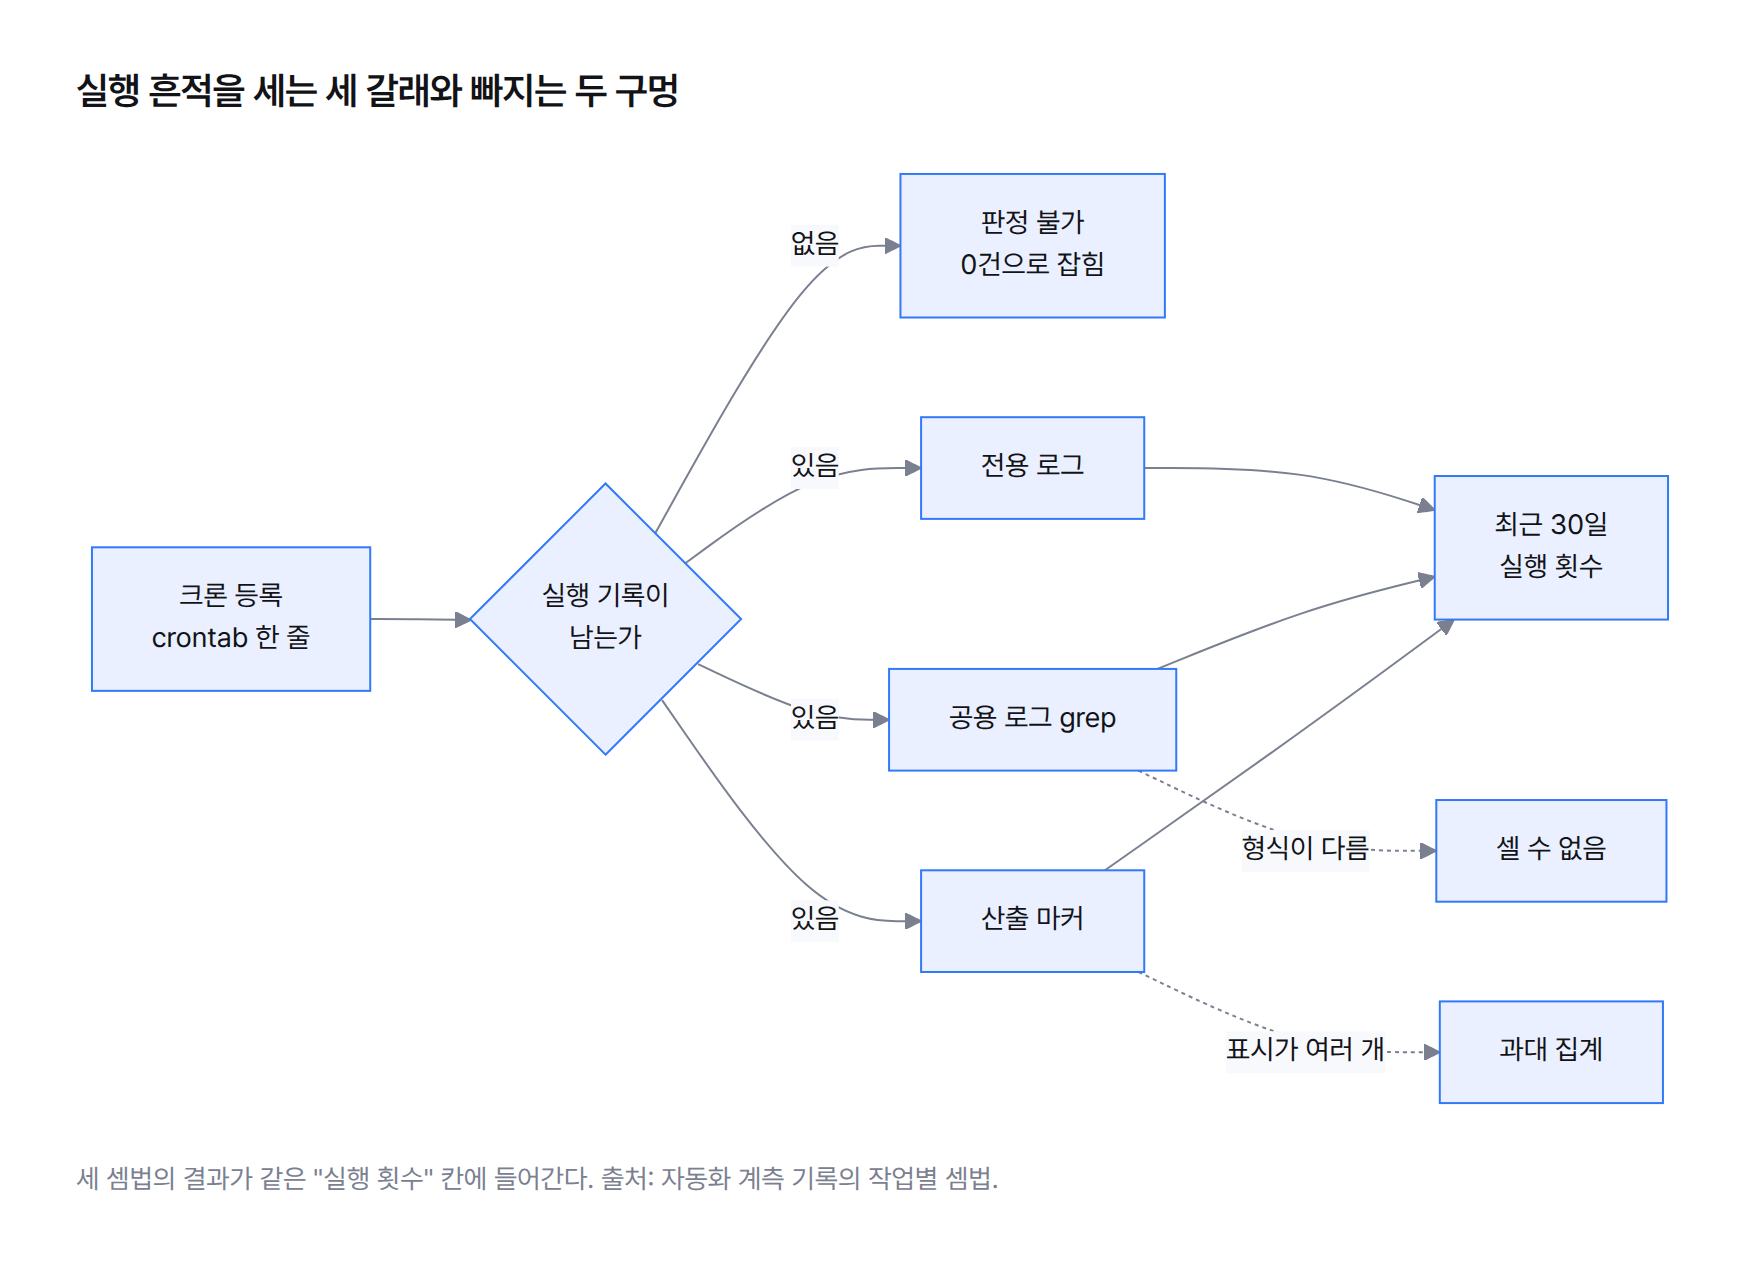
문제는 이 세 셈법이 같은 칸 하나, "최근 30일 실행 횟수"에 들어간다는 점이었다. 셈법이 다르면 같은 숫자라도 무엇을 셌는지가 다르다. 이 차이는 예약 주기와 나란히 놓았을 때 바로 드러났다.
하루 한 번 도는 크론이 30일에 92회로 잡힌 이유는?
다섯 작업의 예약 주기와 최근 30일 실행 횟수를 한 표에 놓았다. 다섯 개 모두 크론 표현식상 하루 한 번 도는 작업이다. 하루 한 번이면 30일 동안 많아야 30회 안팎이 나와야 한다.
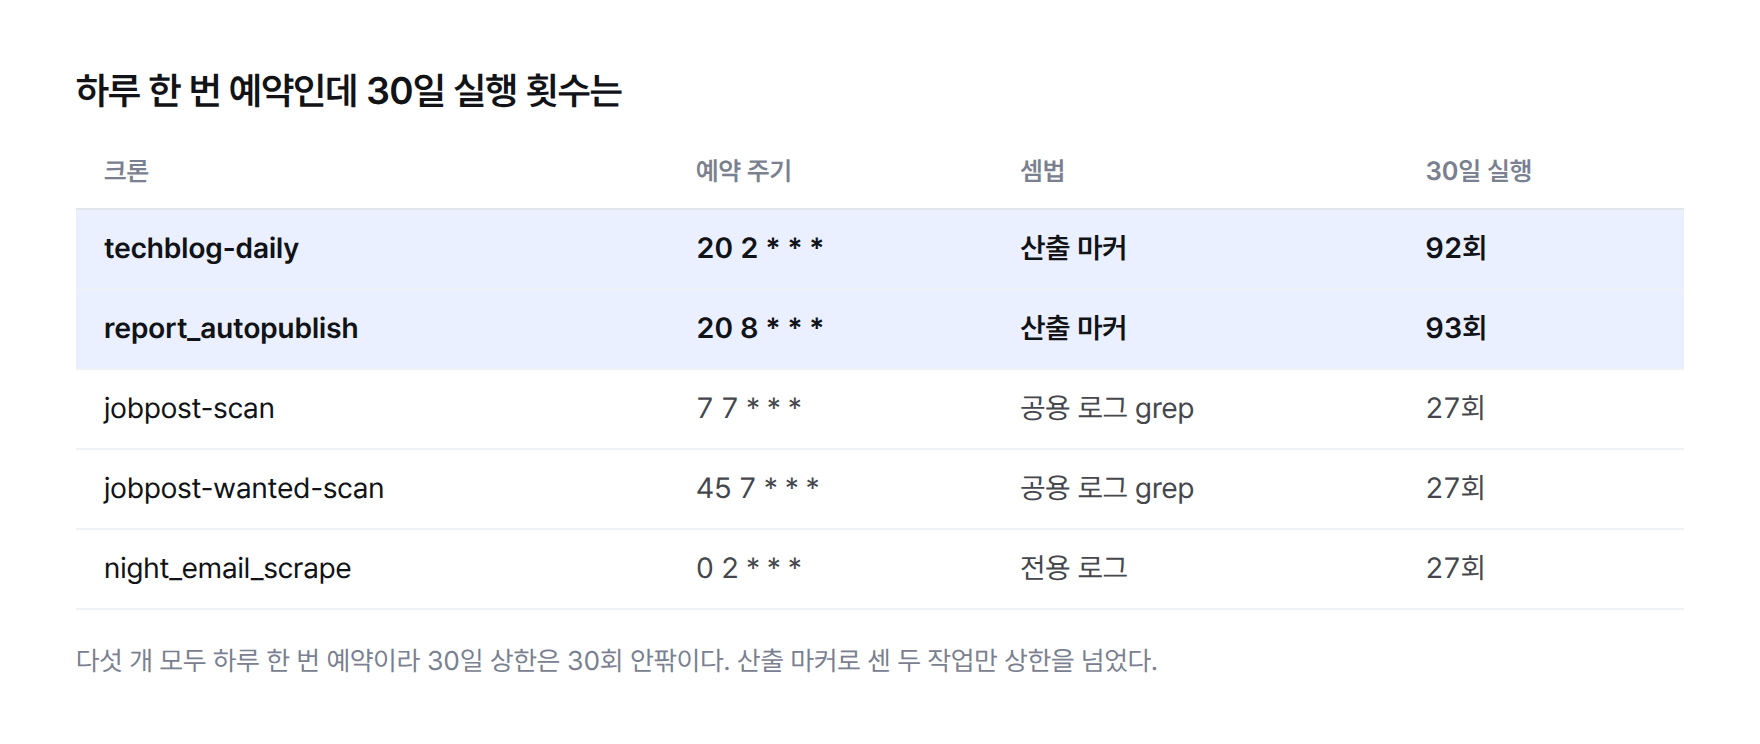
로그로 센 세 작업은 27회로 상한 안쪽이다. 산출 마커로 센 두 작업은 92회와 93회로, 하루 한 번 예약이 낼 수 있는 상한의 세 배를 넘는다. 예약이 하루 한 번인데 실행이 세 배일 수는 없으니, 이 숫자는 실행 횟수가 아니라 결과물 표시의 개수라고 읽어야 맞다. 한 번 실행에 표시가 여러 개 찍히면 그대로 부풀어 오른다.
이 숫자는 그대로 사람 시간 계산에 들어간다. 기술블로그 1편은 사람이 하면 120분으로 잡혀 있어 92회 × 120분 = 184.0시간, 리포트 1편은 90분으로 잡혀 93회 × 90분 = 139.5시간이 대체 시간으로 기록돼 있었다. 반면 공고 수집은 27회 × 20분 = 9.0시간, 이메일 수집은 27회 × 40분 = 18.0시간이다. 대체 시간이 큰 두 작업이 하필 셈법이 가장 의심스러운 두 작업이었다.
곱셈의 다른 쪽 인수도 실측값이 아니다. 건당 사람 시간은 다섯 작업 모두 추정(estimate) 등급이다. 기술블로그 120분은 6,600자 이상 기술 글 1편을 손으로 쓰는 데 60~90분, 검수·발행에 30분을 잡은 값이고, 이미 발행한 9편의 실제 분량(11K~23K자)에서 거꾸로 짐작했다. 리포트 90분은 수기 작성 60분과 검수·발행 30분, 공고 수집 20분은 검색·목록 훑기 12분과 상위 공고 열람·기록 8분, 이메일 수집 40분은 대상 사이트 순회 30분과 정리 10분을 더한 값이다. 실행 횟수가 부풀면 추정값이 그 배수만큼 함께 부푼다.
대체 시간 = 최근 30일 실행 횟수 × 사람이 하면 걸리는 건당 시간. 건당 시간은 모두 추정(estimate) 등급이다.
산출 마커 셈법의 과대 집계는 리포트 자동 발행 크론 글에서 따로 파고들었다. 이 글에서 짚을 점은 하나다. 실행 0건이 정확하지 않듯, 실행 횟수가 크다고 정확하지도 않다. 0과 과대값은 같은 원인, 즉 셈법이 칸마다 달랐다는 데서 나왔다.
이 계측에서 무엇을 바꿨나
결론은 세 줄로 정리된다. 첫째, 크론 실행 확인의 출발점은 crontab -l 이 아니라 실행 흔적이다. 168개라는 등록 숫자는 실적으로 쓰지 않고, 성격으로 갈라 업무대체 70개만 실행 흔적을 센다. 둘째, 0건은 두 종류로 나눈다. 전용 로그가 있는 0건은 고칠 대상, 로그가 없는 0건은 먼저 흔적을 남기게 만들 대상이다. 셋째, 실행 횟수 옆에는 반드시 셈법을 함께 적고, 예약 주기가 허락하는 상한과 대조한다.
반증된 가설도 그대로 남겨 둔다. "등록 목록이 곧 자동화 목록"이라는 첫 가설은 성격 분류에서 무너졌고, "0건이면 고장"이라는 둘째 가설은 로그 없는 7개에서 반만 맞았다. 셋째로 "흔적만 세면 정확하다"는 믿음도 산출 마커 두 작업의 92회와 93회 앞에서 무너졌다. 셋 다 처음에는 당연해 보였다.
같은 계측의 이전 결과와 "등록과 실행은 왜 다른가"의 기본 설명은 크론 모니터링 글에 정리해 두었다.
크론 실행 확인을 직접 할 때 볼 세 가지
회사에서 예약 작업을 여러 개 운영하고 있다면 아래 세 가지만 확인해도 "돌고 있다고 믿는 작업"과 "실제로 도는 작업"의 차이가 드러난다.
| 확인 항목 | 방법 | 걸리면 무엇을 하나 |
|---|---|---|
| 실행 흔적이 있는가 | 작업마다 전용 로그나 결과물 표시가 최근 30일에 남았는지 센다 | 흔적이 없으면 고치기 전에 흔적부터 남기게 만든다 |
| 0건의 종류는 무엇인가 | 로그가 있는데 0건인지, 로그 자체가 없는지 나눈다 | 로그가 있는 0건만 고장 후보로 올린다 |
| 횟수가 주기와 맞는가 | 하루 한 번 예약이면 30일 상한을 넘는지 본다 | 상한을 넘으면 셈법이 결과물을 세고 있지 않은지 확인한다 |
자동화가 실제로 얼마나 일을 대신하고 있는지, 그 숫자를 무엇으로 셀지부터 정리하고 싶다면 상담에서 이야기를 나눌 수 있다.