증상: 새 스타일 4개가 검사에서 전부 떨어졌다
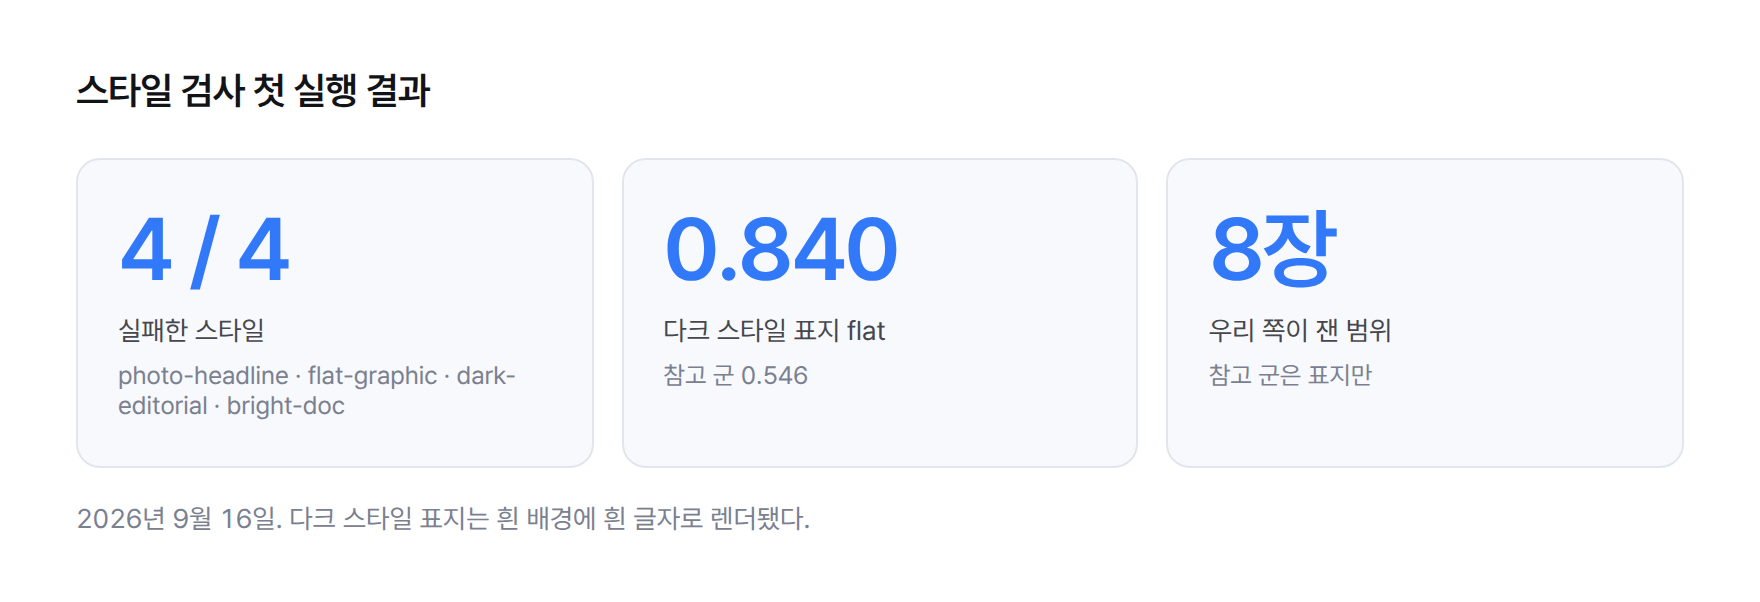
카드뉴스 디자인 스타일을 수치로 나눠 재현하는 작업에서, 검사 스크립트가 처음 낸 결론은 "네 스타일 모두 참고 군과 다르다"였다. 2026년 9월 16일, 우리는 참고 계정 121곳 가운데 87곳의 캐러셀 표지 1,976장을 재서 계정들을 다섯 군으로 나눴고, 그중 넷을 실제로 렌더할 스타일로 내보냈다. 같은 원고를 네 스타일로 각각 그린 뒤 게이트에 넣자 넷 다 실패가 나왔다.
게이트가 보는 값은 단순하다. 렌더한 카드의 밝기와 `flat` 값을 참고 군의 중앙값과 견준다. `flat`은 주변 픽셀과 값이 같은 픽셀의 비율로, 단색 면이 넓을수록 1에 가깝고 사진이 많을수록 낮아진다. 같은 날 다크 스타일(`dark-editorial`) 표지를 열어 보니 문제가 숫자에만 있지 않았다. 흰 배경에 흰 글자가 얹힌 표지가 나와 있었다.
참고 계정의 게시물을 모은 과정은 인스타그램 크롤링 글에 따로 적었다. 이 글은 그 이미지를 받아 스타일을 가른 다음 단계에서 생긴 일이다. 정답을 처음부터 안 게 아니라, 틀린 가설 하나를 실측으로 지운 뒤에야 원인 두 개가 보였다.
스타일은 어떻게 나눴나?
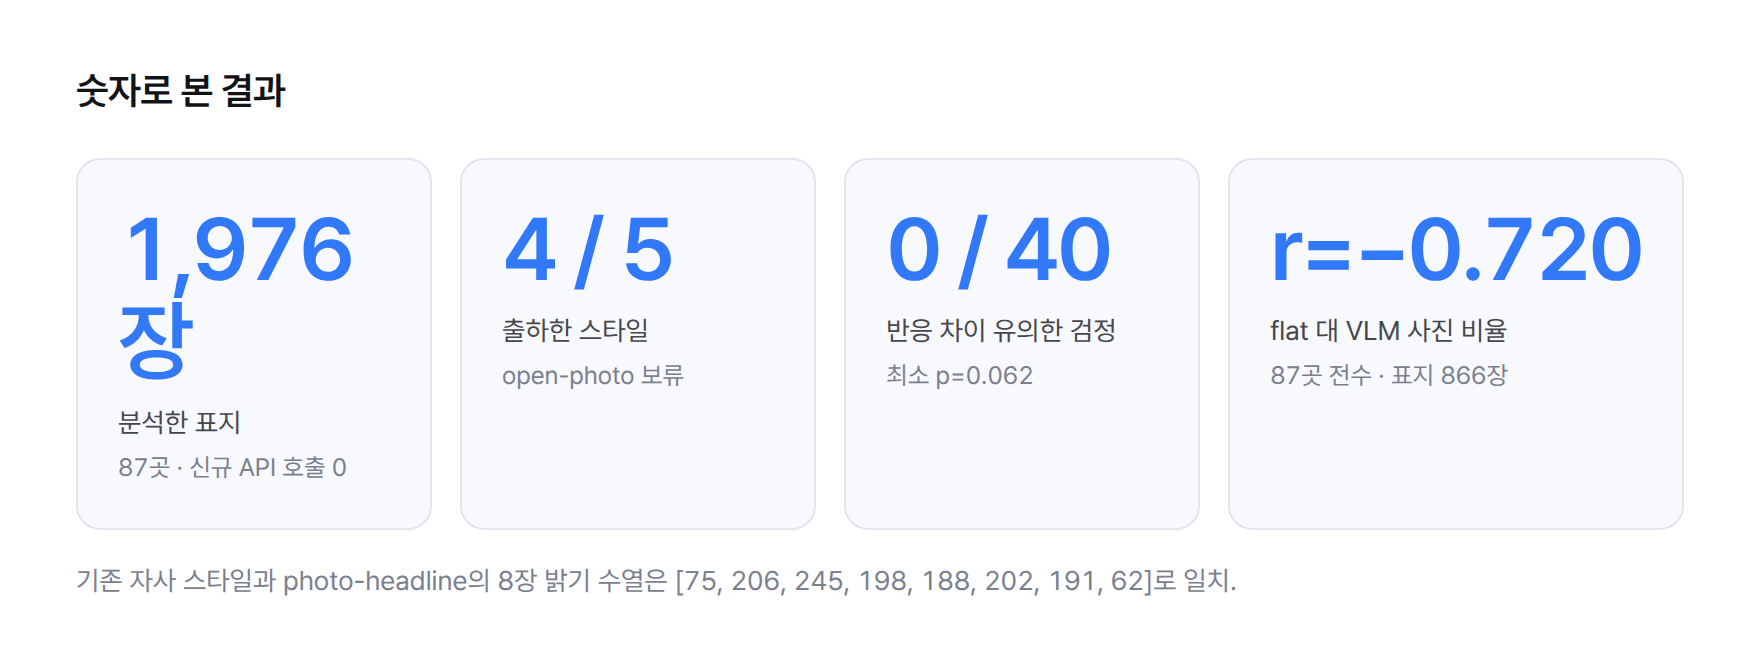
원인을 말하려면 자가 어떻게 생겼는지부터 적어야 한다. 묶는 단위는 게시물이 아니라 계정으로 잡았다. 스타일은 한 장의 성질이 아니라 한 계정이 꾸준히 쓰는 시각 언어라고 봤기 때문이다. 계정마다 캐러셀 표지 24장을 재서 중앙값으로 접었다. 이미지는 이미 로컬에 있었고, 새로 부른 API는 0건이었다.
표본에서 둘을 뺐다. 하나는 릴스 썸네일이다. 거르지 않으면 101곳 중 42곳이 9:16 비율로 한데 묶여, 비율 축이 스타일 대신 콘텐츠 형식을 재게 된다. 다른 하나는 캐러셀이 8장 미만인 34곳이다. 릴스 위주 계정이라 배울 카드 문법이 없었다.
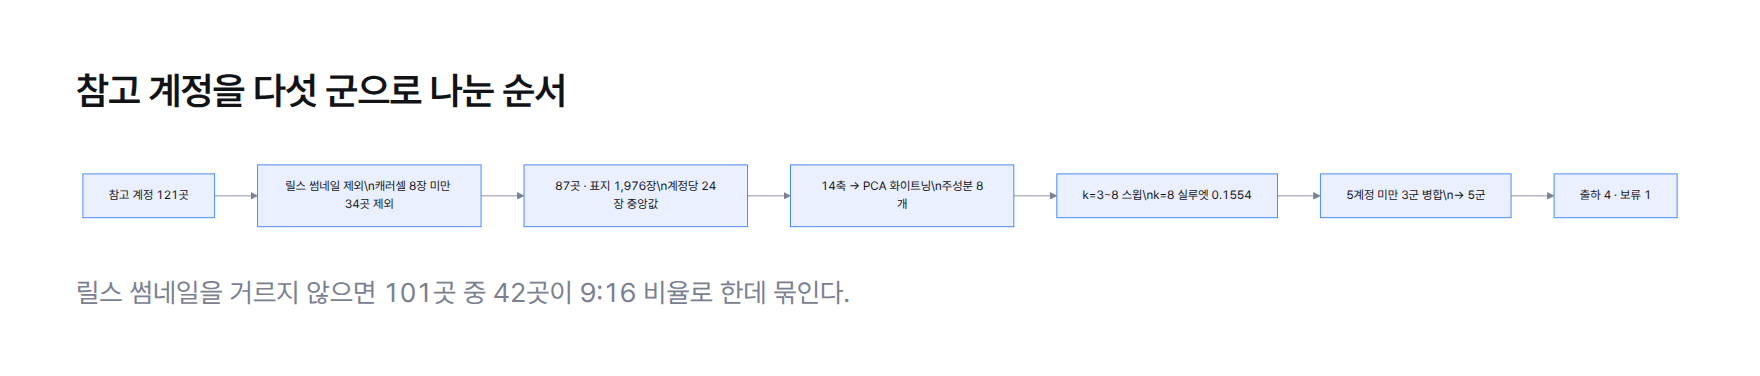
판별 축은 14개였다. 그중 밝기 계열 5축이 서로 상관이 높아 사실상 한 표를 다섯 번 던졌고, 군이 "밝다/어둡다" 하나로만 갈렸다. 이건 PCA 화이트닝으로 풀었다. 14축을 주성분 8개로 줄이고 각 성분의 분산을 같게 맞춘 뒤 k=3~8을 스윕했다. 실루엣 점수가 가장 나은 k=8(0.1554)을 고르고, 5계정 미만인 작은 군 3개를 병합해 최종 5군이 나왔다.
| 스타일 | 성격 | 계정 수 | 출하 |
|---|---|---|---|
| photo-headline | 사진 위 헤드라인 | 20곳 | 출하 |
| flat-graphic | 색면 그래픽 | 22곳 | 출하 |
| dark-editorial | 다크 판형 | 11곳 | 출하 |
| bright-doc | 밝은 문서판 | 8곳 | 출하 |
| open-photo | 무형식 사진 | 17곳 | 보류 — 고정 틀이 없어 재현할 문법이 없다 |
군 번호는 다시 돌릴 때마다 바뀌므로, 계정 표지를 모은 콘택트 시트를 눈으로 확인해 이름을 붙이고 별도 파일에 고정했다. 렌더러는 스타일 이름을 인자로 받도록 바꿨고, 바탕은 사진·어두운 사진·사진 변형·밝은 단색 네 모드를 토큰으로 고르게 했다.
처음엔 무엇을 의심했나?
게이트가 넷 다 떨어뜨렸을 때 먼저 의심한 쪽은 이미지 품질이었다. 참고 이미지는 인스타그램이 다시 압축한 JPEG이고, 우리 렌더 결과는 깨끗한 원본이다. JPEG 재압축은 경계 근처에 잡음을 만들고, 그러면 주변과 값이 같은 픽셀의 비율인 `flat`이 달라질 수 있다. 가설은 이랬다.
참고 이미지는 재압축 잡음 때문에 flat이 낮게 나오고, 우리 렌더는 잡음이 없어 높게 나온다. 그래서 네 스타일이 한꺼번에 어긋난다.
그럴듯했던 이유는 실패가 한 방향으로 몰려 있었기 때문이다. 스타일 하나만 틀렸다면 그 스타일의 토큰을 봤겠지만, 넷이 동시에 떨어지면 공통 원인을 찾게 된다. 압축은 네 스타일이 모두 거치는 유일한 공통 단계처럼 보였다.
무엇으로 확인했나?
확인 수단은 세 가지였다. 가설을 직접 재현하는 실험 하나, 축 자체가 제대로 가르는지 보는 양성 표본, 그리고 픽셀 계측과 독립된 두 번째 계측기다.
- 재인코딩 실험 — 우리 렌더 결과를 품질 72(q72) JPEG으로 다시 저장해, 압축만으로 flat이 움직이는지 잰다
- 양성 표본 — 사진 계정과 색면 계정처럼 답을 아는 계정을 골라, 축이 그 둘을 실제로 가르는지 먼저 본다
- 비전 언어 모델(VLM) 교차검증 — 로컬 qwen3-vl로 표지마다 사진·얼굴·화면 캡처 여부를 물어, 픽셀 수치와 같은 방향인지 본다
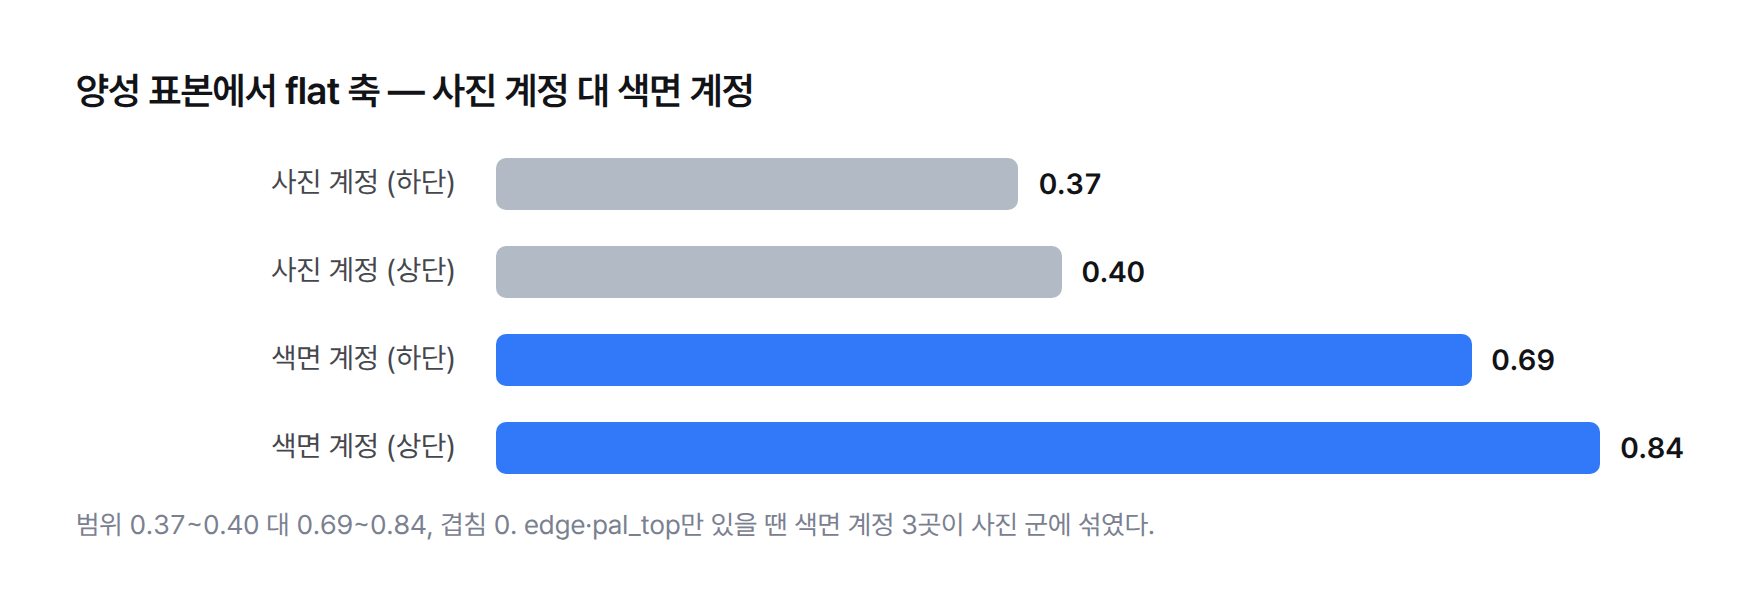
양성 표본은 군집 분석 단계에서 이미 한 번 쓴 수단이다. `flat` 축을 넣기 전에 사진 계정과 색면 계정을 견줬더니 사진 계정은 0.37~0.40, 색면 계정은 0.69~0.84로 겹침이 0이었다. 반대로 원래 쓰던 `edge`(경계선 밀도)와 `pal_top`(대표색 비중)은 같은 표본에서 갈리지 않았고, 그 둘만 있을 땐 색면 계정 3곳이 사진 군에 끌려 들어가 있었다.
왜 JPEG 재압축은 범인이 아니었나?
재인코딩 실험의 답은 짧았다. 우리 렌더를 q72로 다시 저장해도 `flat` 변화는 0이었다. 압축 잡음이 이 축을 움직인다면 여기서 값이 흔들려야 하는데 움직이지 않았다. 네 스타일이 함께 떨어진 이유를 압축에서 찾을 근거가 사라졌다.
이 실험 앞에서 지운 가설이 하나 더 있다. 처음 군집 축을 고를 때, 우리는 VLM이 붙인 사진·얼굴·캡처 라벨을 군을 나누는 축으로 쓰려 했다. 그런데 qwen3-vl은 AI로 생성한 이미지를 "실제 사진 아님"으로 읽었다. 표지 대부분이 이미지인 `ai.trend.kr`을 사진 비율 0.5로 냈다. 그래서 VLM은 군을 나누는 축에서 빼고 검증용 계측기로만 남겼다.
남은 일은 압축이 아니라면 무엇이 넷을 한꺼번에 떨어뜨리느냐였다. 공통 단계가 압축 말고 하나 더 있었다. 게이트가 비교에 쓰는 자 자체다.
진짜 원인 1: 표지만 잰 자로 8장 전체를 쟀다
군 프로파일은 계정마다 캐러셀 표지만 재서 만든 값이다. 그런데 게이트는 우리 카드 8장 전부를 재서 그 값과 견주고 있었다. 표지는 큰 헤드라인과 사진이 주인공이고, 2번째 장부터는 설명 글과 여백이 늘어난다. 같은 스타일이라도 8장 평균은 표지 하나와 다른 값이 나온다.
즉 네 스타일이 동시에 떨어진 이유는 네 스타일이 모두 틀려서가 아니라, 네 스타일 모두 다른 자로 재고 있었기 때문이다. 공통 원인을 찾은 방향은 맞았지만, 그 공통점은 이미지가 아니라 측정 범위에 있었다. 고친 방법은 간단하다. 표지는 표지끼리만 견준다.
진짜 원인 2: 어둡게 덮는 막이 밝은 색이었다
흰 배경에 흰 글자는 다른 원인이었다. 렌더러는 사진 위에 글자를 얹을 때 사진을 반투명 막으로 덮어 어둡게 만든다. 이 막을 스크림(scrim)이라 부른다. 코드에서 스크림 색은 `SCRIM = rgb("text_primary")`, 즉 본문 글자색을 그대로 빌려 쓰고 있었다.
자사 스타일 한 벌만 있을 때는 글자색이 어두웠고, 그 색으로 덮으면 사진이 어두워졌다. 다크 스타일은 반대다. 어두운 바탕에서 읽혀야 하니 글자색이 밝다. 같은 코드가 다크 스타일에서는 사진을 밝은 막으로 덮었고, 어둡게 만드는 연산이 전부 거꾸로 돌았다. 그 위에 밝은 글자가 얹혀 흰 배경에 흰 글자 표지가 나왔다.
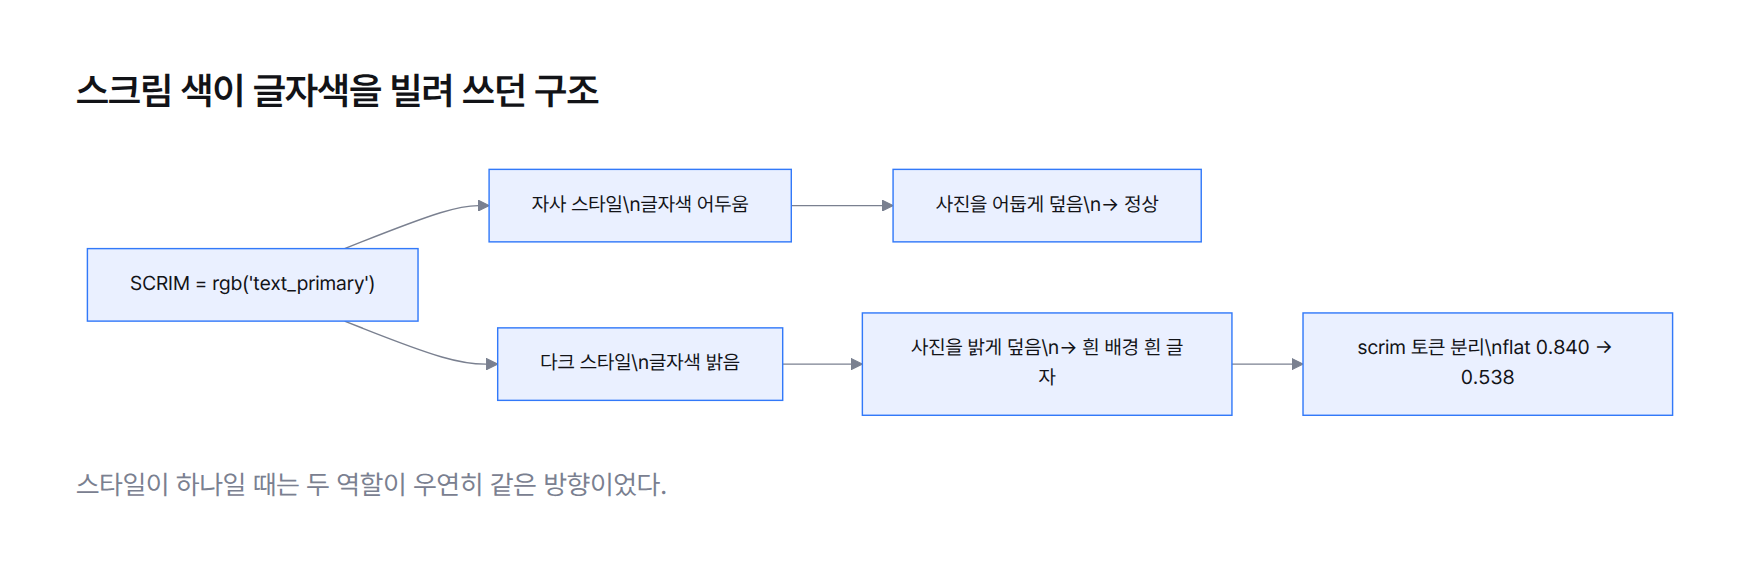
이 사고는 스타일이 하나뿐이던 동안 드러날 수 없었다. 글자색과 스크림 색이 우연히 같은 방향이었기 때문이다. 스타일이 넷으로 늘자 처음으로 두 역할이 갈렸다.
어떻게 고쳤나?
두 원인 모두 게이트의 허용 폭을 넓히면 한 줄로 통과시킬 수 있었다. 그렇게 하지 않았다. 허용 폭을 넓히면 지금 잡힌 사고를 지우는 셈이고, 다음에 같은 사고가 와도 못 잡는다. 대신 원인을 고쳤다.
- 측정 범위: 군 프로파일이 표지만 잰 값이므로, 우리 쪽도 표지만 재서 견주게 맞췄다
- 스크림: 스크림 색을 글자색에서 떼어 별도 토큰으로 분리했다. 스타일마다 덮는 막의 색을 따로 정한다
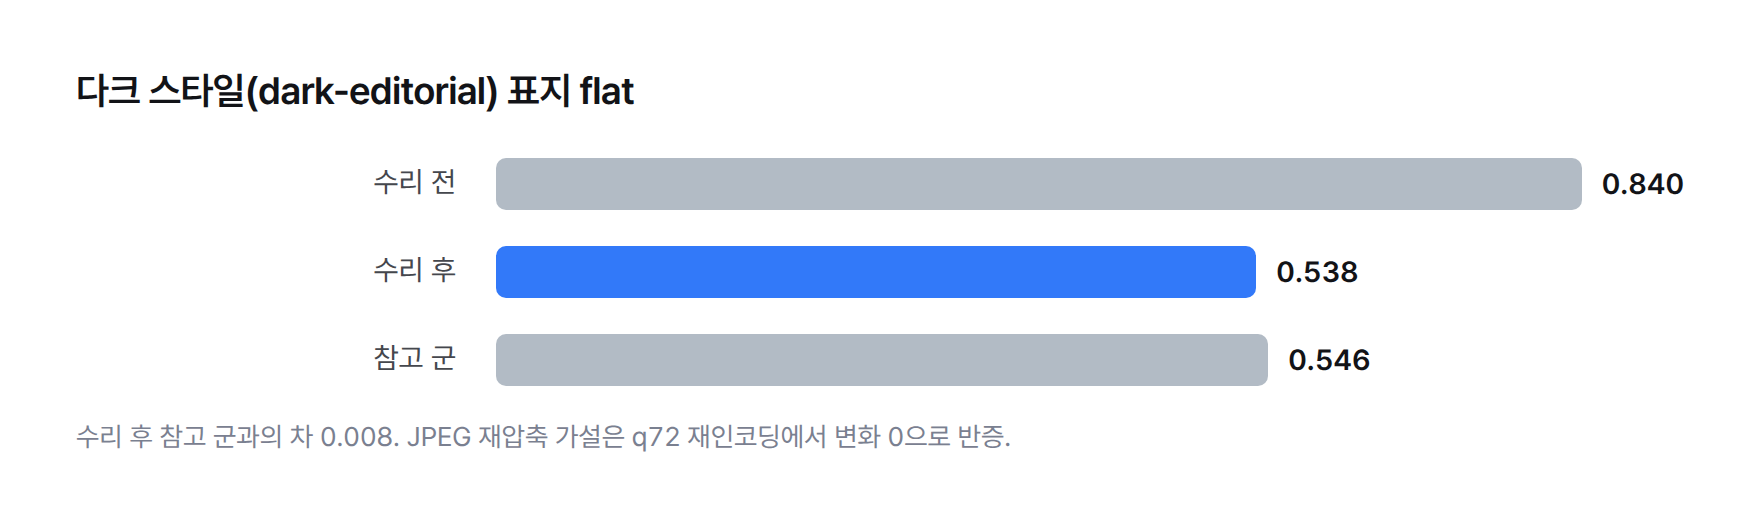
스크림을 분리하자 다크 스타일 표지의 평면 비율은 0.840에서 0.538로 내려왔다. 참고 군 값은 0.546이라 차이는 0.008이다. 게이트는 6항목 전부 통과(exit 0)로 바뀌었다.
고친 뒤 드러난 세 번째 어긋남은 무엇이었나?
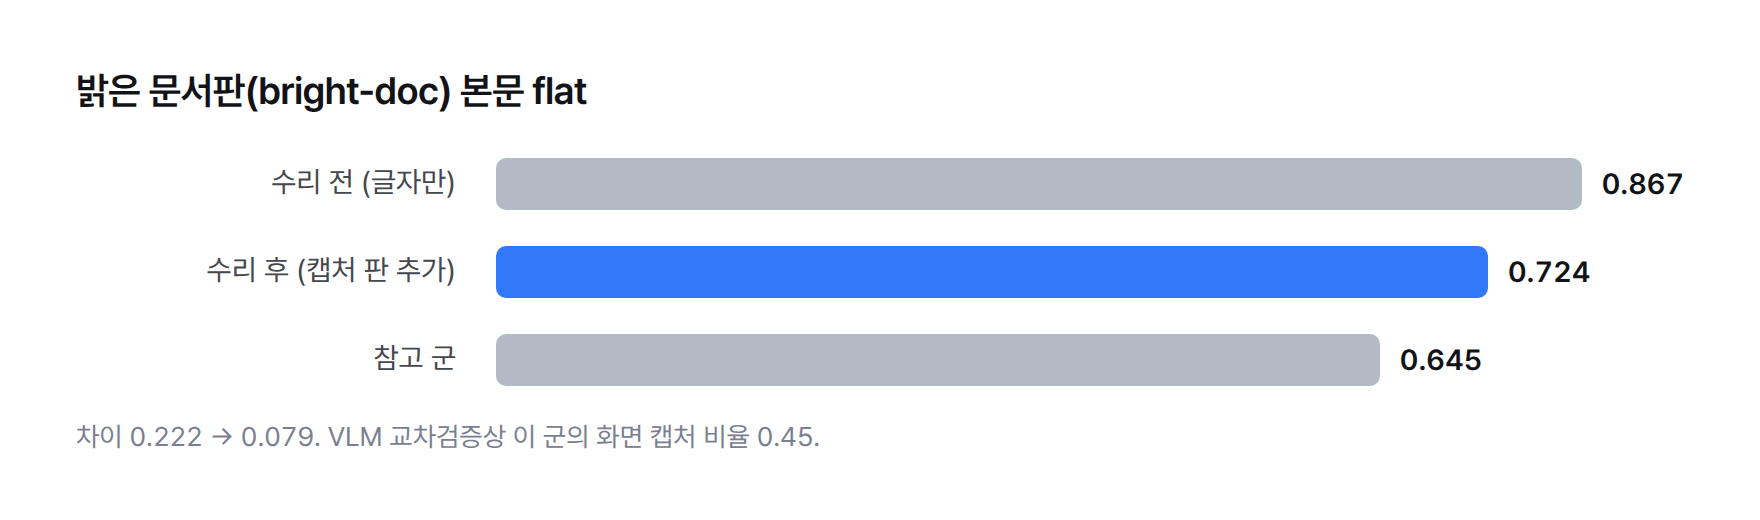
표지를 맞춘 뒤에도 게이트는 본문(2~4번째 장)을 "대조 기준 없음"으로 두고 있었다. 기준이 없으니 실패도 없었다. 그 빈칸이 갭 하나를 가리고 있었다. 군마다 본문을 따로 재서 기준선을 만들자, 밝은 문서판(`bright-doc`)만 0.222 벌어졌다. 우리 본문은 0.867, 참고 군은 0.645였다.
원인은 해석이었다. 우리는 "밝은 문서판 = 글자만 있는 판"으로 읽고 본문을 글자와 여백으로만 채웠다. 그런데 VLM 교차검증이 이미 그 군의 화면 캡처 비율 0.45를 보여 주고 있었다. 표지에 장면 사진이 없을 뿐, 본문에는 화면 캡처를 넣는 스타일이었다. 본문 판에 캡처 판을 넣자 0.724로 내려와 차이가 0.079로 줄었다.
게이트 대조점은 표지만 보던 4개에서 표지와 본문을 함께 보는 8개로 늘었고, 전부 통과했다. 가장 큰 차이는 `photo-headline` 본문의 0.149다. 허용 폭 바로 아래라 다음 관찰 대상으로 적어 두었다.
두 계측기는 같은 방향을 가리켰나?
픽셀 수치 하나만 믿으면 이번 같은 오독을 또 할 수 있다. 그래서 VLM으로 87곳 전수, 표지 866장을 다시 봤다. 이번에는 군을 나누는 축이 아니라 검증용이다. 군 수준에서 픽셀 `flat`과 VLM 사진 비율의 상관은 r=−0.720이었다. 사진이 많을수록 평면 비율이 낮다는, 예상한 방향이다.
| 확인한 것 | 근거 |
|---|---|
| 다크 판형은 어두운 단색 판이 아니라 어두운 사진이다 | dark-editorial VLM 사진 비율 0.90, 5군 중 최고 |
| 어두운 사진에서는 flat이 사진 존재를 낮게 잰다 | 사진 0.90인데 flat 0.546 > photo-headline 0.404 |
| 밝은 문서판은 이미지 없는 유일한 스타일 | bright-doc 사진 0.00 · 얼굴 0.00 (8곳 전수) |
| 무형식 사진은 고정 틀이 없다 | open-photo 하단 헤드라인 0.00 |
두 번째 줄이 중요하다. 그림자가 뭉개지면 균일한 영역이 늘어서, 어두운 사진은 `flat`만 보면 단색 판처럼 보인다. 그래서 밝기가 낮은 군은 `flat` 하나로 판정하지 않는다는 규칙을 남겼다. VLM의 한계도 그대로 남는다. AI 생성 이미지를 여전히 사진이 아니라고 읽는다.
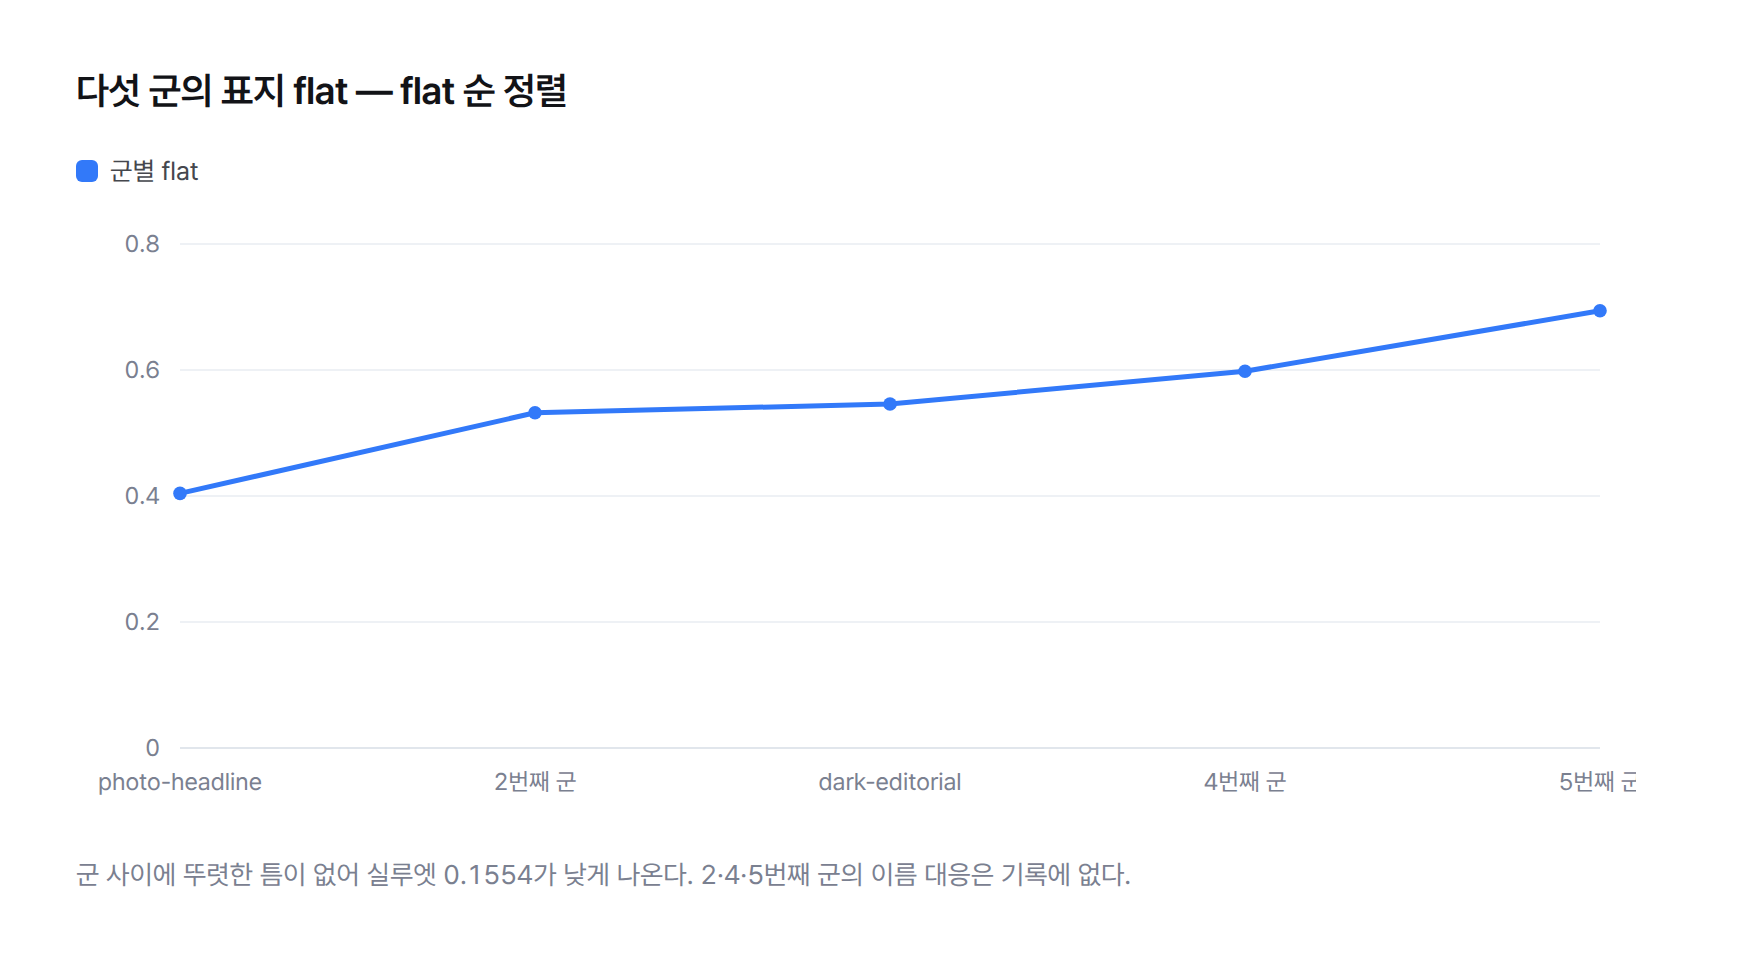
실루엣 0.1554는 낮은 값이다. 결함이라기보다 이 데이터의 성질로 봤다. 다섯 군의 `flat`이 0.404 → 0.532 → 0.546 → 0.598 → 0.694로 고르게 늘어서 있어, 군 사이에 뚜렷한 틈이 없다. 계정들은 서로 다른 가족이라기보다 한 연속 축 위에 놓여 있고, 우리는 그 축을 다섯 군데에서 잘랐다.
가장 큰 발견: 기존 디자인이 이미 한 스타일이었다
같은 원고를 렌더한 8장의 밝기 수열을 견주다가 예상 밖의 결과가 나왔다. 기존 자사 스타일과 `photo-headline`이 둘 다 [75, 206, 245, 198, 188, 202, 191, 62]로 정확히 같았다. 우리가 이전에 만든 디자인은 이 참고 계정들 가운데 가장 큰 제작 가능 군의 문법을 그대로 따른 것이었다.
그러니 이번 작업으로 새로 생긴 것은 스타일 넷이 아니라 나머지 셋과, 상황에 따라 어느 스타일을 고를지 정하는 규칙이다. 그 규칙에서 기대한 "어느 스타일이 반응이 더 좋다"는 답은 나오지 않았다. 5군 × 8축 = 40개 검정에서 유의한 차이는 0건이었고(최소 p=0.062), 40개면 우연만으로도 2건쯤 나와야 할 자리다. 스타일은 더 나은 언어가 아니라 다른 언어였다.
같은 실수를 막는 장치는 무엇인가?
이번 사고 둘은 모양이 달라도 뿌리가 같다. 하나는 측정 범위가 달랐고, 하나는 한 값이 두 역할을 맡았다. 둘 다 스타일이 하나일 때는 드러나지 않다가 넷으로 늘자 터졌다. 그래서 장치도 "늘어날 때 깨지는 곳"을 겨냥했다.
| 장치 | 무엇을 막나 |
|---|---|
| 기준선과 렌더를 같은 범위로 잰다(표지끼리, 본문끼리) | 표지 값으로 8장 전체를 재는 오판 |
| 대조 기준이 없는 칸을 남기지 않는다(대조점 4개 → 8개) | 기준 없음이 통과로 읽히는 빈칸 |
| 역할이 다른 값은 토큰을 나눈다(글자색과 스크림 분리) | 한 스타일에서만 맞던 우연이 다른 스타일에서 뒤집힘 |
| 허용 폭을 넓혀 통과시키지 않는다 | 잡힌 사고를 지워 버리는 수리 |
| 새 축은 양성 표본에서 갈리는 것을 증명한 뒤 넣는다 | 재는 척만 하고 가르지 못하는 축 |
| 어두운 군은 flat 단독으로 판정하지 않는다 | 어두운 사진을 단색 판으로 읽는 오독 |
다만 이 장치들도 재는 축만 지킨다. 같은 날 이어진 검토에서 스타일 4종의 토큰을 펼쳐 보니 같은 값이 40개, 다른 값이 20개였고 다른 값 20개 중 15개가 색이었다. 타이포와 레이아웃 축 27개는 넷 모두 같았다. 게이트가 질감과 밝기만 쟀기 때문이다. 재지 않는 축은 같아진다. 그래서 글자 크기·여백·글자 자리·블록 수를 재는 배치 계측기를 추가해 대조를 12점으로 늘렸고, 어긋난 배치 축 6개를 0개로 줄였다.
이 데이터가 정해 주지 않는 것도 적어 두었다. 강조 색은 5군 모두 최다색과 최고채도색이 무채색이라 정할 근거가 없다. 업종별 스타일 추천도 마찬가지다. 121곳이 전부 AI·마케팅 한 주제라 "치과에는 이 스타일" 같은 규칙을 만들 수 없다. 자사 카드뉴스나 홈페이지 디자인을 수치 기준으로 다시 잡고 싶다면 상담에서 이야기를 나눌 수 있다.