증상: 같은 계정의 표본이 하루에 두 번 커졌다
표본 크기가 작을 때 나온 결론은 표본이 커지면 뒤집힐 수 있고, 우리 분석에서는 실제로 뒤집혔다. 2026년 8월 16일 하루 동안 비교 계정 @choi.openai의 분석 대상 글은 41건에서 253건으로, 다시 1,669건으로 두 번 커졌다. 마지막 재수집에서 확보한 글은 1,902건이고, 기간은 2025년 1월 13일부터 2026년 8월 16일까지였다.
이 숫자가 문제인 이유는 각 단계마다 우리가 "이게 전부"라고 믿고 결론을 냈기 때문이다. 41건일 때도, 253건일 때도 표본을 전수로 취급했다. 그 결론들은 자사 계정의 글쓰기 규칙에 그대로 들어가 있었다. 표본이 바뀌면 규칙의 근거가 바뀐다.
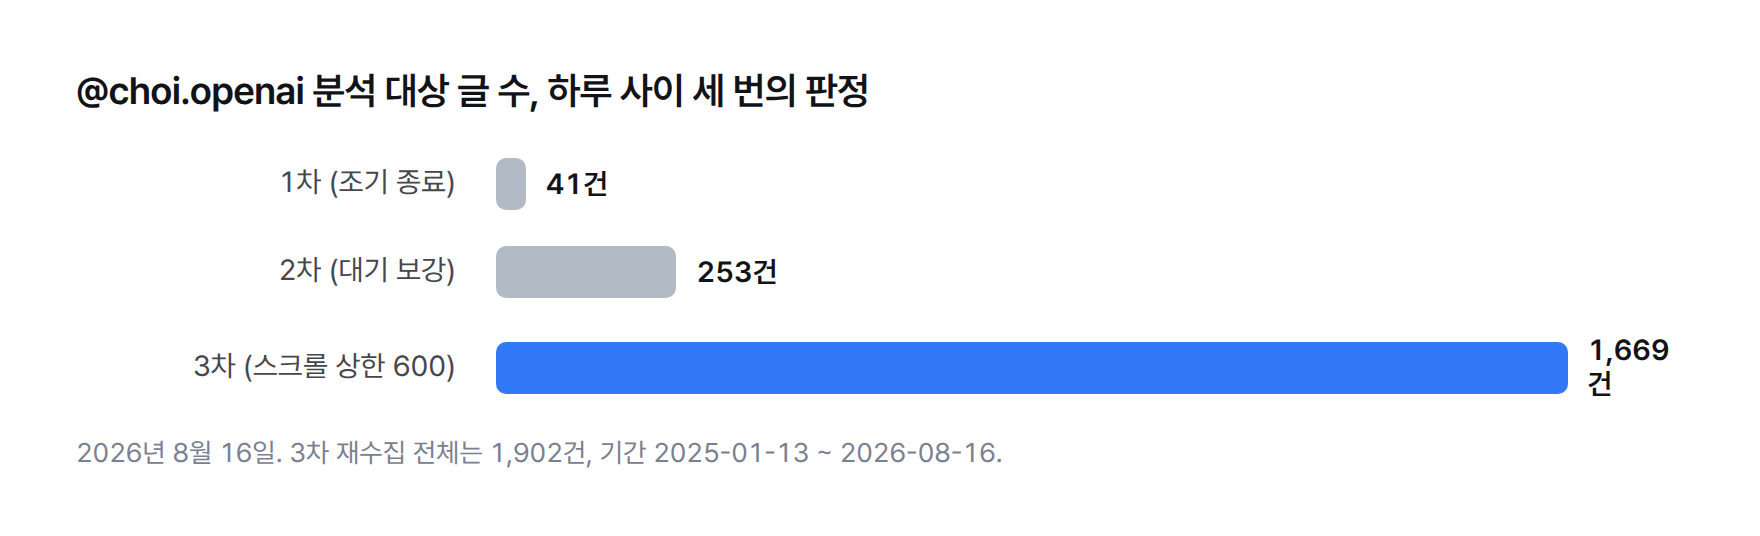
이 글은 그 과정에서 어떤 가설이 틀렸고, 무엇으로 확인했고, 결국 무엇을 코드로 옮겼는지를 순서대로 적는다. 정답을 처음부터 알았던 것이 아니라, 같은 실수를 연속 두 번 한 뒤에야 판정 방식을 바꿨다.
처음엔 무엇을 의심했나?
첫 번째 단계는 41건이었다. 수집기가 24건에서 멈추면서 "종료: 바닥 도달"이라는 사유를 찍었고, 우리는 그 문장을 믿었다. 이 단계의 실수와 수리 과정은 무한 스크롤 크롤링 종료 로그 글에 따로 정리했다. 핵심만 옮기면, 스크롤을 멈추는 판정이 1.8초 간격 4회(합계 7.2초) 정체로 너무 성급했고, 대기 횟수를 4에서 6으로 늘리고 끊기 직전에 8초를 더 기다리게 고치자 69스크롤 만에 253건이 나왔다.
두 번째 단계가 이 글의 본론이다. 253건을 받아 날짜를 펼쳐 보니 2026년 8월 7일부터 글이 촘촘했고 그 이전은 한 달에 1건꼴로 듬성듬성했다. 우리는 이것을 활동 패턴으로 읽었다. 가설은 이랬다.
8월 7일부터 운영을 시작한 신생 계정이다. 그 이전 글이 적은 것은 원래 적게 썼기 때문이다.
이 가설이 맞으면 253건은 전수이고, 그 위에서 낸 결론도 유효하다. 당시 리포트의 두 번째 큰 제목은 "질문으로 시작하면 진다"였다. 훅이 질문형인 글은 좋아요가 낮다는 결론이었고, 자사 글쓰기 규칙의 마무리 조항도 이 결론을 근거로 삼고 있었다.
신생 계정 가설은 무엇으로 확인했나?
확인에 쓴 수단은 세 가지였다. 셋 다 새로 만든 도구가 아니라 이미 손에 있던 기록이다.
- 수집기 종료 사유 로그 — 수집이 왜 멈췄는지를 수집기가 직접 남긴 한 줄. "바닥 도달"인지 "스크롤 상한 도달"인지가 갈린다
- 날짜 분포 — 글이 언제 몇 건씩 있는지를 월별로 펼친 표. 전반부와 후반부의 밀도 차이가 보인다
- 같은 계정의 다른 탭 — 같은 실행에서 함께 긁은 답글 탭의 날짜 범위. 스레드 탭과 비교할 수 있다
답글 탭 기록은 이미 데이터 안에 있었다. 같은 실행에서 @choi.openai의 답글 탭은 6월 10일부터 8월 15일까지 67일치 307건이 정상으로 들어와 있었다. 답글을 두 달 넘게 촘촘히 단 사람이 원글은 8월 7일에야 쓰기 시작했다는 그림은 어색하다. 그 어색함을 그날은 보지 않았다.
알리바이: 왜 신생 계정이 아니었나
가설을 무너뜨린 것은 운영자의 한마디였다. "팔로우한 지 수개월 이상 됐는데." 계정이 8월 7일에 태어났다면 수개월 전부터 팔로우할 수는 없다. 신생 계정 가설은 여기서 기각했다.
그다음 수집기 설정을 다시 봤다. 이번에는 스크롤을 일찍 멈춘 것이 아니라, 스크롤 횟수 상한에 닿아 멈춘 것이었다. 상한을 600으로 올려 다시 돌리자 1,902건, 2025년 1월 13일부터의 글이 나왔다. 8월만 조밀하고 그 앞이 듬성했던 것은 활동 패턴이 아니라 수집기가 앞쪽까지 내려가지 못했다는 증거였다.
정리하면 이렇다. 첫 단계는 "바닥 도달"이라는 수집기의 주장을 관측으로 착각했고, 두 번째 단계는 덜 긁힌 날짜 분포를 계정의 성격으로 착각했다. 형태는 달라도 같은 실수, 불완전한 표본을 전수로 단정한 실수다. 그것을 연속 두 번 했다.
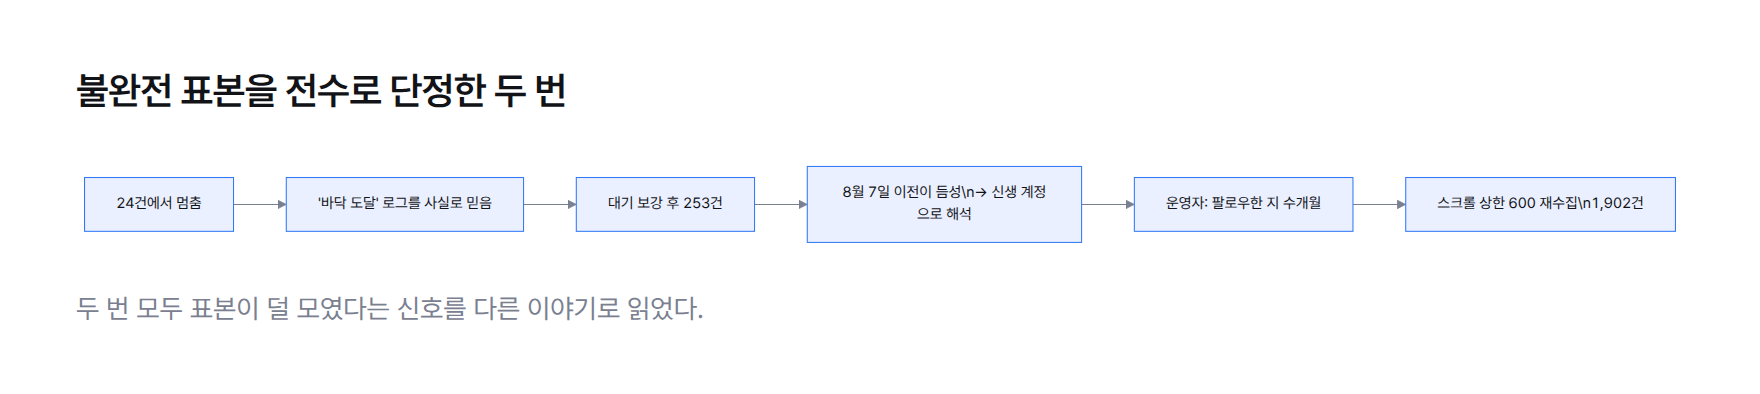
표본이 커지자 어떤 결론이 무너졌나?
1,902건을 놓고 리포트를 다시 분해하자 "질문으로 시작하면 진다"는 결론이 버티지 못했다. 그 결론이 기대고 있던 질문형 글은 @joshproductletter(이하 josh)에서 6건, @choi.openai(이하 choi)에서 4건뿐이었다. 그리고 두 계정의 질문형 좋아요 중앙값은 31과 186으로, 방향까지 정반대였다.
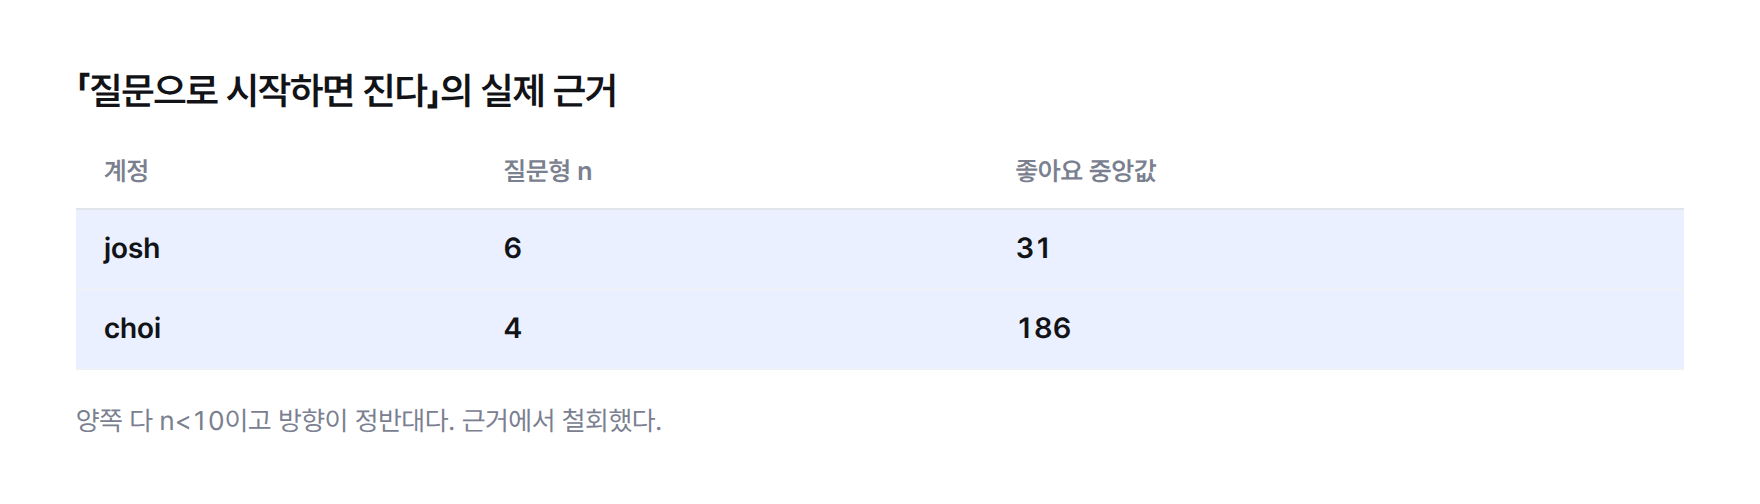
양쪽 다 표본 크기가 10에 못 미치고, 한 계정에서는 질문형이 바닥이고 다른 계정에서는 꼭대기다. 이것으로는 아무 말도 할 수 없다. 자사 글쓰기 규칙에서 마무리 조항의 근거 주석을 철회했다.
이 결론이 처음 나온 시점의 숫자도 같이 남긴다. 처음 분해한 표본은 두 계정 합계 384건(josh 341건, choi 43건)이었고, 그때 josh 체인 머리 255건 안에서 질문형 중앙값은 31로 유형 가운데 최하위, 감정선언은 109였다. 숫자 자체는 맞았다. 틀린 것은 그 칸에 몇 건이 들어 있었는지를 같이 보지 않은 판단이었다.
표본이 받쳐 준 결론은 무엇이었나?
무너진 결론만 있었던 것은 아니다. 표본이 커지자 오히려 더 두꺼워진 결론이 하나 나왔다. 훅 유형별 좋아요 중앙값 순위가 두 계정에서 그대로 일치했다.
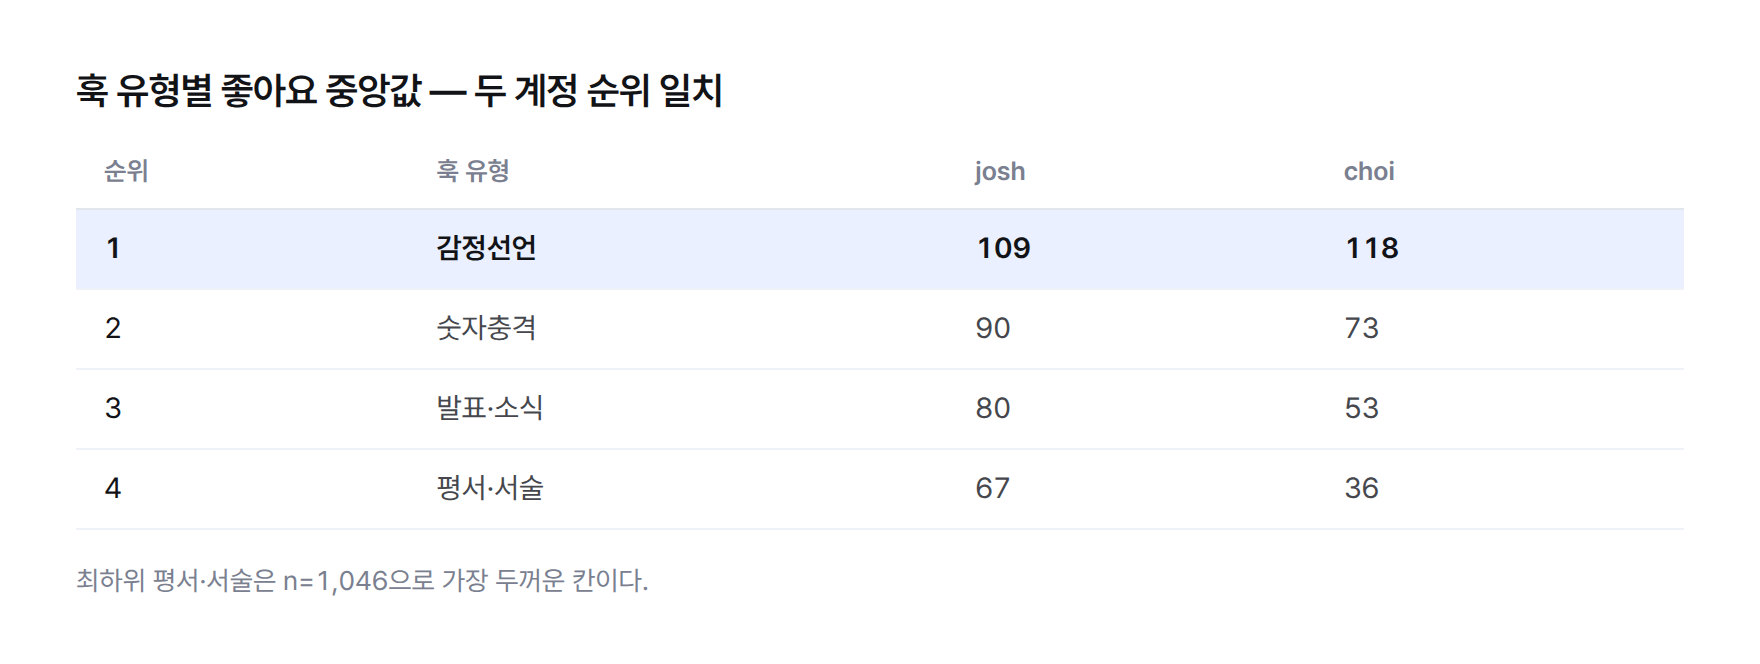
감정선언이 109와 118로 1위, 숫자충격이 90과 73, 발표·소식이 80과 53, 평서·서술이 67과 36으로 꼴찌다. 운영 기간도, 발행량도, 문체도 다른 두 계정이 같은 순서를 냈다는 점이 중요하다. 게다가 꼴찌인 평서·서술은 n=1,046으로 가장 두꺼운 칸이다. 6건짜리 칸과는 무게가 다르다.
그래서 마무리 조항의 근거를 바꿨다. "질문이 진다"가 아니라 "밋밋하게 시작해 밋밋하게 끝나는 글이 진다"다. 같은 데이터로 더 넓은 범위를 다룬 분석은 스레드 바이럴 유형 실측에 정리했다.
두 계정을 어떻게 공정하게 다시 비교했나?
표본을 다시 모으자 전체 기간 비교가 불공정하다는 사실도 드러났다. 두 계정의 운영 기간이 다르니 전체를 놓고 비교하면 기간 차이가 성과 차이처럼 보인다. 그래서 두 계정이 모두 활동한 2026년 5월 1일부터 8월 15일까지만 잘라 다시 쟀다.
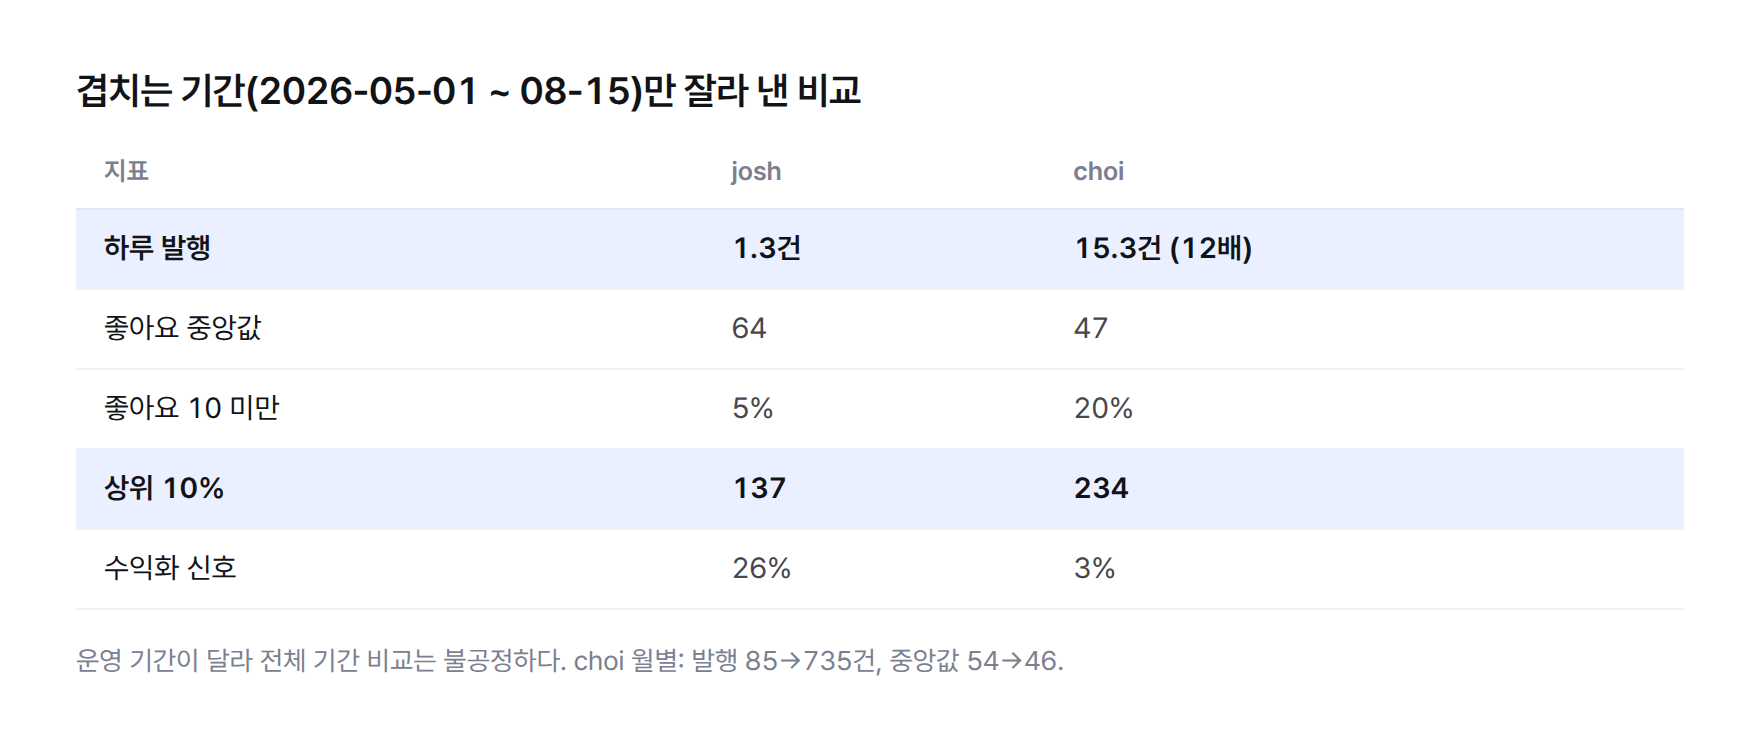
choi는 하루 15.3건으로 josh의 1.3건보다 12배 많이 올린다. 좋아요 중앙값은 josh 64, choi 47로 josh가 높고, 좋아요 10 미만 비율도 josh 5%, choi 20%다. 반면 상위 10% 지점은 choi가 234로 josh의 137보다 높다. 수익화 신호가 있는 글은 josh 26%, choi 3%였다.
"저빈도·고타율 대 고빈도·복권형"이라는 방향 판정은 표본이 커져도 살아남았다. choi의 월별 기록에서는 물량과 타율을 맞바꾸는 모습도 보였다. 발행이 85건에서 735건으로 6배 늘 때 중앙값은 54에서 46으로 완만하게 내려갔다. 글 하나의 타율은 조금 잃고 전체 도달은 크게 얻는 구조다.
우리 소재는 실제 작업 로그라서 양이 한정돼 있고 그 물량을 흉내 낼 수 없다. 그래서 자사 계정의 자리를 "빈도는 josh형, 문법은 choi형"으로 정했다.
진짜 원인은 무엇이었나?
원인은 두 층이다. 기술 층에서는 수집기의 스크롤 상한이 계정 전체를 덮기에 모자랐다. 판단 층에서는 표본이 전수인지 아닌지를 사람이 눈으로 판정했고, 그 눈이 두 번 연속 틀렸다.
둘 중 더 무거운 쪽은 판단 층이다. 스크롤 상한은 숫자 하나를 바꾸면 끝나지만, 덜 모인 표본을 전수로 읽는 습관은 다음 계정에서도 똑같이 나온다. 수집기는 종료 사유를 매번 로그에 남기고 있었다. "스크롤 상한 도달"로 끝났다면 그 표본은 전수가 아니다. 우리는 그 줄을 읽지 않았다.
작업 중 사고가 하나 더 있었다. 분해 결과 파일을 쓸 때 기존 내용을 통째로 덮어쓰는 방식(w 모드)이었다. 그래서 choi 하나만 다시 분해하면 josh 분해분 341건이 사라졌고, 같은 날 두 번 잃었다. 표본을 늘리는 도중에 다른 표본이 조용히 줄고 있었던 셈이다.
세 가지 모두 결과 숫자만 보면 드러나지 않는다. 41건짜리 표도, 253건짜리 표도, josh가 빠진 표도 겉으로는 멀쩡한 표였다. 표본이 몇 건이고 어디까지 덮였는지를 숫자와 같은 자리에 두지 않으면, 덜 모인 데이터는 언제나 완성된 데이터처럼 보인다.
고친 방법: 눈으로 하던 판정을 코드로
세 군데를 고쳤다.
- 분해기에 표본 완전성 검사 신설 — 날짜 범위 대비 활동일 비율이 50% 미만이거나, 전반부 글 수가 후반부의 1/5 미만이면 분해할 때마다 ⚠ 경고를 띄운다
- 분해 결과 파일 쓰기를 통째 덮어쓰기에서 계정 단위 병합으로 교체 — 한 계정만 다시 분해해도 다른 계정 분해분이 남는다
- 수집기 스크롤 상한 기본값은 그대로 두고, 전수가 필요한 이번 수집만 600으로 실행 — 대신 종료 사유가 "스크롤 상한 도달"이면 전수가 아니라고 읽는다
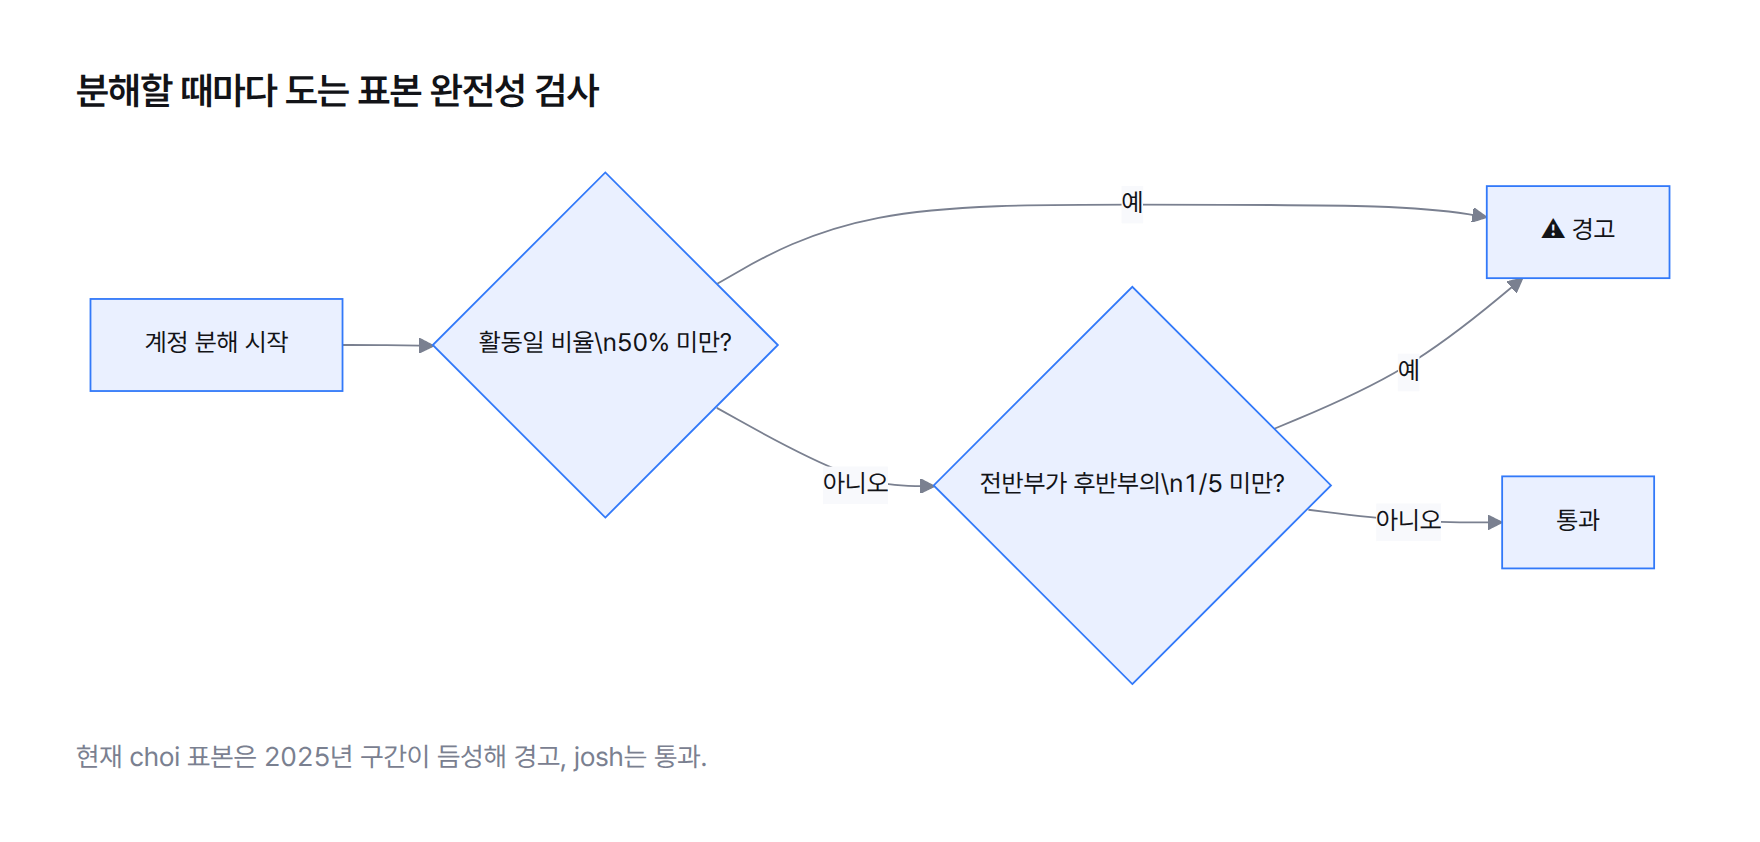
검사를 켜자 현재 choi 표본에도 여전히 경고가 떴다. 2025년 구간이 듬성하기 때문이다. josh는 통과했다. 1,902건을 모은 지금도 choi 표본은 완전하다고 말할 수 없고, 검사기는 그 사실을 분해할 때마다 다시 알려 준다. 사람이 기억해야 하는 일을 기계가 매번 상기시키게 바꾼 것이 이번 수리의 핵심이다.
같은 실수를 어떻게 막고 있나?
마지막 장치는 표기 규칙이다. 결론 옆에 표본 수 n을 항상 같이 적는다. 리포트 표에서 n<10인 행에는 ⚠를 달고 근거에서 뺀다. 숫자 하나만 크게 써 두면 그것이 4건에서 나온 숫자인지 838건에서 나온 숫자인지 읽는 사람은 알 수 없다.
| 확인 항목 | 방법 | 걸리면 무엇을 하나 |
|---|---|---|
| 수집이 왜 끝났나 | 수집기 종료 사유 로그를 읽는다 | "상한 도달"이면 전수가 아니다. 상한을 올려 재수집한다 |
| 날짜가 고르게 덮였나 | 활동일 비율과 전반부·후반부 밀도를 잰다 | 비율 50% 미만이거나 전반부가 1/5 미만이면 결론을 보류한다 |
| 결론이 몇 건에서 나왔나 | 표의 모든 칸에 n을 붙인다 | n<10인 칸은 ⚠ 표시 후 근거에서 뺀다 |
| 다른 경로와 맞나 | 같은 계정의 다른 탭·같은 저장소의 다른 계정과 대조한다 | 어긋나면 표본부터 의심한다 |
표본 크기는 통계 책의 이야기처럼 들리지만, 실제로 결론을 뒤집은 것은 거창한 검정이 아니라 "이 칸에 몇 건이 들어 있나"를 묻지 않은 습관이었다. 데이터로 마케팅·영업 판단을 내리는데 그 판단이 몇 건 위에 서 있는지 점검하고 싶다면 상담으로 연락할 수 있다.