크론 로그 확인은 왜 crontab -l 로 끝나지 않나?
크론 로그 확인을 하려는 사람이 가장 먼저 여는 화면은 보통 crontab -l 입니다. 이 명령은 등록한 작업 목록과 실행 주기를 보여 줍니다. 그런데 이 목록은 "이 시각에 이 스크립트를 실행하라"는 예약일 뿐이고, 실제로 실행했다는 증거가 아닙니다.
저희는 2026년 10월 14일에 이 차이를 숫자로 확인했습니다. 등록한 크론은 168개였고, 그중 사람이 하던 일을 대신하는 작업 70개의 최근 30일 기록을 셌습니다. 실행 흔적이 0회인 작업이 17개, 로그 형식이 서로 달라 횟수를 셀 수조차 없는 작업이 17개였습니다. 등록 목록만 봤다면 이 두 묶음 모두 정상으로 보였을 겁니다.
그래서 이 계측은 crontab -l 이 아니라 로그와 기록 파일에 남은 실행 흔적을 셉니다. 다만 이 글에서 다루려는 건 그다음 이야기입니다. 흔적을 세는 방식으로 바꿨다고 숫자가 곧바로 믿을 만해지지는 않았습니다. 실행 0회라는 같은 숫자가 작업마다 다른 뜻을 품고 있었습니다.
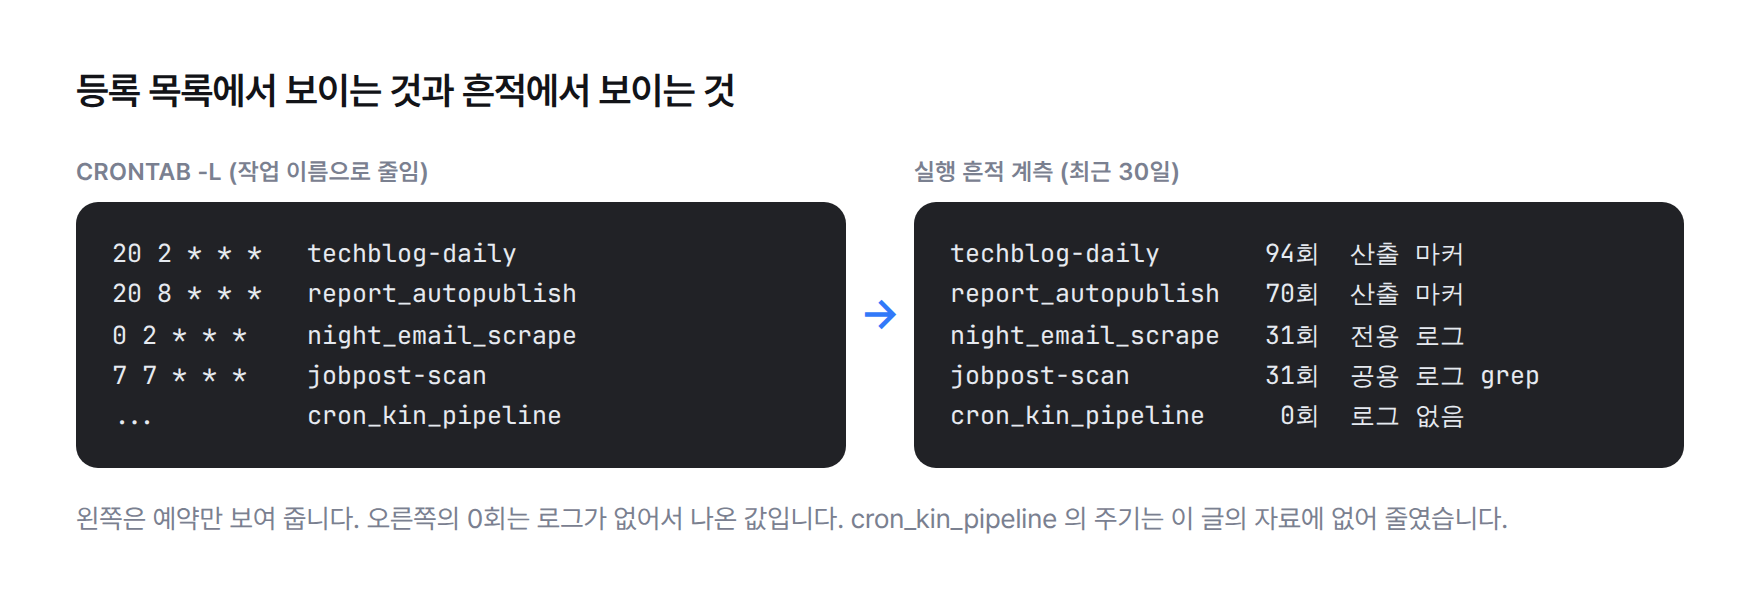
같은 계측을 처음 설계하던 무렵의 이야기는 크론 실행 확인을 로그 흔적으로 바꾼 글에 따로 적었습니다. 여기서는 숫자를 다시 읽으면서 드러난 세 가지 함정을 다룹니다.
등록된 168개를 왜 성격 넷으로 나눴나?
처음부터 70개만 센 데에는 이유가 있습니다. 등록 크론 168개를 통째로 "168개를 자동화했다"고 쓰면 숫자가 부풀고, 누가 한 번만 되물어도 무너집니다. 크론마다 하는 일의 성격이 다르기 때문입니다.
- 업무대체 70개: 사람이 하던 일을 대신합니다. 사람이 하면 몇 분 걸리는지라는 기준선을 붙일 수 있는 유일한 성격입니다.
- 감시 45개: 사람이 원래 하지 않던 일입니다. 기준선이 맞지 않아 사고를 일찍 발견한 건수로 따로 셉니다.
- 보고 35개: 손을 덜어 주기보다 판단을 앞당깁니다. 기준선이 애매해 분류만 해 두었습니다.
- 위생 17개: 인프라 자체를 유지하는 작업이라 업무에서 뺐습니다.
- 미분류 1개: 아직 판정하지 않았습니다.
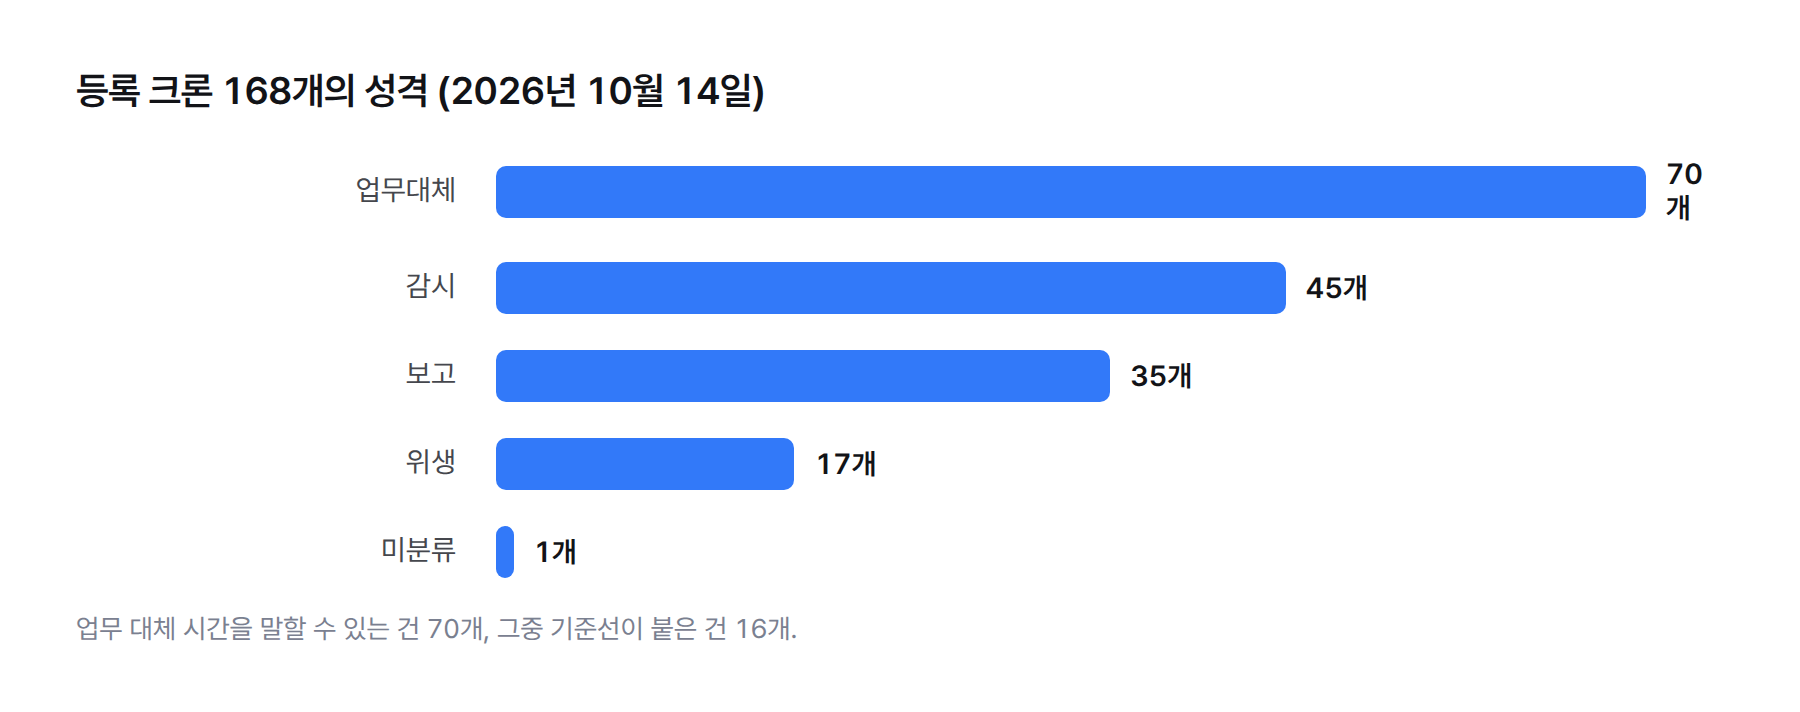
업무 대체 시간을 말할 자격이 있는 작업은 70개뿐이고, 그중 기준선까지 붙은 작업은 16개입니다. 실행 흔적을 세는 일도 이 70개에서 시작했습니다. 아낀 시간은 실행 횟수에 건당 시간을 곱해 나오므로, 실행 횟수가 틀리면 그 위의 계산이 전부 틀리기 때문입니다.
실행 흔적은 무엇으로 세나?
크론은 실행하고 나서 스스로 "나 돌았다"고 어디에 적지 않습니다. 실행 기록을 남기는 방식은 스크립트를 만든 시점과 만든 사람의 습관에 따라 제각각입니다. 그래서 계측기는 작업마다 셈법을 하나씩 정해 두고 그 방식으로 셉니다. 실제로 쓰는 셈법은 세 가지입니다.
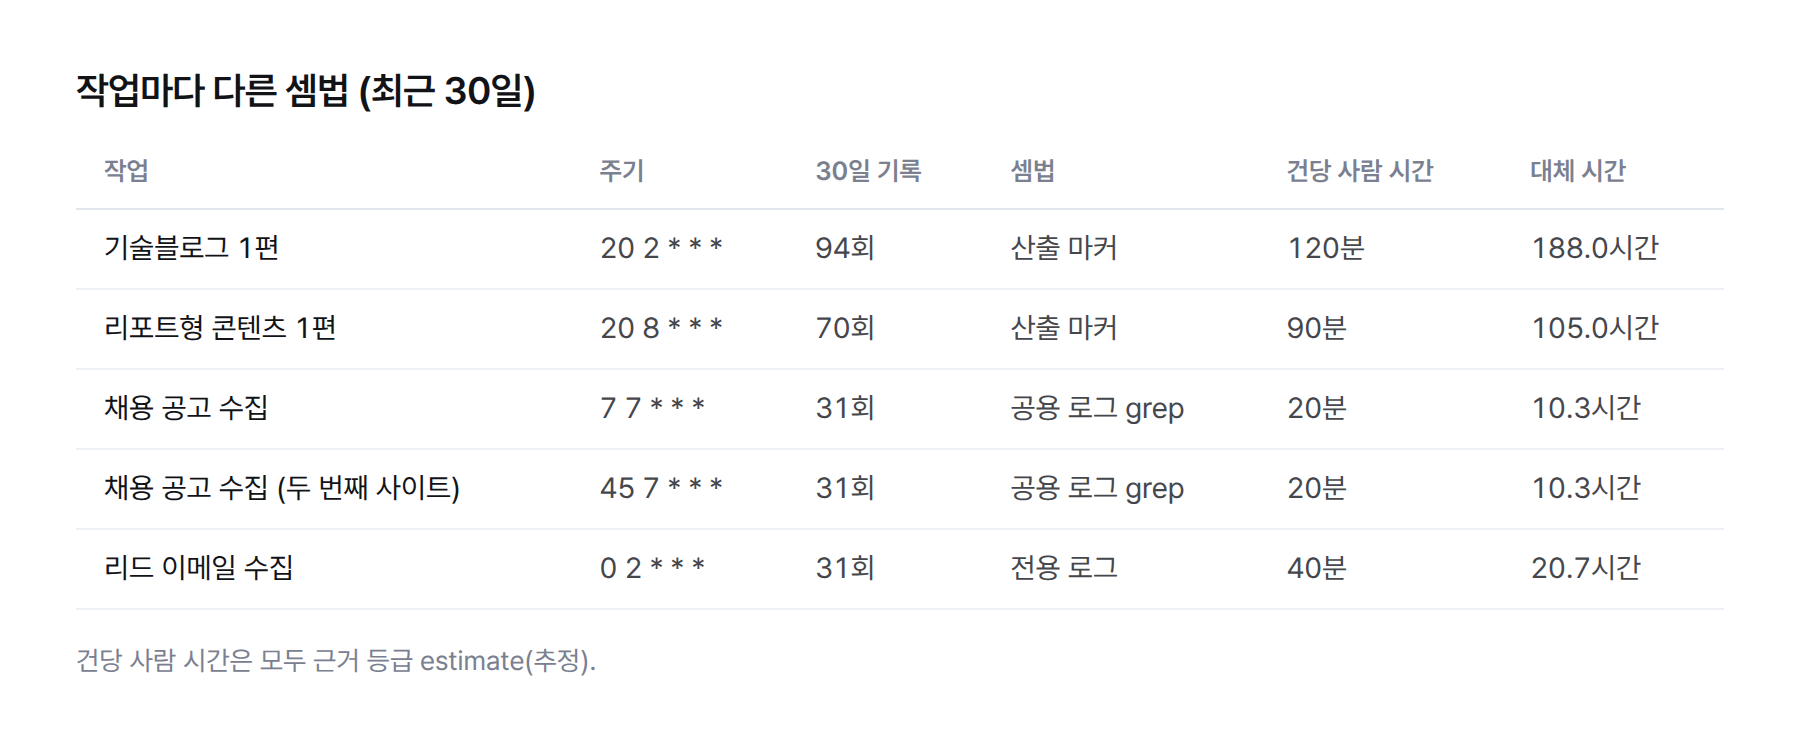
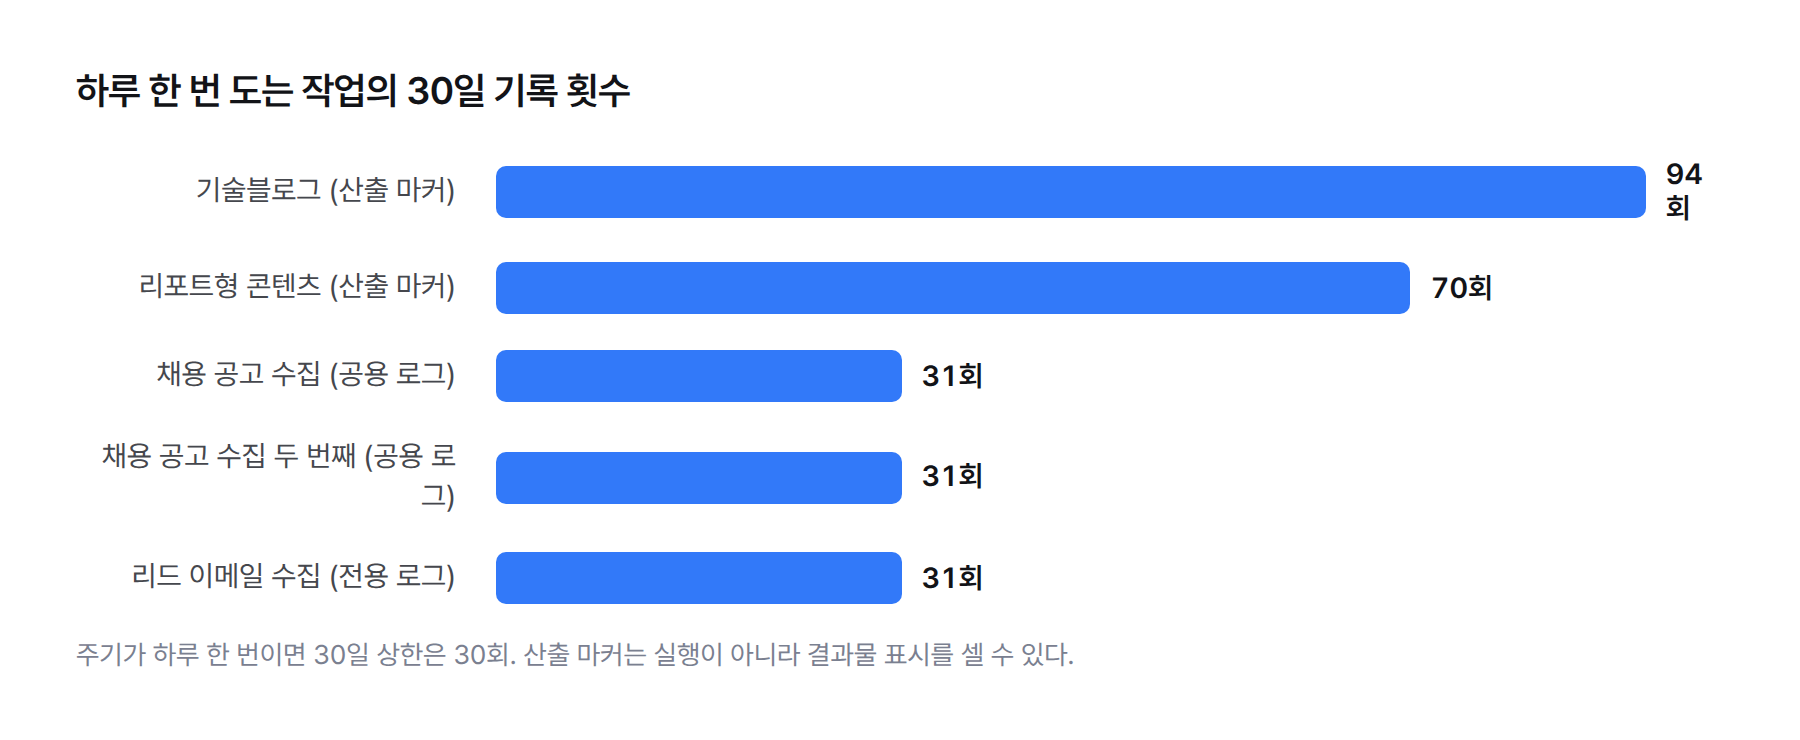
- 전용 로그: 그 작업만 쓰는 로그 파일에서 실행 줄을 셉니다. 리드 이메일 수집 작업이 이 방식으로 31회를 기록했습니다.
- 공용 로그 grep: 여러 작업이 함께 쓰는 로그에서 작업 이름으로 찾아 셉니다. 채용 사이트 공고 수집 두 작업이 각각 31회였습니다.
- 산출 마커: 실행 결과물에 남는 표시를 셉니다. 기술블로그 작업이 94회, 리포트형 콘텐츠 작업이 70회였습니다.
셈법이 셋으로 갈리면 같은 "30일 실행 횟수" 칸에 서로 다른 단위의 숫자가 들어갑니다. 이 점은 뒤에서 숫자가 커지는 쪽의 함정으로 다시 나옵니다. 먼저 숫자가 0으로 나온 쪽부터 보겠습니다.
실행 0회 17개는 정말 안 돌았나?
처음 이 숫자를 봤을 때 저희가 세운 가정은 단순했습니다. 실행 0회라면 그 작업은 지난 30일 동안 한 번도 돌지 않았고, 크론 등록이 깨졌거나 스크립트가 시작하자마자 죽고 있다는 뜻이라고 읽었습니다. 고칠 목록이 17줄 생겼다고 생각했습니다.
그런데 0회로 잡힌 작업 가운데 이름과 기록 위치가 함께 남은 10개를 펼쳐 보니 이야기가 달랐습니다.
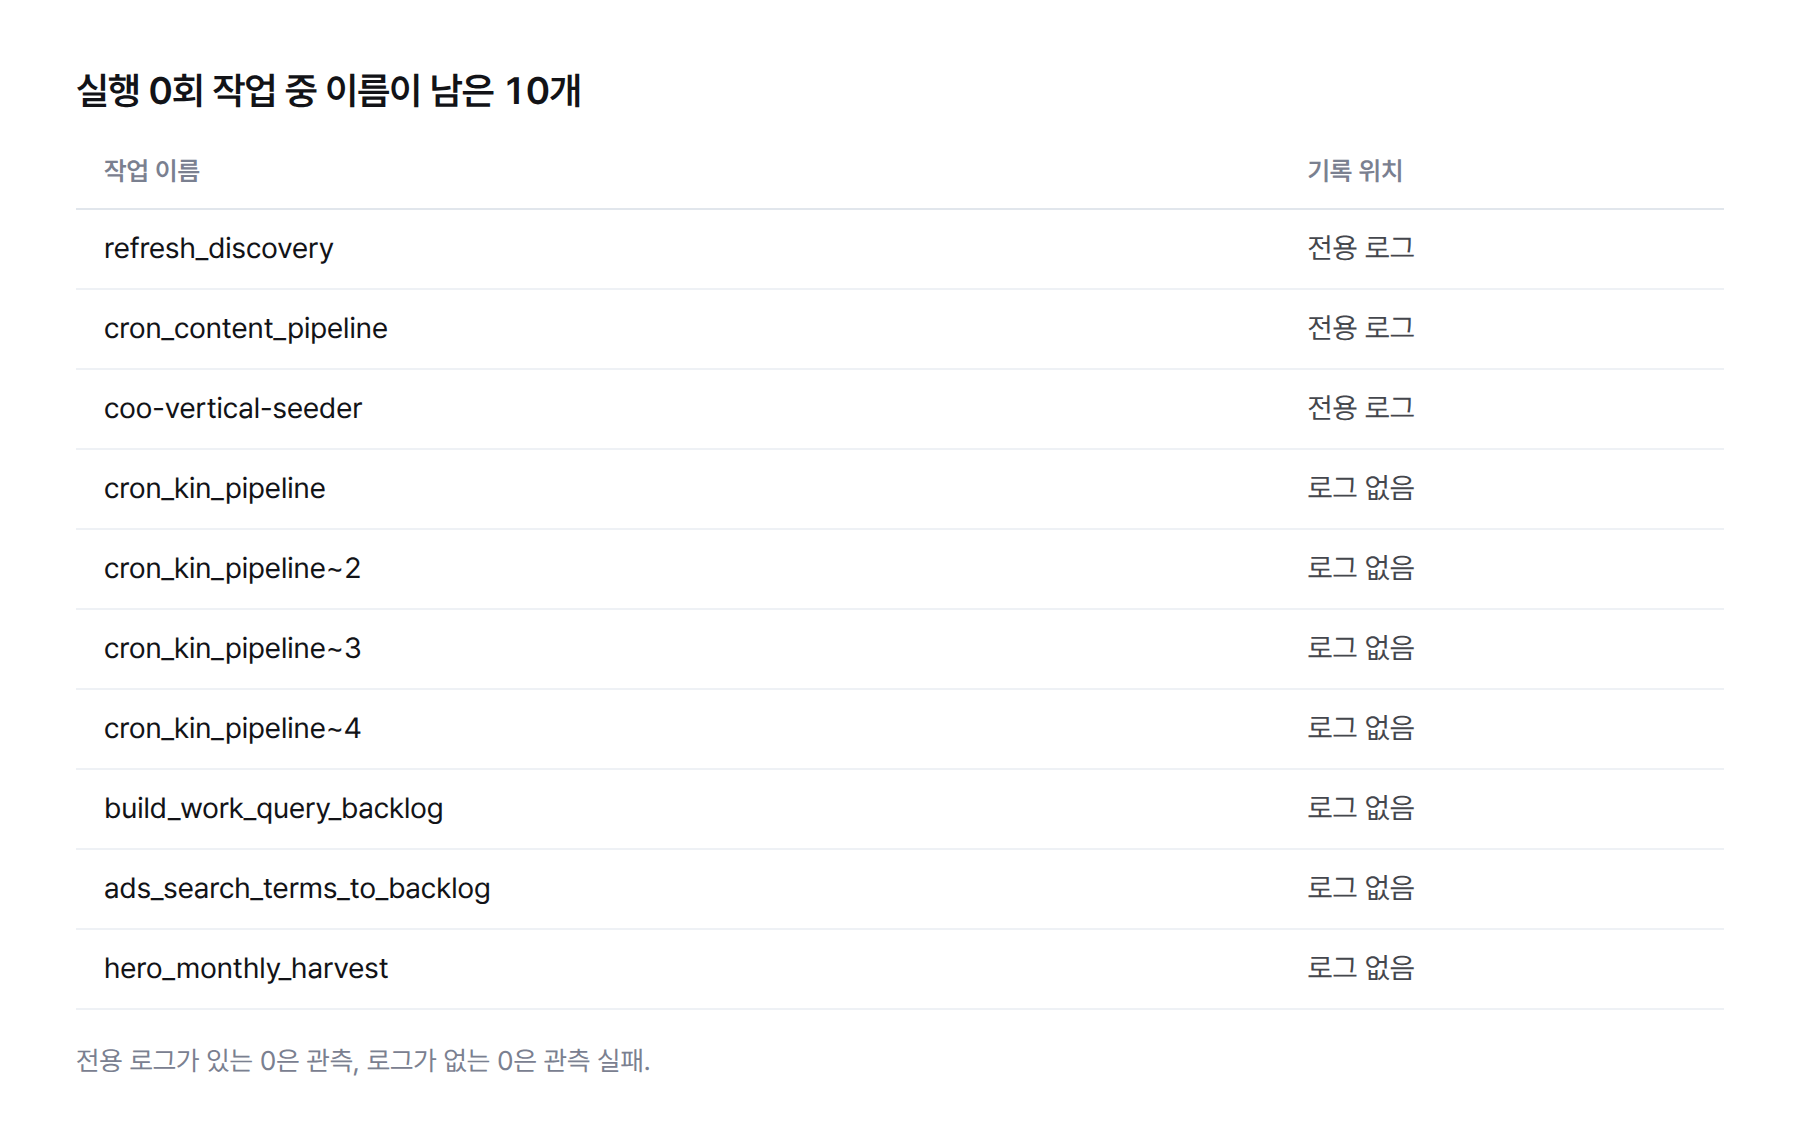
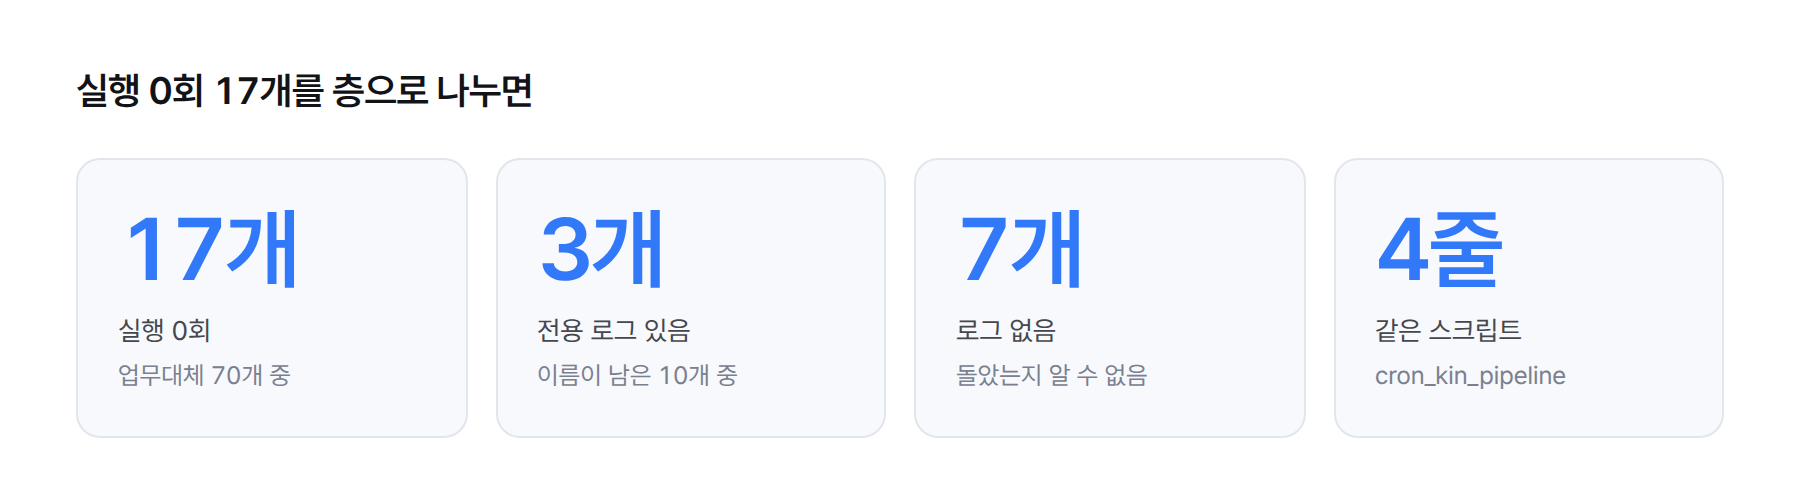
10개 중 3개는 전용 로그가 있었습니다. 로그 파일이 있는데 최근 30일 실행 줄이 0개라면, 그 작업이 실제로 돌지 않았다고 볼 근거가 꽤 단단합니다. 이 3개는 처음 가정대로 고칠 대상입니다.
고치는 순서도 정해져 있습니다. 로그에 남은 마지막 실행 줄의 날짜를 보면 언제부터 멈췄는지 알 수 있고, 그 무렵 바뀐 스크립트나 설정을 찾으면 원인 후보가 좁혀집니다. 로그가 있다는 사실 하나로 조사의 출발점이 생깁니다.
나머지 7개는 로그가 아예 없었습니다. 로그가 없는 작업의 0회는 "돌지 않았다"가 아니라 "돌았는지 알 방법이 없다"입니다. 스크립트가 매일 정상으로 돌면서 아무 흔적도 남기지 않을 수도 있고, 정말로 한 번도 돌지 않았을 수도 있습니다. 계측기 입장에서는 두 경우가 똑같이 0으로 보입니다.
로그가 있는 0은 관측이고, 로그가 없는 0은 관측 실패다.
이 구분이 중요한 이유는 고치는 방법이 서로 다르기 때문입니다. 로그가 있는 0은 스크립트나 크론 등록을 열어 원인을 찾아야 합니다. 로그가 없는 0은 먼저 실행할 때마다 한 줄을 남기도록 만들어야 하고, 그 뒤 30일을 다시 재야 비로소 고칠지 말지를 판정할 수 있습니다. 17줄을 한 목록에 섞어 두면 이 두 일이 한 일처럼 보입니다.
같은 스크립트가 네 줄을 차지하면 17은 몇 개인가?
목록을 다시 보면 cron_kin_pipeline 이라는 이름이 네 번 나옵니다. 하나는 이름 그대로이고, 나머지 셋은 뒤에 ~2, ~3, ~4가 붙었습니다. 같은 스크립트를 하루 여러 시각에 돌리려고 크론에 네 줄로 등록했고, 계측기가 줄을 구분하려고 번호를 붙인 것으로 보입니다. 아직 crontab 원문과 한 줄씩 대조하지는 않았습니다.
이 해석이 맞다면 실행 0회 17개는 스크립트 17개가 아니라 크론 등록 17줄입니다. 그리고 그중 네 줄은 같은 스크립트가 같은 이유로 흔적을 남기지 않는 경우라, 원인은 하나일 가능성이 큽니다. 로그를 한 곳에만 추가하면 네 줄이 한꺼번에 판정 가능한 상태로 바뀝니다.
반대 방향의 위험도 있습니다. 네 줄 중 일부만 실제로 돌고 나머지는 시각 설정이 틀려 돌지 않는 경우라면, 로그가 없는 지금은 그 차이를 전혀 볼 수 없습니다. 같은 이름을 하나로 합쳐 세면 이 경우를 놓치고, 따로 세면 같은 원인을 네 번 셉니다. 그래서 저희는 지금 상태를 "0회 17줄, 그중 로그 없는 줄 7개, 그중 같은 스크립트 4줄"처럼 층을 나눠 적는 쪽을 택했습니다.
반대로, 숫자가 실제보다 크게 나오는 경우는 무엇인가?
0만 의심하면 절반만 본 셈입니다. 흔적을 세는 방식은 숫자를 실제보다 크게 만들기도 합니다. 셈법표를 다시 보면 기술블로그 작업의 실행 주기는 20 2 * * *, 하루 한 번 새벽 2시 20분입니다. 30일이면 많아야 30번 돌 수 있는데, 기록은 94회입니다.
리포트형 콘텐츠 작업도 같습니다. 주기는 20 8 * * *, 하루 한 번인데 기록은 70회입니다. 두 작업 모두 셈법이 산출 마커라는 공통점이 있습니다. 실행 한 번에 글이 여러 편 나오거나, 같은 결과물에 표시가 여러 번 찍히면 실행 횟수가 아니라 표시 개수를 세게 됩니다. 어느 쪽인지는 아직 확인하지 않았습니다.
이 차이가 아낀 시간 계산에 주는 영향은 단위에 달려 있습니다. 기술블로그 작업의 건당 시간 120분은 1편 기준입니다. 6,600자 이상 글 1편을 손으로 쓰는 데 60~90분, 검수와 발행에 30분을 잡았고, 라이브에 올라간 9편의 실제 분량에서 거꾸로 계산했습니다. 그렇다면 94를 실행 횟수가 아니라 글 편수로 읽어야 94회 × 120분 = 188.0시간이 맞는 계산이 됩니다. 칸 이름은 "실행"인데 안에 든 값은 "산출"인 셈입니다.
다른 작업의 건당 시간도 같은 방식으로 단위를 확인해야 합니다. 리포트형 콘텐츠의 90분은 같은 형식의 리포트 1편을 손으로 쓰는 60분에 검수·발행 30분을 더한 값이고, 역시 1편 기준입니다. 채용 공고 수집의 20분은 검색과 목록 훑기 12분, 상위 공고 열람과 기록 8분을 더한 1회 기준이고, 리드 이메일 수집의 40분은 대상 사이트 순회 30분과 정리 10분을 더한 1회 기준입니다. 1회 기준인 작업은 셈법도 실행을 세는 로그 방식이라 단위가 맞습니다. 단위가 어긋날 수 있는 곳은 산출 마커로 센 두 작업뿐입니다.
공용 로그 grep 쪽에도 작은 어긋남이 있습니다. 채용 공고 수집 두 작업은 각각 7 7 * * *, 45 7 * * * 주기로 하루 한 번 돌고, 30일 기록이 31회입니다. 하루 한 번이면 30을 넘을 수 없으니 한 번이 더 있습니다. 수동으로 한 번 더 돌렸거나 집계 창의 경계에 하루가 더 걸렸을 수 있는데, 이것도 원인을 확인하지 않았습니다.
정리하면 "흔적만 세면 정확하다"는 가정도 틀렸습니다. 셈법이 작업마다 다르면 같은 칸의 숫자가 서로 다른 것을 셉니다. 0은 관측 실패를 숨기고, 큰 숫자는 단위 차이를 숨깁니다. 등록 목록을 의심해서 흔적으로 옮겨 왔는데, 흔적도 똑같이 의심해야 했습니다.
이 계측에서 지키기로 한 원칙
숫자 하나하나의 원인을 다 밝히기 전에, 숫자를 읽는 방식부터 정했습니다. 저희 쪽 화면 검수 규칙에 "통과는 검사한 것 중 걸린 게 없다는 뜻일 뿐이다"라는 문장이 있습니다. 실행 흔적 계측에도 같은 원리를 적용했습니다. 0회는 "찾은 흔적이 없다"는 뜻일 뿐입니다.
- 실행 0회는 기록 위치와 함께 적습니다. 전용 로그가 있는 0과 로그가 없는 0을 한 목록에 섞지 않습니다.
- 로그가 없는 작업은 고치기 전에 먼저 실행할 때마다 한 줄을 남기게 하고, 30일을 다시 잽니다.
- 같은 스크립트가 여러 줄로 등록된 경우 줄 수와 스크립트 수를 둘 다 적습니다.
- 실행 주기로 계산한 상한을 넘는 횟수는 셈법과 단위를 다시 확인할 대상으로 표시합니다.
- 아낀 시간 계산은 건당 시간의 단위(1회인지 1편인지)와 횟수의 단위가 같을 때만 곱합니다.
이 원칙은 자동화 성과를 밖에 말할 때도 그대로 씁니다. 등록 168개, 업무대체 70개, 기준선이 붙은 16개처럼 층을 나눠 말하면 숫자는 작아지지만 되물어도 무너지지 않습니다. 지금 기준선이 붙은 작업도 근거 등급은 모두 estimate, 즉 사람이 직접 재지 않고 작업 구성으로 추정한 값입니다.
아직 못 푼 것은 무엇인가?
가장 큰 미해결은 로그가 없는 7개입니다. 이 작업들이 실제로 돌고 있는지 아직 모릅니다. 실행마다 한 줄을 남기게 만든 뒤 30일을 다시 재야 판정할 수 있고, 그 전까지 이 7개의 0은 고칠 목록이 아니라 확인할 목록입니다.
두 번째는 이름이 남지 않은 나머지 7개입니다. 실행 0회 17개 중 이번에 기록 위치까지 펼쳐 본 작업은 10개뿐이라, 남은 작업이 어느 쪽 0인지는 같은 방식으로 다시 열어 봐야 합니다. 셀 수 없는 17개도 그대로 남아 있습니다. 로그 형식을 맞추기 전까지 이 작업들은 아낀 시간 계산에서 빠집니다.
세 번째는 산출 마커로 센 94회와 70회의 정체입니다. 실행 횟수인지 결과물 개수인지 확인해서, 칸 이름과 안의 값을 맞춰야 합니다. 대체 시간 188.0시간과 105.0시간은 그 확인이 끝나야 믿을 수 있는 숫자가 됩니다.
크론으로 돌리는 반복 업무가 쌓이기 시작했다면, 등록 목록과 별도로 실행 흔적을 세는 장치를 일찍 두는 편이 쌉니다. 비슷한 업무 자동화의 실행 점검이나 성과 계산을 정리해야 한다면 상담으로 문의해 주세요.